

TL; DR: JSONB може значително да опрости разработването на схема на БД без да жертва производителността при заявките.
Въведение
Нека посочим класически пример, вероятно един от най-старите варианти на употреба в света на релационните БД (база данни): имаме същество и е необходимо да запазим определени свойства (атрибути) на това същество. Но не всички екземпляри могат да имат един и същи набор от свойства, а освен това в бъдеще може да се наложи добавянето на нови свойства.
Най-лесният начин да се реши този проблем е създаването на колона в таблицата на БД за всяка стойност на свойство и просто да се попълват тези, които са необходими за конкретния екземпляр на съществото. Чудесно! Проблемът е решен... до момента, в който вашата таблица не съдържа милиони записи и вие не се наложи да добавите нова стойност.
Нека разгледаме патерна EAV (), който се среща доста често. Една таблица съдържа съществата (записи), друга таблица съдържа имена на свойства (атрибути), а третата таблица свързва съществата с техните атрибути и съдържа стойностите на тези атрибути за текущото същество. Това ви дава възможност да имате различни набори от свойства за различни обекти, както и да добавяте свойства "на лето", без да променяте структурата на БД.
Въпреки това, не бих написал тази бележка, ако нямаше недостатъци в подхода с използването на EAV. Например, за да получите едно или повече същества, които имат 1 атрибут, са необходими 2 join-а (обединения) в заявката: първият – обединение с таблицата на атрибутите, вторият – обединение с таблицата на стойностите. Ако съществото има 2 атрибута, то вече са необходими 4 join-а! Освен това, всички атрибути обикновено се съхраняват под формата на низове, което води до преобразуване на типовете, както за резултата, така и за условията WHERE. Ако пишете много заявки, това е доста разточително от гледна точка на използването на ресурси.
Въпреки тези очевидни недостатъци, EAV отдавна се използва за решаване на подобни проблеми. Това бяха неизменни недостатъци, а по-добра алтернатива просто нямаше.
Но след това в PostgreSQL се появи нова "технология"...
С начала PostgreSQL 9.4 был добавлен тип данных JSONB для хранения двоичных данных JSON. Хотя хранение JSON в этом формате обычно занимает немного больше места и времени, чем простой текстовый JSON, выполнение операций с ним происходит значительно быстрее. Кроме того, JSONB поддерживает индексирование, что делает запросы к ним еще более быстрыми.
Тип данных JSONB позволяет заменить громоздкий паттерн EAV, добавив всего лишь один столбец JSONB в нашу таблицу сущностей, что значительно упрощает проектирование базы данных. Однако многие утверждают, что это должно сопровождаться снижением производительности… Вот почему появилась эта статья.
Настройка тестовой базы данных
Для этого сравнения я создал базу данных на новой установке PostgreSQL 9.5 на 80-долларовой сборке Ubuntu 14.04. После настройки некоторых параметров в postgresql.conf я запустил скрипт с помощью psql. Для представления данных в виде EAV были созданы следующие таблицы:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Ниже представлена таблица, где будут храниться те же данные, но с атрибутами в столбце типа JSONB – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Выглядит намного проще, не так ли? Затем в таблицы сущностей (entity & entity_jsonb) было добавлено 10 миллионов записей, и соответственно, были заполнены одинаковыми данными таблицы, где используется паттерн EAV и подход с столбцом JSONB – entity_jsonb.properties. Таким образом, мы получили несколько разных типов данных среди всего набора свойств. Пример данных:
{
  id:          1
  name:        "Entity1"
  description: "Тестовая сущность № 1"
  properties:  {
    color:        "красный"
    lenght:       120
    width:        3.1882420
    hassomething: true
    country:      "Бельгия"
  }
}
Итак, теперь у нас есть одинаковые данные для двух вариантов. Давайте начнем сравнивать реализации в работе!
Упрощение дизайна
Ранее уже говорилось, что дизайн БД был значительно упрощен: одна таблица за счет использования столбца JSONB для свойств, вместо использования трех таблиц для EAV. Но как же это отражается в запросах? Обновление одного свойства сущности выглядит следующим образом:
-- EAV
UPDATE entity_attribute_value
SET value = 'blue'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blue"')
WHERE id = 120;
Както виждаме, последната заявка не изглежда по-опростена. За да обновим стойността на свойство в обекта JSONB, трябва да използваме функцията , и трябва да предадем новата си стойност като обект JSONB. Все пак, не трябва да знаем предварително никакъв идентификатор. Гледайки примера с EAV, трябва да знаем както entity_id, така и entity_attribute_id, за да извършим обновлението. Ако искате да обновите свойство в колоната JSONB въз основа на името на обекта, това всичко се прави с една проста заявка.
Сега нека изберем тази същност, която току що обновихме, по условия на новия й цвят:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'blue';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blue';
Мисля, че можем да се съгласим, че второто е по-кратко (без join!), и съответно по-четимо. Тук JSONB печели! Използваме оператора JSON ->>, за да получим цвета като текстова стойност от обекта JSONB. Съществува също и втори начин за постигане на същия резултат в модела JSONB с използване на оператора @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blue"}';
Това е малко по-сложно: проверяваме дали обектът JSON в колоната свойства съдържа обект, който се намира вдясно от оператора @>. По-малко четимо, но по-производително (вижте по-долу).
Да опростим използването на JSONB още повече, когато трябва да изберем няколко свойства едновременно. Ето къде наистина подхожда подходът JSONB: просто избираме свойствата като допълнителни колони в набора на резултатите без необходимост от обединения:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
С EAV ще ви трябват 2 обединения за всяко свойство, което искате да запитате. Според мен, горепосочените заявки показват значително опростяване в дизайна на базата данни. Можете да видите повече примери за това как да пишете заявки към JSONB и в публикацията.
Сега е време да поговорим за производителността.
Производителност
За да сравня производителността, използвах в заявките, за изчисляване на времето за изпълнение. Всяка заявка беше изпълнена поне три пъти, тъй като при първия опит на планиращия на заявки е нужно повече време. Първо изпълних заявките без никакви индекси. Очевидно, това служеше като предимство за JSONB, тъй като join-овете, необходими за EAV, не можеха да използват индекси (полета с външни ключове не бяха индексирани). След това създадох индекс за 2 колони с външни ключове в таблицата за EAV, както и индекс за колоната JSONB.
Анализът на актуализации на данни показа следните резултати за времето (в мс). Обърнете внимание, че мащабът е логаритмичен:
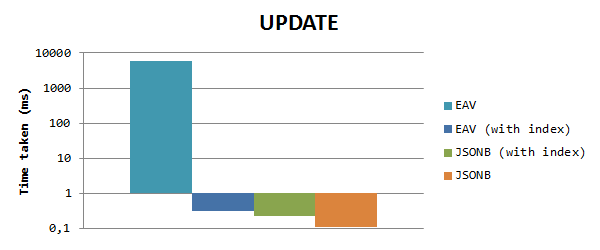
Виждаме, че JSONB е много по-бърз (> 50000 пъти) от EAV, ако не се използват индекси, поради причината, посочена по-горе. Когато индексираме колоните с основни ключове, разликата почти изчезва, но JSONB все още е 1,3 пъти по-бърз от EAV. Обърнете внимание, че индексът в колоната JSONB не оказва влияние тук, тъй като не използваме колоната на свойствата в оценъчните критерии.
За извличане на данни на базата на стойността на свойство получаваме следните резултати (нормален масштаб):
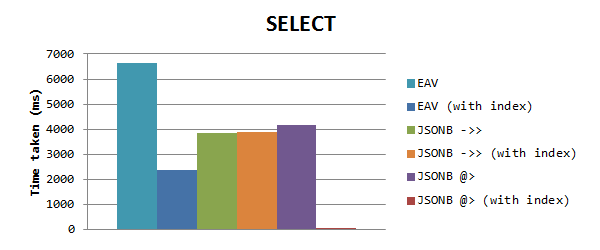
Може да се забележи, че JSONB отново работи по-бързо от EAV без индекси, но когато EAV има индекси – той все пак работи по-бързо от JSONB. Но после видях, че времето за заявките на JSONB беше идентично, което ме накара да се замисля, че индексът GIN не сработва. Очевидно, когато използвате индекс GIN за колона със запълнени свойства, той действа само при използване на оператора за включване @>. Използвах това в нов тест, което оказа огромно влияние върху времето: само 0,153 мс! Това е 15000 пъти по-бързо от EAV и 25000 пъти по-бързо от оператора ->>
Мисля, че беше достатъчно бързо!
Размери на базите данни
Нека да сравним размерите на таблиците при двата подхода. В psql можем да покажем размерите на всички таблици и индекси с помощта на командата dti+
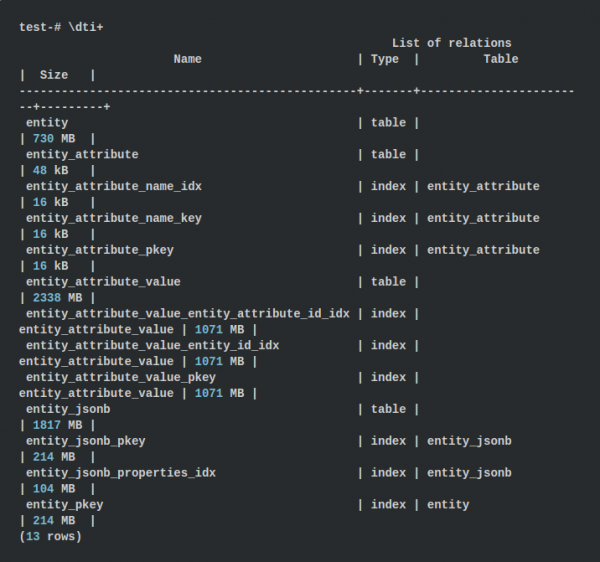
За подхода EAV размерите на таблиците са около 3068 МБ, а индекси – до 3427 МБ, което в общо дава 6,43 ГБ. При използване на подхода с JSONB се използват 1817 МБ за таблицата и 318 МБ за индексите, което прави 2,08 ГБ. Получава се три пъти по-малко! Този факт ме изненада малко, тъй като съхраняваме имената на свойствата във всеки обект JSONB.
Но все пак числата говорят сами за себе: в EAV съхраняваме 2 целочислени външни ключа на стойност на атрибут, в резултат на което получаваме 8 байта допълнителни данни. Освен това, в EAV всички стойности на свойствата се съхраняват под формата на текст, докато JSONB ще използва числови и логически стойности там, където е възможно, в резултат на което получаваме по-малък обем.
Итог
Като цяло, мисля, че съхраняването на свойствата на сущностите във формат JSONB може значително да опрости проектирането и поддръжката на вашата база данни. Ако изпълнявате много запитвания, всичко, което е съхранено в една таблица с сущността, наистина ще работи по-ефективно. И фактът, че това опростява взаимодействието между данните, вече е плюс, но и получената БД е 3 пъти по-малка по обем.
Също така, от направените тестове, може да се направи заключение, че загубите в производителността са много незначителни. В някои случаи JSONB дори работи по-бързо от EAV, което го прави още по-добър. Въпреки това, този еталонен тест, разбира се, не обхваща всички аспекти (например, сущности с много голям брой свойства, значително увеличаване на броя на свойствата на съществуващите данни,…), така че, ако имате някакви предложения за подобряване, не се колебайте да оставяте коментари!
Източник: habr.com
