

С базата данни Apache Cassandra и необходимостта от нейното експлоатиране в рамките на инфраструктурата, базирана на Kubernetes, често се сблъскваме. В този материал ще споделим нашето виждане за необходимите стъпки, критерии и съществуващи решения (включително преглед на операторите) за миграция на Cassandra в K8s.
«Който може да управлява жена, може да управлява и държавата»
Коя е всъщност Cassandra? Това е разпределена система за съхранение, предназначена за управление на големи обеми данни, като в същото време осигурява висока наличност без единична точка на отказ. Проектът едва ли се нуждае от дълго представяне, затова ще представя само основните характеристики на Cassandra, които ще бъдат актуални в контекста на конкретната статия:
- Cassandra е написана на Java.
- Топологията на Cassandra включва няколко нива:
- Node — един разгрънат екземпляр на Cassandra;
- Rack — група екземпляри на Cassandra, свързани по някакъв признак, намиращи се в един и същ датacenter;
- Datacenter — съвкупност от всички групи екземпляри на Cassandra, находящи се в един датacenter;
- Cluster — съвкупност от всички датacenters.
- За идентификация на възела Cassandra използва IP адрес.
- За бързината на операциите за запис и четене, част от данните Cassandra съхранява в оперативна памет.
Сега — към самата потенциална миграция в Kubernetes.
Check-list за пренос
Говорейки за миграцията на Cassandra в Kubernetes, ние се надяваме, че с преместването управлението ще стане по-удобно. Какво ще е необходимо за това и какво ще помогне?
1. Хранилище за данни
Както вече беше уточнено, част от данните на Cassandra се съхраняват в оперативна памет — в Memtable. Но има и друга част от данните, които се запазват на диск — под формата на SSTable. Към тези данни се добавя и същността Commit Log — записи за всички транзакции, които също се записват на диск.
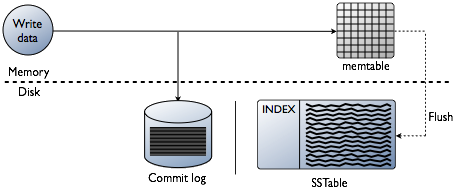
Схема на транзакциите за запис в Cassandra
В Kubernetes можем да използваме PersistentVolume за съхраняване на данни. Благодарение на утвърдените механизми, работата с данни в Kubernetes става все по-лесна с всяка изминала година.
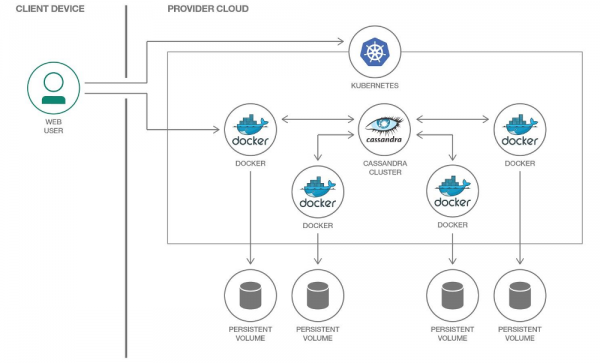
На всеки pod с Cassandra ще отделим собствен PersistentVolume.
Важно е да се отбележи, че Cassandra по своята същност предполага репликация на данни, предлагайки вградени механизми за това. Следователно, ако изграждате Cassandra клъстер от голям брой възли, няма нужда да използвате разпределени системи като Ceph или GlusterFS за съхранение на данни. В този случай логично е да съхранявате данните на диска на възела чрез или монтиране hostPath.
Друг е въпросът, ако искате да създавате отделна среда за разработчици за всяка feature-клон. В този случай правилният подход би бил да стартирате един възел на Cassandra, а данните да се съхраняват в разпределено хранилище, т.е. посочените Ceph и GlusterFS ще станат ваша опция. Тогава разработчикът ще бъде сигурен, че няма да загуби тестовите данни дори при загуба на един от възлите в Kubernetes клъстера.
2. Мониторинг
Практически алтернативен избор за реализиране на мониторинг в Kubernetes е Prometheus (подробно сме разказвали за това в ). Как е положението с метриките на Cassandra за Prometheus? И, което е дори по-важно, с подходящите табла за графики за Grafana?
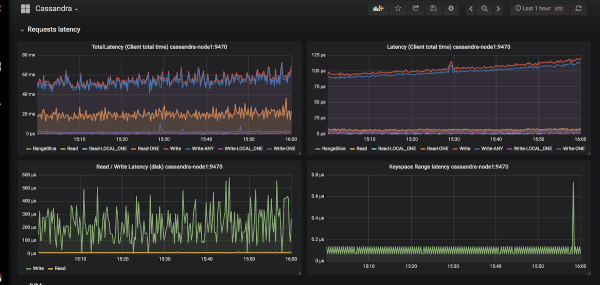
Примерен външен вид на графиките в Grafana за Cassandra
Има само двама експортьори: и .
Избрахме първия, защото:
- JMX Exporter расте и се развива, докато Cassandra Exporter не успя да получи необходимата подкрепа от общността. Cassandra Exporter все още не поддържа повечето версии на Cassandra.
- Може да се стартира като javaagent, добавяйки флага
-javaagent:<plugin-dir-name>/cassandra-exporter.jar=--listen=:9180. - За него съществува , което не е съвместимо с Cassandra Exporter.
3. Избор на примитиви на Kubernetes
Според описаната по-горе структура на Cassandra клъстера, ще се опитаме да преведем всичко, което е описано, в терминологията на Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → пул от StatefulSets
- Cassandra Cluster → ???
Излиза, че ни липсва някаква допълнителна същност, за да управляваме целия клъстер на Cassandra наведнъж. Но ако нещо липсва, можем да го създадем! В Kubernetes за това е предназначен механизма за определяне на собствени ресурси — .
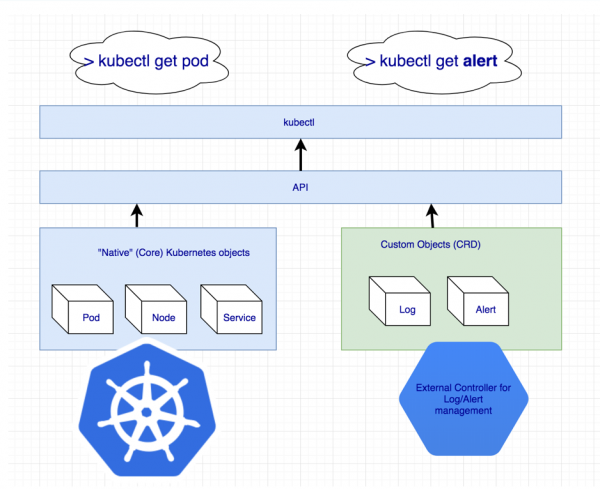
Декларации на допълнителни ресурси за логове и известия
Но сам по себе си Custom Resource не означава нищо: нуждае се от контролер. Може да се наложи да прибегнем до помощта на …
4. Идентификация на pod’ов
По-горе се съгласихме, че един узел Cassandra ще отговаря на един pod в Kubernetes. Но IP адресите на pod-овете всеки път ще са различни. А идентификацията на узел в Cassandra се осъществява именно на базата на IP адреса… Получава се, че след всяко изтриване на pod, клъстерът Cassandra ще добави нов узел в себе си.
Има решение, и дори не едно:
- Можем да проследяваме по идентификаторите на хостовете (UUID, които еднозначно идентифицират екземплярите на Cassandra) или по IP адресите и да запазваме всичко това в определени структури/таблици. Методът има два основни недостатъка:
- Риск от възникване на условие на гонка при падение на два узла едновременно. След рестартиране, узлите Cassandra ще започнат да запитват за IP адреси от таблицата и ще се конкурират за един и същ ресурс.
- Ако узел Cassandra е загубил данните си, вече не можем да го идентифицираме.
- Второто решение изглежда като малък трик, но все пак: можем да създадем Service с ClusterIP за всеки узел Cassandra. Проблемите на тази реализация:
- Ако клъстерът Cassandra има много узли, ще трябва да създадем много Service-ове.
- Възможността за ClusterIP е реализирана чрез iptables. Това може да стане проблем, ако в клъстера Cassandra има много (1000… или дори 100?) узла. Въпреки че може да реши този проблем.
- Третото решение е да използваме мрежата на узлите Cassandra вместо отделна мрежа на pod-овете, чрез активиране на настройка
hostNetwork: true. Този метод налага определени ограничения:- По замяната на узли. Трябва новият узел да има същия IP адрес, както предишния (в облаците като AWS, GCP, това е почти невъзможно);
- Използвайки мрежата на клъстера, започваме да се конкурираме за мрежови ресурси. Следователно, е проблематично да поставим повече от един pod с Cassandra на един клъстерен узел.
5. Резервни копия
Искаме да запазим пълна версия на данните на един узел Cassandra по график. Kubernetes предоставя удобна възможност с използването на , но тук проблемите идват от самата Cassandra.
Напомням, че част от данните на Cassandra се съхраняват в паметта. За да направим пълно резервно копие, трябва данните от паметта (Memtables) да се прехвърлят на диск (SSTables). В този момент узелът Cassandra спира да приема връзки, напълно изключвайки се от работата на клъстера.
След това се прави резервно копие (snapshot) и се запазва схемата (keyspace). И тук се оказва, че просто бекъпът не ни дава нищо: трябва да запазим идентификаторите на данните, за които отговаря възелът Cassandra – това са специални токени.
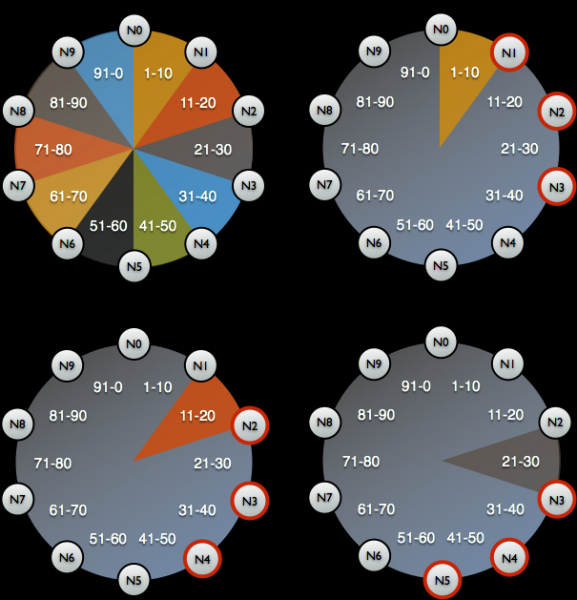
Разпределение на токените за идентифициране на данните, за които отговарят възлите Cassandra
Пример за скрипт за създаване на бекъп на Cassandra от Google в Kubernetes може да бъде намерен на . Единственият момент, който скриптът не предвижда, е нулирането на данните на възела преди създаването на snapshot. Тоест, бекъпът се изпълнява не за текущото състояние, а за състоянието малко по-рано. Но това помага да не се изключва възелът от работа, което е много логично.
set -eu

if [[ -z "$1" ]]; then
  info "Моля, предоставете пространство от ключове"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Грешка при създаване на snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk 'разпределителна директория: { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Пример на bash-скрипт за създаване на бекъп от един възел Cassandra
Готови решения за Cassandra в Kubernetes
Какво всъщност се използва в момента за разгръщане на Cassandra в Kubernetes и кое от тях най-добре отговаря на зададените изисквания?
1. Решения, основани на StatefulSet или Helm-чарти
Използването на основните функции на StatefulSets за стартиране на кластер Cassandra е добро решение. Чрез Helm-чарт и шаблони Go можете да предоставите на потребителя гъвкав интерфейс за разгръщане на Cassandra.
Обикновено това работи добре… докато не се случи нещо неочаквано — например, повреда на възел. Стандартните инструменти на Kubernetes просто не могат да предвидят всички описани по-горе особености. Освен това, този подход е силно ограничен по отношение на мащабируемост за по-сложни приложения: замяна на възли, резервни копия, възстановяване, мониторинг и т.н.
Представители:
- ;
- .
И двата чарта са еднакво добри, но имат описаните по-горе проблеми.
2. Решения, основани на Kubernetes Operator
Тези опции са по-интересни, тъй като предоставят широки възможности за управление на клъстера. За проектиране на оператора Cassandra, както и за всяка друга база данни, добър шаблон изглежда така: Sidecar <-> Controller <-> CRD:
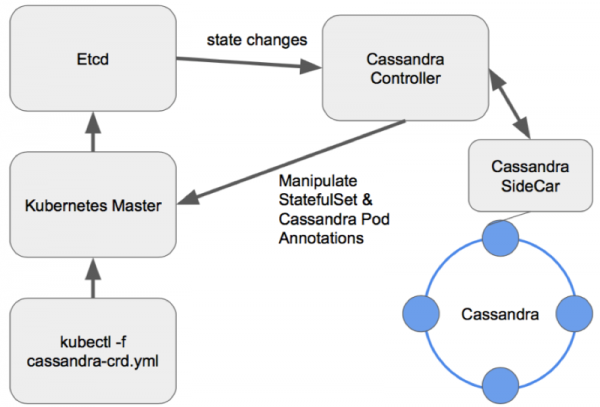
Схема за управление на възлите в правилно проектиран оператор Cassandra
Нека разгледаме съществуващите оператори.
1. Cassandra-оператор от instaclustr
- Готовност: Alpha
- Лицензия: Apache 2.0
- Реализиран на: Java
Това е наистина многообещаващ и активно развиващ се проект от компания, която предлага управлявани внедрения на Cassandra. Както е описано по-горе, той използва sidecar контейнер, който приема команди чрез HTTP. Написан е на Java, затова понякога му липсва по-напреднала функционалност на библиотеката client-go. Освен това операторът не поддържа различни Racks за един Datacenter.
Но операторът има предимства, като поддръжка на мониторинг, високо ниво на управление на клъстера чрез CRD и дори документация за създаване на резервни копия.
2. Navigator от Jetstack
- Готовност: Alpha
- Лицензия: Apache 2.0
- Реализиран на: Golang
Оператор, предназначен за внедряване на DB-as-a-Service. В момента поддържа две бази данни: Elasticsearch и Cassandra. Съдържа интересни решения, като контрол на достъпа до базата данни чрез RBAC (за целта стартира свой отделен navigator-apiserver). Интересен проект, който заслужава внимание, но последният комит е направен преди година и половина, което явно намалява потенциала му.
3. Cassandra-оператор от vgkowski
- Готовност: Alpha
- Лицензия: Apache 2.0
- Реализиран на: Golang
Не го разглеждаха сериозно, тъй като последният комит в репозитория е повече от година назад. Разработката на оператора е забравена: последната версия на Kubernetes, обявена за поддържана, е 1.9.
4. Cassandra-оператор от Rook
- Готовност: Alpha
- Лицензия: Apache 2.0
- Реализиран на: Golang
Оператор, чийто напредък не е толкова бърз, колкото би ни се искало. Има замислена структура CRD за управление на клъстера, решава проблема с идентификацията на възлите чрез Service с ClusterIP (това е съответният “хак”)… но засега това е всичко. В момента няма вградена поддръжка за мониторинг и резервни копия (процесът по мониторинг) ). Интересен момент е, че с помощта на този оператор може да се внедри и ScyllaDB.
NB: Този оператор с някои малки корекции сме използвали в един от нашите проекти. Проблеми в работата на оператора през времето на експлоатация (~4 месеца работа) не са забелязани.
5. CassKop от Orange
- Готовност: Alpha
- Лицензия: Apache 2.0
- Реализиран на: Golang
Най-младият оператор в списъка: първият комит е направен на 23 май 2019 година. Вече сега той има в арсенала си голямо количество функции от нашия списък, с които можете да се запознаете по-подробно в репозитория на проекта. Операторът е изграждан на базата на популярния operator-sdk. Поддържа мониторинг "извън кутията". Основното различие от другите оператори е използването на , реализиран на Python и използван за комуникация между възлите на Cassandra.
Изводи
Броят на подходите и възможните варианти за преместване на Cassandra в Kubernetes говори сам за себе си: темата е търсена.
На този етап можете да изпробвате нещо от гореописаното на собствен риск: никой от разработчиците не гарантира 100% работоспособност на решението си в production среда. Но вече много продукти изглеждат обещаващо, за да опитате да ги използвате в разработки.
Мисля, че в бъдеще тази жена на кораба ще е на място!
P.S.
Прочетете също в нашия блог:
- «»;
- «»;
- «»;
- «».
Източник: habr.com
