

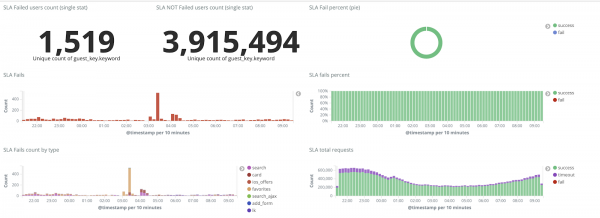
Здравейте на всички, аз съм Александър и работя в ЦИАН като инженер, занимавам се със системно администриране и автоматизация на инфраструктурни процеси. В коментарите под една от предишните статии ни помолиха да споделим откъде получаваме 4 ТБ логове на ден и какво правим с тях. Да, имаме много логове и за тяхната обработка е създаден отделен инфраструктурен клъстер, който ни позволява бързо да решаваме проблеми. В тази статия ще разкажа как през годината адаптирахме системата да работи с постоянно нарастващ поток от данни.
С какво започнахме
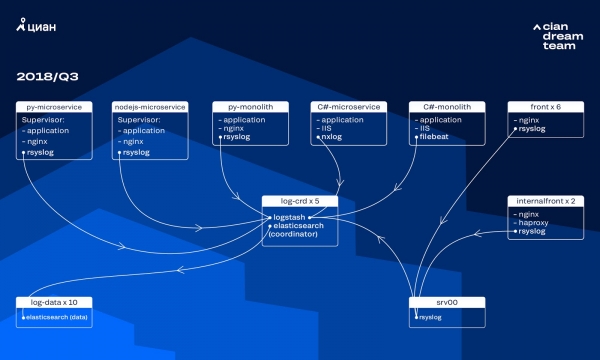
През последните няколко години натоварването на cian.ru нарастваше много бързо и до третото тримесечие на 2018 г. посещаемостта на ресурса достигна 11.2 милиона уникални потребители на месец. В критични моменти губехме до 40% от логовете, поради което не можехме бързо да се справим с инцидентите и отделяхме много време и усилия за тяхното решение. Също така често не можехме да намерим причината за проблема, а той се повтаряше след известно време. Това беше ад, с който трябваше да се справим.
В онзи момент за съхранение на логовете използвахме клъстер от 10 дата-нод с ElasticSearch версия 5.5.2 с типични настройки на индексите. Той беше внедрен преди повече от година като популярно и достъпно решение: тогава потокът от логове не беше толкова голям и не беше смислено да измисляме нестандартни конфигурации.
Обработката на входящите логове се извършваше от Logstash на различни портове на пет координатора ElasticSearch. Един индекс, независимо от размера, се състоеше от пет шардa. Беше организирана почасова и дневна ротация, в резултат на което всеки час в клъстера се появяваха около 100 нови шардa. Докато логовете не бяха много, клъстерът се справяше и никой не обърна внимание на настройките му.
Проблеми с бързия растеж
Обемът на генерираните логове нарастваше много бързо, тъй като се наклониха два процеса. От една страна, услугата имаше все повече потребители. От друга страна, започнахме активно да преминаваме към микросервисна архитектура, разделяйки нашите стари монолити на C# и Python. Няколко десетки нови микросервиза, заменящи части от монолита, генерираха значително повече логове за инфраструктурния клъстер.
Точно скалирането доведе до това, че клъстерът стана практически неуправляем. Когато логовете започнаха да пристигат със скорост от 20 хиляди съобщения в секунда, честа безполезна ротация увеличи броя на шардовете до 6 хиляди, а на една нода се падаха над 600 шардове.
Това водеше до проблеми с паметта, а при срив на нода започваше едновременно преместване на всички шардове, увеличаващо трафика и натоварващо останалите ноди, което правеше практически невъзможно записването на данни в клъстера. И в този период оставахме без логове. А при проблема с сървър загубихме 1/10 от клъстера принципно. Увеличаваше сложността голямото количество индекси с малък размер.
Без логове не разбирахме причините за инцидента и можехме рано или късно да стъпим на същите грабли отново, а в идеологията на нашия екип това бе недопустимо, тъй като всички механизми на работа са насочени точно на обратно — никога да не повтаряме одни и същи проблеми. За това ни трябваше пълен обем логове и тяхното доставяне практически в реално време, тъй като екипът на дежурните инженери следеше алармите не само от метриките, но и от логовете. За да разберем мащабите на проблема — към този момент общият обем на логовете беше около 2 Тб на ден.
Поставихме задача — напълно да изключим загубата на логове и да съкратим времето им за доставка до клъстера ELK максимум до 15 минути по време на извънредни ситуации (на тази цифра по-късно се опирахме като на вътрешен KPI).
Нов механизъм за ротация и hot-warm ноди
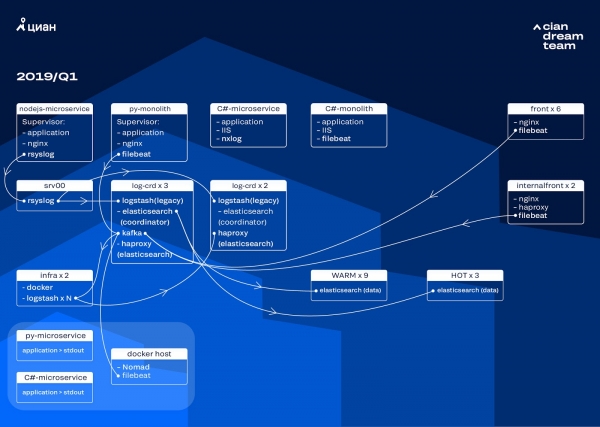
Преобразуването на клъстера започнахме с обновление на версията ElasticSearch от 5.5.2 до 6.4.3. Клъстерът отново се срина на 5-та версия и решихме да го затворим и напълно обновим — логове все пак нямаше. Така че преминахме през този процес за само няколко часа.
Най-мащабната трансформация на този етап беше внедряването на три ноди с координатор като междинна буферна система на Apache Kafka. Съобщителният брокер ни спаси от загуба на логове по време на проблеми с ElasticSearch. В същото време добавихме 2 ноди в клъстера и преминахме на hot-warm архитектура с три "горещи" ноди, разположени в различни стелажи в дата центъра. Натам пренасочихме логовете, които не трябваше да загубим — nginx, както и логовете за грешките на приложенията. На останалите ноди отиваха минорни логове — debug, warning и т.н., а след 24 часа „важните“ логове от „горещите“ ноди мигрираха.
За да не увеличаваме числото на малките индекси, преминахме от ротация по време на механизма rollover. На форумите имаше много информация, че ротацията по размер на индекса е много ненадеждна, така че решихме да използваме ротация по брой документи в индекса. Проучихме всеки индекс и фиксирахме броя на документите, след който трябва да се задейства ротацията. По този начин постигнахме оптимален размер на шард — не повече от 50 Гб.
Оптимизация на клъстера
Въпреки това, напълно не се освободихме от проблемите. За съжаление, все пак се появяваха малки индекси: те не достигнаха зададения обем, не се ротираха и се премахваха с глобално изчистване на индекси над три дни, тъй като премахнахме ротацията по дата. Това водеше до загуба на данни, защото индексът изчезваше напълно от клъстера, а опитът за запис в несъществуващ индекс разрушаваше логиката на curator-а, който използвахме за управление. Alias за запис се преобразуваше в индекс и разрушаваше логиката на rollover-а, предизвиквайки неконтролиран растеж на някои индекси до 600 Гб.
Например, за конфигурацията на ротацията:
сurator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
При липса на rollover alias се появяваше грешка:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  : Unable to perform index rollover with alias "nginx_write".
Решението на този проблем оставихме за следващата итерация и се захванахме с друг въпрос: преминахме на pull логика за работа с Logstash, който се занимава с обработка на входящите логове (премахване на излишната информация и обогатяване). Поставихме го в docker, който стартираме чрез docker-compose, там също разположихме logstash-exporter, който изпраща метрики в Prometheus за оперативен мониторинг на потока от логове. Така си осигурихме възможност плавно да променяме броя на инстанциите на logstash, отговорни за обработката на всеки вид логове.
Докато усъвършенствахме кластера, посещаемостта на cian.ru нарасна до 12,8 млн уникални потребители на месец. В резултат на това нашите преобразувания малко изостанаха спрямо промените в продукцията, и се сблъскахме с проблема, че "топлите" нодове не се справяха с натоварването и забавяха цялата доставка на логове. "Горещите" данни получавахме без прекъсвания, но при доставката на останалите се налагаше да се намесваме и да правим ръчен rollover, за да разпределяме индексите равномерно.
В същото време мащабирането и промените в настройките на инстанциите на logstash в кластера се усложняваха от факта, че това беше локален docker-compose, и всички действия се извършваха ръчно (за добавяне на нови крайни точки бе необходимо ръчно да се мине през всички сървъри и навсякъде да се изпълни docker-compose up -d).
Преразпределение на логовете
През септември тази година все още продължавахме да разделяме монолита, натоварването на кластера нарастваше, а потокът от логове приближаваше 30 хиляди съобщения в секунда.
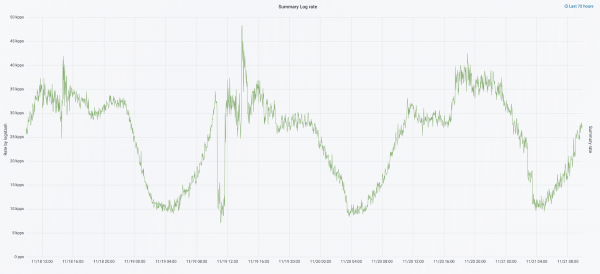
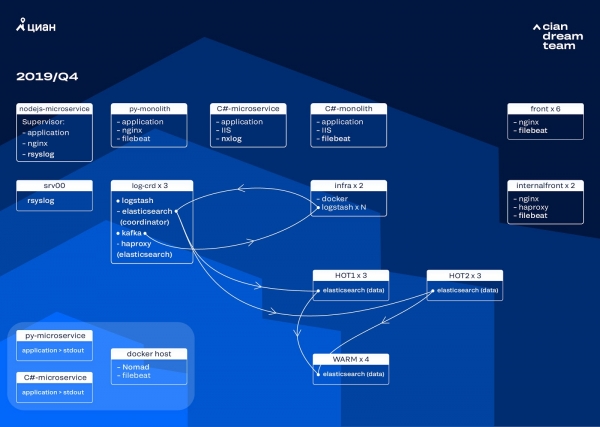
Следващата итерация започнахме с обновление на хардуера. От пет координации преминахме на три, заменихме дата-нодовете и спечелихме финансово и по обем на хранилището. За нодовете използваме две конфигурации:
- За "горещите" нодове: E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 за Hot1 и 3 за Hot2).
- За "топлите" нодове: E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
На тази итерация преместихме индекса с access-логовете на микросервисите, който заема толкова място, колкото логовете на фронтовите nginx, във втората група от три "горещи" нодове. Данните на "горещите" нодове вече съхраняваме 20 часа, а след това прехвърляме на "топлите" към останалите логове.
Проблемата с изчезването на малките индекси бе решена чрез пренастройка на тяхната ротация. Сега индексите се ротироват на всеки 23 часа, дори и да имат малко данни. Това донякъде увеличи броя на шардовете (станаха около 800), но от гледна точка на производителността на клъстера, това е приемливо.
В резултат на това в клъстера получихме шест „горещи“ и само четири „топли“ ноди. Това предизвиква малки закъснения при заявките за дълги интервали от време, но увеличението на броя на нодите в бъдеще ще реши този проблем.
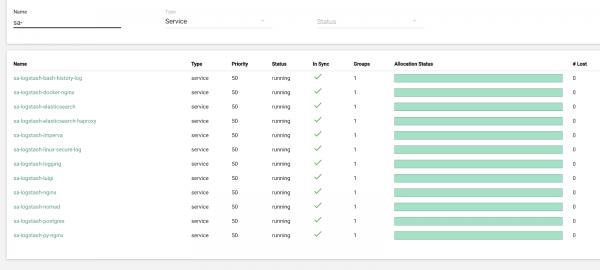
В тази итерация бяха коригирани и проблемите с липсата на полуавтоматично мащабиране. За целта разгръщаме инфраструктурен Nomad клъстер — аналогичен на този, който вече е разгръщен в производствения ни режим. Все още броят на Logstash не се променя автоматично в зависимост от натоварването, но и до това ще стигнем.
Планове за бъдещето
Реализираната конфигурация се мащабира отлично и в момента съхраняваме 13,3 Тб данни — всички логове за 4 дни, което е необходимо за спешен анализ на алармите. Част от логовете трансформираме в метрики, които съхраняваме в Graphite. За да улесним работата на инженерите, имаме метрики за инфраструктурния клъстер и скриптове за полуавтоматично поправяне на типични проблеми. След увеличението на броя на дата-нодите, планирано за следващата година, ще преминем на съхранение на данни от 4 на 7 дни. Това ще бъде достатъчно за оперативната работа, тъй като винаги се стремим да разследваме инциденти възможно най-бързо, а за дългосрочни разследвания имаме данни за телеметрия.
През октомври 2019 година посещаемостта на cian.ru нарасна до 15,3 милиона уникални потребители на месец. Това се оказа сериозна проверка на архитектурното решение за доставка на логове.
В момента се подготвяме да обновим ElasticSearch до версия 7. Въпреки това, ще трябва да обновим мапинга на много индекси в ElasticSearch, тъй като те бяха прехвърлени от версия 5.5 и бяха обявени за остарели в версия 6 (в версия 7 просто ги няма). И това означава, че по време на обновлението със сигурност ще възникне някакъв форсмажор, който временно ще ни остави без логове. От версия 7 най-много очакваме Kibana с подобрен интерфейс и нови филтри.
Основната цел, която постигнахме: спряхме да губим логовете и намалихме времето за престой на инфраструктурния клъстер от 2-3 падения на седмица на само няколко часа сервизна работа на месец. Цялата тази работа в продукцията почти не се забелязва. Въпреки това, сега можем точно да определим какво се случва с нашия сервис, можем бързо да действаме в спокойно темпо и да не се притесняваме, че логовете ще бъдат загубени. Като цяло сме доволни, щастливи и се подготвяме за нови предизвикателства, за които ще разкажем по-късно.
Източник: habr.com
