

В моята професия често се срещам със ситуации, в които разработчикът пише запитване и мисли: "базата е умна, сама ще се справи!"«
В някои случаи (частично поради неосведоменост относно възможностите на базата данни, частично поради преждевременна оптимизация) този подход води до появата на "франкенштейни".
Първо ще дам пример за такова запитване:
-- за всяка ключова двойка намираме асоциираните стойности на полетата
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- намираме min/max стойности за всеки първи ключ
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- свързваме по първия ключ ключовите двойки и min/max-стойностите
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
За да оценим качеството на запитването, нека създадем произволен набор от данни:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
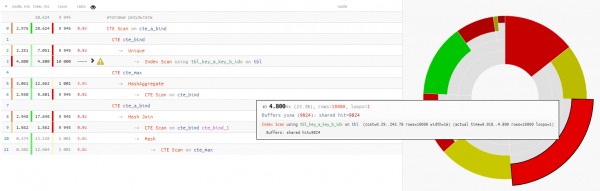
Оказва се, че самото четене на данни е отнело по-малко от една четвърт от общото време за изпълнение на запитването:
Разглеждаме детайлно
Нека се вгледаме в запитването и да се озадачим:
- Защо тук е WITH RECURSIVE, ако няма рекурсивни CTE?
- Защо да групираме min/max-стойностите в отделен CTE, ако след това все пак се свързват с оригиналната извадка?
+25% време - Защо да използваме в края повторно четене от предишния CTE чрез безусловния 'SELECT * FROM'?
+14% време
В този случай ни е било много късмет, че за свързването е избран Hash Join, а не Nested Loop, защото в противен случай щяхме да получим не един-единствен проход CTE Scan, а 10K!
малко за CTE ScanТук трябва да запомним, че CTE Scan е аналог на Seq Scan — т.е. никаква индексация, а само пълен обход, който би изисквал 10K x 0.3ms = 3000ms при цикли по cte_max или 1K x 1.5ms = 1500ms при цикли по cte_bind!
Всъщност, какво искахме да получим в крайна сметка? Аха, обикновено точно такъв въпрос идва на 5-та минута, когато разглеждаме "триетажни" запитвания.
Искахме за всяка уникална ключова двойка да изведем min/max от групата по key_a.
Така че нека използваме за целта :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 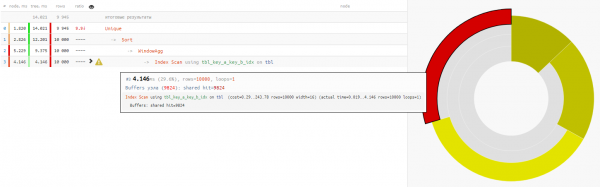
Тъй като четенето на данни и в двата варианта отнема приблизително 4-5 мс, целият ни спечелен времеви ресурс -32% е в чист вид натоварване, което е отнето от CPU базата, ако такава заявка се изпълнява достатъчно често.
В общи линии, не трябва да принуждавате базата да "носи кръглото и да търкаля квадратното".
Източник: habr.com
