

Бойте се от операции, buffers, които носят...
На примера на един малък заявка ще разгледаме някои универсални подходи за оптимизация на заявки в PostgreSQL. Да ги ползвате или не – решавате вие, но е добре да знаете за тях.
В някои последващи версии на PG ситуацията може да се промени с "умния" плановик, но за 9.4/9.6 тя изглежда горе-долу еднакво, както примерите тук.
Ще взема напълно реална заявка:
SELECT
  TRUE
FROM
  "Документ" d
INNER JOIN
  "ДокументРасширение" doc_ex
    USING("@Документ")
INNER JOIN
  "ТипДокумента" t_doc ON
    t_doc."@ТипДокумента" = d."ТипДокумента"
WHERE
  (d."Лицо3" = 19091 or d."Сотрудник" = 19091) AND
  d."$Черновик" IS NULL AND
  d."Удален" IS NOT TRUE AND
  doc_ex."Состояние"[1] IS TRUE AND
  t_doc."ТипДокумента" = 'ПланРабот'
LIMIT 1;
за имената на таблиците и полетатаКъм "руските" названия на полетата и таблиците може да се подхожда по различен начин, но това е въпрос на вкус. Тъй като нямаме разработчици и чужденци, а PostgreSQL ни позволява да даваме имена дори на йероглифи, стига те да са в кавички, предпочитаме да именуваме обектите точно и ясно, за да не възникват неясноти.
Нека да погледнем получен план:
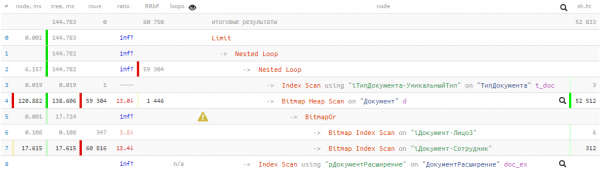
144ms и почти 53K buffers — тоест повече от 400MB данни! И ще имаме късмет, ако всички те се окажат в кеша в момента на нашата заявка, иначе тя ще стане многократно по-дълга при четенето от диска.
Алгоритъмът е всичко!
За да оптимизираме каквато и да е заявка, първо трябва да разберем какво точно трябва тя да прави.
Оставяме за момента разработката на самата структура на БД и се споразумяваме, че можем относително "евтино" да пренапишем заявката и/или да наложим на базата някои нужни ни индекси..
И така, заявката:
— проверява съществуването на някой документ
— в нужното ни състояние и определен тип
— където автор или изпълнител е нужният ни служител.
JOIN + LIMIT 1
Достатъчно често на разработчика му е по-лесно да напише заявка, където първо се извършва свързване на голям брой таблици, а след това от всичкото това множество остава един-единствен запис. Но по-лесно за разработчика не значи непременно по-ефективно за БД.
В нашия случай таблиците бяха само 3 — а какъв ефект...
Нека първо да се отървем от свързването с таблицата "ТипДокумента", а заедно да подскажем на базата, че записът с типа е уникален (ние знаем това, а плановикът все още не подозира):
С T КАК (
  ВЫБРАТЬ
    "@ТипДокумента"
  ИЗ
    "ТипДокумента"
  ГДЕ
    "ТипДокумента" = 'ПланРабот'
  ЛИМИТ 1
)
...
ГДЕ
  d."ТипДокумента" = (ТАБЛИЦА T)
...
Да, если таблица/CTE состоит из единственного поля и единственной записи, то в PG можно написать даже так, вместо
d."ТипДокумента" = (ВЫБРАТЬ "@ТипДокумента" ИЗ T ЛИМИТ 1)«Ленивые» вычисления в запросах PostgreSQL
BitmapOr против UNION
В некоторых случаях Bitmap Heap Scan будет стоить нам очень дорого — например, в нашей ситуации, когда достаточно много записей подпадает под требуемое условие. Мы получили это из-за OR-условия, превратившегося в BitmapOr-операцию в плане.
Вернемся к исходной задаче — необходимо найти запись, соответствующую любому из условий — то есть незачем искать все 59K записей по обоим условиям. Есть способ отработать одно условие, а ко второму перейти только когда по первому ничего не нашлось. Нам поможет такая конструкция:
(
  ВЫБРАТЬ
    ...
  ЛИМИТ 1
)
UNION ALL
(
  ВЫБРАТЬ
    ...
  ЛИМИТ 1
)
ЛИМИТ 1
«Внешний» ЛИМИТ 1 гарантирует, что поиск завершится при нахождении первой же записи. И если она найдется уже в первом блоке, выполнение второго осуществляться не будет (never executed в плане).
«Прячем под CASE» сложные условия
В исходном запросе есть крайне неудобный момент — проверка состояния по связанной таблице «ДокументРасширение». Независимо от истинности остальных условий в выражении (например, d.«Удален» IS NOT TRUE), это соединение выполняется всегда и «стоит ресурсов». Больше или меньше их будет потрачено — зависит от объема этой таблицы.
Но можно модифицировать запрос так, чтобы поиск связанной записи происходил бы только тогда, когда это действительно необходимо:
ВЫБРАТЬ
  ...
ИЗ
  "Документ" d
ГДЕ
  ... /*index cond*/ И
  CASE
    КОГДА "$Черновик" IS NULL И "Удален" IS NOT TRUE ТО ЕСТЬ (
      ВЫБРАТЬ
        "Состояние"[1] IS TRUE
      ИЗ
        "ДокументРасширение"
      ГДЕ
        "@Документ" = d."@Документ"
    )
  КОНЕЦ
Раз из связываемой таблицы нам не нужно для результата ни одно из полей, то мы имеем возможность превратить JOIN в условие по подзапросу.
Оставим индексируемые поля «за скобками» CASE, простые условия от записи вносим в блок WHEN — и теперь «тяжелый» запрос выполняется только при переходе в THEN.
Моя фамилия «Итого»
Собираем результирующий запрос со всеми описанными выше механизмами:
С T КАТО (
  ИЗ
    "ТипДокумента"
  КЪДЕ
    "ТипДокумента" = 'ПланРабот'
)
  (
    ИЗ
      "Документ" d
    КЪДЕ
      ("Лицо3", "ТипДокумента") = (19091, (ТАБЛИЦА T)) И
      СЛУЧАЙ
        КОГАТО "$Черновик" Е NULL И "Удален" НЕ Е ИСТИНА ТОГАВА (
          ИЗ
            "ДокументРасширение"
          КЪДЕ
            "@Документ" = d."@Документ"
        )
      КРАЙ
    ОГРАНИЧЕНИЕ 1
  )
СЪЮЗ ВСИЧКИ
  (
    ИЗ
      "Документ" d
    КЪДЕ
      ("ТипДокумента", "Сотрудник") = ((ТАБЛИЦА T), 19091) И
      СЛУЧАЙ
        КОГАТО "$Черновик" Е NULL И "Удален" НЕ Е ИСТИНА ТОГАВА (
          ИЗ
            "ДокументРасширение"
          КЪДЕ
            "@Документ" = d."@Документ"
        )
      КРАЙ
    ОГРАНИЧЕНИЕ 1
  )
ОГРАНИЧЕНИЕ 1;
Настройваме [под] индексите
Опитният поглед забеляза, че индексируемите условия в подблоковете UNION леко се различават — това е, защото вече имаме подходящи индекси на таблицата. А ако ги нямаше — щеше да си струва да се създадат: Документ(Лицо3, ТипДокумента) и Документ(ТипДокумента, Сотрудник).
за реда на полетата в ROW-условиятаОт гледна точка на планировача, разбира се, може да се напише и (A, B) = (constA, constB), и (B, A) = (constB, constA). Но при записване в реда на полетата в индекса, такава заявка е просто по-удобна за отстраняване на проблеми след това.
Какво следва?
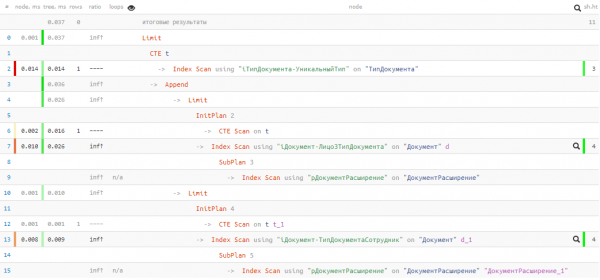
За съжаление, нямаха късмет и в първия блок на UNION не беше намерено нищо, затова вторият все пак премина в изпълнение. Но дори и при това — само 0.037ms и 11 buffers!
Ускорихме заявката и намалихме „прокачването“ на данни в паметта хиляди пъти, като използвахме съвсем прости методи — добър резултат при малко копипейст. 🙂
Източник: habr.com
