

Здравейте, habr.
Ако някой експлоатира системата и е срещнал проблеми с производителността на хранилището (IO, използвано дисково пространство), то вероятността да се е погледнало към ClickHouse като заместител, трябва да се стреми към единица. Това твърдение предполага, че за приемане на метрики вече се използва трета страна реализация, например или .
ClickHouse решава описаните проблеми много добре. Например, след прехвърлянето на 2TiB данни от whisper, те се събраха в 300GiB. Няма да се спирам подробно на сравненията, темата е обширна. Освен това, до неотдавна с нашето ClickHouse хранилище не всичко беше идеално.
Проблеми с използваното пространство
На пръв поглед, всичко трябва да работи добре. Следвайки , създаваме конфигурация за схемата на хранилище на метрики (по-нататък retention), след това създаваме таблица според препоръките на избрания бекенд за graphite-web: + или , в зависимост от това, какъв стек се използва. И… включва се бомба с забавено действие.
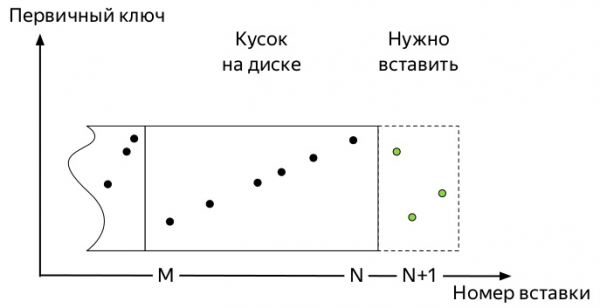
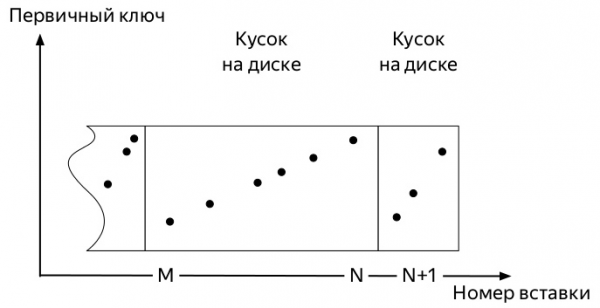
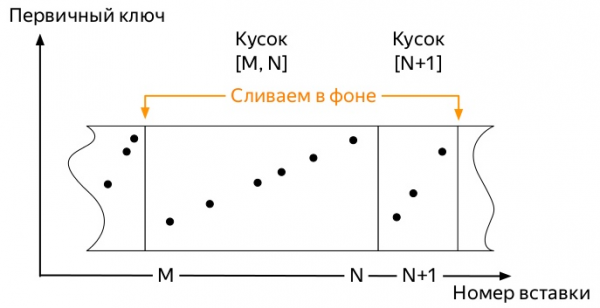
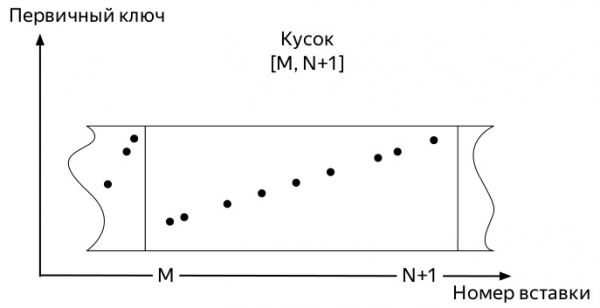
За да разберем каква е, трябва да знаем как работят вмъкванията и по-нататъшният жизнен цикъл на данните в таблиците на двигателя от семейството *MergeTree ClickHouse (графиките са взети от Алексей Зателепин):
- Вмъква се
блокданни. В нашия случай това са метрики.

- Всеки такъв блок преди записването на диск се сортира според ключа
ORDER BY, указан при създаването на таблицата. - След сортиране,
парче(part) данни се записва на диск.
- Сървърът следи на заден план, за да няма много такива парчета, и стартира фонови
слияния(merge, по-нататък мержи).
- Сървърът спира да стартира мержи самостоятелно, след като данните престанат активно да постъпват в
партиция(partition), но може да стартира процеса ръчно с командатаOPTIMIZE. - Ако в партицията остане само едно парче, не може да се стартира мерж с обикновена команда, необходимо е да се използва
OPTIMIZE ... FINAL
Така че, постъпват първите метрики. И те заемат известно пространство. Последващите събития могат да варират в зависимост от много фактори:
- Ключът за партициониране може да бъде както много малък (ден), така и много голям (няколко месеца).
- Конфигурацията на retention може да включва няколко значителни прага на агрегация на данни вътре в активната партиция (където се записват метриките), а може и да не включва.
- Ако данните са много, то най-ранните парчета, които поради фонова агрегация вече могат да бъдат огромни (при избор на неоптимален ключ за партициониране), няма да агрегират сами с новите малки парчета.
И всичко свършва по един и същ начин. Пространството, заето от метриките в ClickHouse, само се увеличава, ако:
- не се прилага
OPTIMIZE ... FINALръчно или - не се вмъкват данни във всички партиции постоянна основа, за да се стартира фонова агрегация рано или късно.
Вторият метод изглежда най-прост в реализацията и, следователно, той е неправилен и беше тестван най-напред.
Написах достатъчно прост скрипт на python, който изпращаше фиктивни метрики за всеки ден през последните 4 години и се изпълняваше всеки час от cron.
Тъй като цялата работа на ClickHouse DBMS е изградена на принципа, че тази система рано или късно ще направи цялата фонова работа, но не е ясно кога, не успях да дочакам момента, в който старите огромни парчета ще започнат да агрегират с новите малки. Стана ясно, че трябва да намеря начин да автоматизирам принудителните оптимизации.
Информация в системните таблици на ClickHouse
Нека погледнем структурата на таблицата . Това е изчерпателна информация за всяко парче от всички таблици на сървъра ClickHouse. Съдържа, включително, следните колони:
- име на база данни (
database); - име на таблица (
table); - име и ID на партиция (
partition&partition_id); - когато парчето е било създадено (
modification_time); - най-малка и най-голяма дата в парчето (партиционирането става по дни) (
min_date&max_date);
Има също таблица , със следните интересни полета:
- име на база данни (
Tables.database); - име на таблица (
Tables.table); - възраст на метриката, когато трябва да се приложи следващата агрегация (
age);
И така:
- Имаме таблица с парчета и таблица с правила за агрегация.
- Обединяваме тяхното пресечение и получаваме всички таблици *GraphiteMergeTree.
- Търсим всички партиции, в които:
- има повече от едно парче
- или е настъпил моментът да се приложи следващото правило за агрегация, и
modification_timeе по-стара от този момент.
Реализация
Тази заявка
SELECT
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- Най-старото "правило", което може да бъде приложено за
    -- партицията, но не в бъдеще, виж (*)
    max(g.age) AS age,
    -- Броят на парчетата в партицията
    countDistinct(p.name) AS parts,
    -- За най-старата метрика в партицията се приема 00:00:00 на следващия ден
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- Кога партицията трябва да бъде оптимизирана
    max_time + age AS rollup_time,
    -- Кога най-старото парче в партицията е било обновено
    min(p.modification_time) AS modified_at
FROM system.parts AS p
INNER JOIN
(
    -- Всички правила за всички таблици *GraphiteMergeTree
    SELECT
        Tables.database AS database,
        Tables.table AS table,
        age
    FROM system.graphite_retentions
    ARRAY JOIN Tables
    GROUP BY
        database,
        table,
        age
) AS g ON
    (p.table = g.table)
    AND (p.database = g.database)
WHERE
    -- Само активни парчета
    p.active
    -- (*) И само редове, където правилата за агрегация вече трябва да бъдат приложени
    AND ((toDateTime(p.max_date + 1) + g.age) < now())
GROUP BY
    table,
    partition
HAVING
    -- Само партиции, които са по-млади от момента на оптимизация
    (modified_at  1)
ORDER BY
    table ASC,
    partition ASC,
    age ASC
върща всяка от партициите на таблиците *GraphiteMergeTree, мержовете на които трябва да освободят дисково пространство. Остана само да се направи малкото: да минем през всички тях с заявка OPTIMIZE ... FINAL. В окончателната реализация също е взето предвид, че активните партиции не трябва да бъдат пипани.
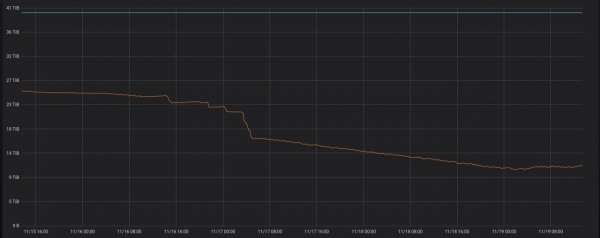
Точно това прави проектът . Бивши колеги от Яндекс.Маркет го тествали в продукция, резултатът от работата може да се види по-долу.
Ако пуснете програмата на сървър с ClickHouse, тя просто ще започне да работи в режим на демон. Веднъж на час ще се изпълнява заявка, проверявайки дали са се появили нови партиции на възраст над три дни, които могат да бъдат оптимизирани.
В близките планове – да предоставим, поне, deb пакети, а при възможност – и rpm.
Вместо заключение
През последните 9 и повече месеца прекарах време в моята компания преминавайки на кръстопътя на ClickHouse и graphite-web. Това беше добър опит, резултатът от който стана възможен бързият преход от whisper на ClickHouse като хранилище за метрики. Надявам се, че тази статия е нещо като начало на цикъл относно подобренията, които направихме в различни части на този стек, и какво ще бъде направено в бъдеще.
За разработката на заявката бяха изразходвани няколко литра бира и админ-дни в сътрудничество с , за което искам да му изразя своята благодарност. А също и за рецензиране на тази статия.
Източник: habr.com
