

Наука о данных за начинаещи
1. Анализ настроений (Sentiment Analysis через текст)
Вижте пълната реализация на проекта за Наука за данни с използване на изходния код — .
Анализ на настроенията — това е анализ на думите за определяне на настроения и мнения, които могат да бъдат положителни или отрицателни. Това е вид класификация, при която класовете могат да бъдат бинарни (положителни и отрицателни) или многобройни (щастливи, гневни, тъжни, неприятни ...). Ние ще реализираме този проект за Наука за данни на езика R и ще използваме набор от данни от пакета 'janeaustenR'. Ще използваме общи речници като AFINN, bing и loughran, ще извършим вътрешно свързване и накрая ще създадем облак от думи, за да визуализираме резултата.
Език: R
Набор от данни/Пакет: janeaustenR
Статья переведена при поддержке компании EDISON Software, которая , както и .
2. Обнаружение на фалшиви новини (Fake News Detection)
Вдигнете уменията си на ново ниво, работейки по проект за Наука за данни за начинаещи — .
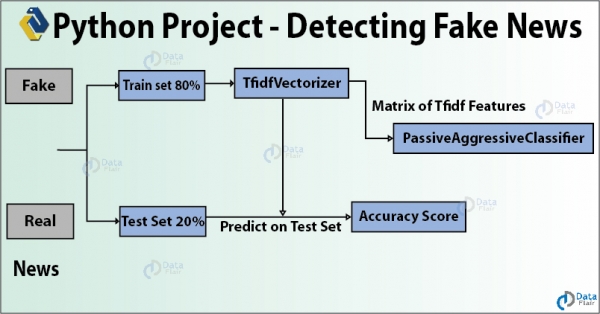
Фалшивите новини са неверна информация, разпространявана чрез социални мрежи и други онлайн медии с политическа цел. В тази идея за проект по Наука за данни ще използваме Python за изграждане на модел, който може точно да определи дали новината е истинска или фалшива. Ще създадем TfidfVectorizer и ще използваме PassiveAggressiveClassifier за класификация на новините на 'истински' и 'фалшиви'. Ще използваме набор от данни с размер 7796 × 4 и ще изпълним всичко в Jupyter Lab.
Език: Python
Набор от данни/Пакет: news.csv
3. Обнаружение на болестта на Паркинсон (Detecting Parkinson’s Disease)
Напредвайте, работейки по идеята на проекта за Наука за данни — .
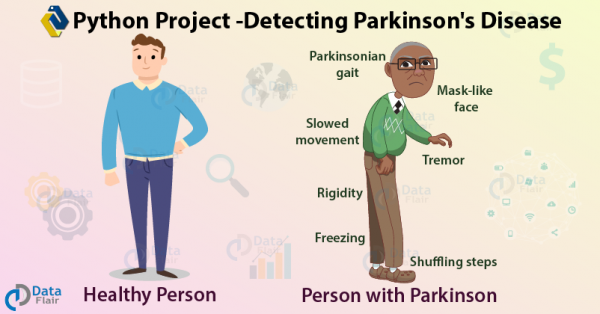
Ние започнахме да използваме Наука за данни, за да подобрим здравеопазването и услугите — ако можем да предскажем заболяването на ранен етап, ще имаме много предимства. И така, в тази идея за проект по Наука за данни ще научим как да идентифицираме болестта на Паркинсон с помощта на Python. Това е невропатична, прогресираща болест на централната нервна система, която засяга движението и предизвиква треперене и скованост. Тя засяга допаминовите невропи в мозъка, и всяка година засяга над 1 милион души в Индия.
Език: Python
Набор от данни/Пакет: UCI ML набор от данни за Паркинсон
Проекти за Наука за данни със средна сложност
4. Разпознаване на емоции в речта (Speech Emotion Recognition)
Запознайте се с пълната реализация на примера на проект за Data Science — .
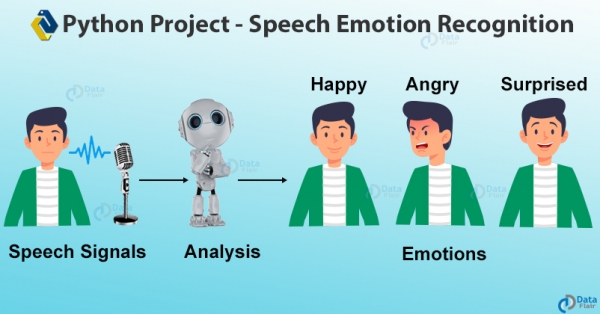
Нека сега научим как да използваме различни библиотеки. Този проект за Data Science използва librosa за разпознаване на реч. SER е процес на определяне на човешките емоции и афективни състояния чрез реч. Тъй като използваме тон и височина на тона, за да изразим емоции с гласа, SER е актуален. Но тъй като емоциите са субективни, анотиране на звука е сложна задача. Ще използваме функции mfcc, chroma и mel и ще използваме набора от данни RAVDESS за разпознаване на емоции. Ще създадем MLPC-класификатор за тази модел.
Език: Python
Набор от данни/Пакет: наборът от данни RAVDESS
5. Обнаружение на пол и възраст (Gender and Age Detection)
Впечатлете работодателите с най-новия проект за Data Science — .
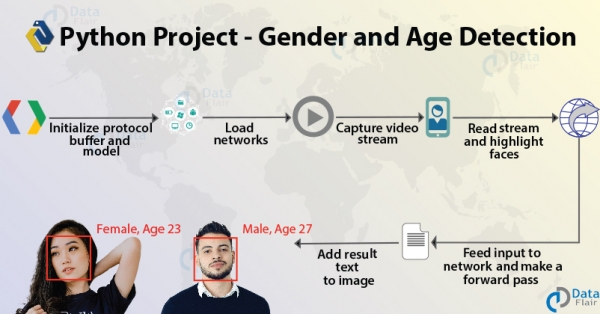
Това е интересен проект за Data Science с Python. Използвайки само една снимка, ще научите как да предсказвате пола и възрастта на човека. В това ще ви запознаем с Компютърно зрение и принципите му. Ще изградим и ще използваме модели, обучени от Тал Хаснер и Жил Леви за набора от данни Adience. По пътя ще използваме някои файлове .pb, .pbtxt, .prototxt и .caffemodel.
Език: Python
Набор от данни/Пакет: Adience
6. Анализ на данни за Uber (Uber Data Analysis)
Вижте пълната реализация на проекта за Data Science с изходен код — .
Това е проект за визуализация на данни с ggplot2, в който ще използваме R и неговите библиотеки, и ще анализираме различни параметри. Ще използваме набора от данни Uber Pickups в Ню Йорк и ще създадем визуализации за различни времеви рамки на годината. Това ни казва как времето влияе на пътуванията на клиентите.
Език: R
Набор от данни/Пакет: наборът от данни за Uber Pickups в Ню Йорк
7. Обнаружение на сънливост при шофьора (Driver Drowsiness detection)
Подобрете уменията си, работейки над най-добрия проект за Data Science — .
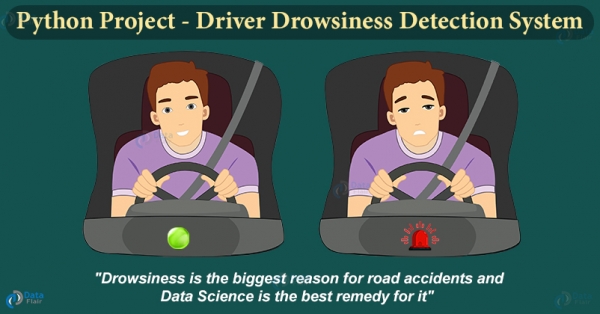
Сънливото шофиране е изключително опасно, и всяка година се случват около хиляда инцидента заради шофьори, които заспиват зад волана. В този проект на Python ще създадем система, която може да открива сънливи шофьори и също така да ги сигнализира със звуков сигнал.
Този проект е реализиран с Keras и OpenCV. Ще използваме OpenCV за откриване на лице и очи, а с помощта на Keras ще класифицираме състоянието на окото (Отворено или Затворено) с помощта на методи за дълбоко неурално обучение.
8. Чатбот
Създайте чатбот с Python и направете крачка напред в кариерата си — .
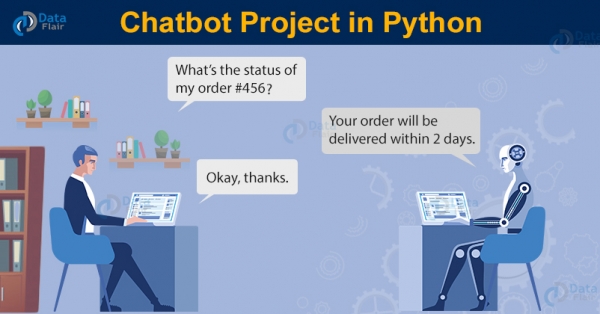
Чатботовете са неотменима част от бизнеса. Много предприятия се налага да предлагат услуги на своите клиенти, а за обслужването им е необходимо много работна сила, време и усилия. Чатботовете могат да автоматизират голяма част от взаимодействието с клиентите, отговаряйки на някои често задавани въпроси. По същество има два типа чатботове: Специфични за домейн и Отворен домейн. Специфичните за домейн чатботове често се използват за решаване на конкретен проблем. Следователно, е необходимо да го настроите, за да работи ефективно във вашата сфера. Чатботовете с отворен домейн могат да задават всякакви въпроси, затова за обучаването им е необходимо огромно количество данни.
Набор от данни: Файл json с намерения
Език: Python
Напреднали проекти в Data Science
9. Генератор на описания на изображения
Проверете пълната реализация на проекта с изходен код — .
Описание на това, което има на изображението, е лесна задача за хората, но за компютрите изображението е просто набор от цифри, представляващи стойността на цвета на всеки пиксел. Това е трудна задача за компютрите. Да разберем какво се съдържа в изображението и след това да създадем описание на естествен език (например на английски) е друга трудна задача. Този проект използва методи на дълбоко обучение, в които реализираме Конволюционна неурална мрежа (CNN) с рекурентна неурална мрежа (LSTM) за създаване на генератор на описание на изображение.
Набор от данни: Flickr 8K
Език: Python
Фреймворк: Keras
10. Откриване на измами с кредитни карти
Направете всичко възможно, работейки по проекта в Data Science — .
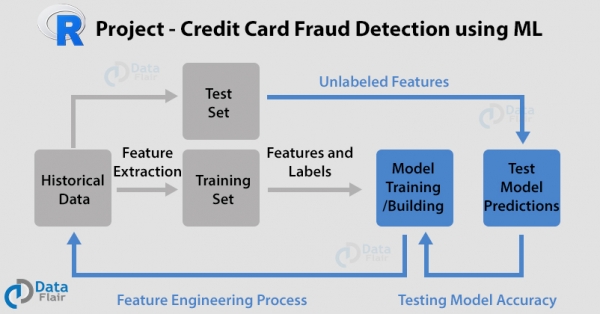
До момента сте започнали да разбирате методите и концепциите. Нека преминем към някои напреднали проекти в областта на науката за данни. В този проект ще използваме езика R с алгоритми като , логистична регресия, изкуствени невронни мрежи и класификатор на градиентно усилване. Ще използваме набор от данни за транзакции с карти, за да класифицираме кредитни транзакции като измамни и автентични. Ще подберем различни модели за тях и ще изградим криви на производителността.
Език: R
Набор от данни/Пакет: Набор от данни за транзакции с карти
11. Система за препоръки на филми
Изучете реализацията на най-добрия проект по Data Science с изходен код —
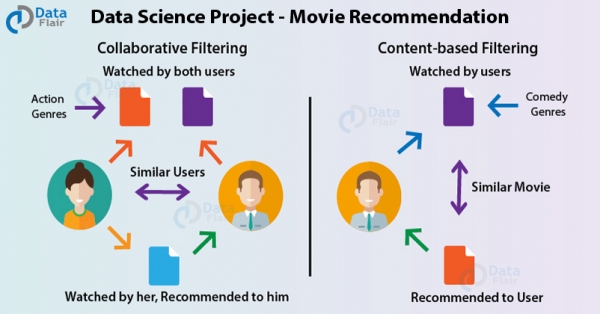
В този проект по Data Science ще използваме R, за да осъществим препоръки за филми чрез машинно обучение. Системата за препоръки изпраща предложения на потребителите чрез процес на филтриране, основан на предпочитанията на другите потребители и историята на гледане. Ако A и B обичат Home Alone, а B харесва Mean Girls, можем да предложим на A — че и на тях може да им хареса. Това позволява на клиентите да взаимодействат с платформата.
Език: R
Набор от данни/Пакет: Набор от данни MovieLens
12. Сегментация на клиентите
Впечатлете работодателите с проект по Data Science (включително изходен код) — .
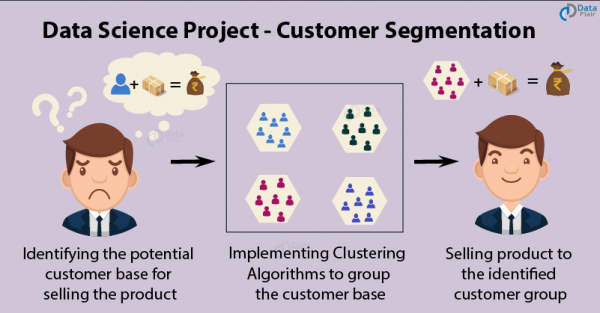
Сегментацията на клиентите е популярно приложение . Използвайки клъстеризация, компаниите определят сегменти на клиентите за работа с потенциална потребителска база. Те разделят клиентите на групи според общи характеристики, като пол, възраст, интереси и навици на разходване, за да могат ефективно да продават своите продукти на всяка група. Ще използваме , както и ще визуализираме разпределението по пол и възраст. След това ще анализираме техните годишни доходи и разходи.
Език: R
Набор от данни/Пакет: Набор от данни Mall_Customers
13. Класификация на рака на гърдата
Вижте пълната реализация на проекта по Data Science на Python — .
Връщайки се към медицинския принос на данните, нека научим как да откриваме рак на гърдата с Python. Ще използваме набора от данни IDC_regular, за да идентифицираме инвазивна карцином на млечния канал, най-разпространената форма на рак на гърдата. Той се развива в млечните канали, прониквайки в влакнестата или мастната тъкан на гърдата извън канала. В тази идея за научен проект по събиране на данни ще използваме и библиотеката Keras за класификация.
Език: Python
Набор от данни/Пакет: IDC_regular
14. Разпознаване на пътни знаци
Постигане на точност в технологията на самоуправляващите се автомобили с проект по Data Science за с отворен код.
Пътните знаци и правилата за движение са много важни за всеки шофьор, за да избегне инциденти. За да спазват правилото, първо трябва да разберат как изглежда пътният знак. Човек трябва да научи всички пътни знаци, преди да му бъдат дадени правата за управление на всяко превозно средство. Но сега броят на автономните превозни средства расте и в близкото бъдеще хората вероятно няма да управляват сами автомобилите. В проекта „Разпознаване на пътни знаци“ ще научите как програмата може да разпознае вида на пътните знаци, като приема изображение като входен сигнал. Използва се наборът от данни за разпознаване на пътните знаци в Германия (GTSRB) за изграждане на дълбока невронна мрежа за разпознаване на класа, към който принадлежи пътният знак. Създаваме и прост графичен интерфейс за взаимодействие с приложението.
Език: Python
Набор от данни: GTSRB (Бенчмарк за разпознаване на пътни знаци в Германия)
Прочетете още
Източник: habr.com
