

Периодично възниква нуждата на разработчика да предаде в заявката набор от параметри или дори цяла селекция на „входа“. Понякога срещаме много странни решения на тази задача.
Нека да започнем „от обратното“ и да видим как не трябва да се прави, защо и как можем да го направим по-добре.
Пряка „врезка“ на стойности в тялото на заявката
Обикновено изглежда така:
query = "SELECT * FROM tbl WHERE id = " + value… или така:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)За този метод има достатъчно написано, казано и :
Почти винаги това е пряк път към SQL инжекции и лишна тежест за бизнес логиката, която е принудена да „плете“ стринга на вашата заявка.
Отчасти такъв подход може да се оправдае само в случай на необходимост от използване на секциониране в версии на PostgreSQL 10 и по-стари за получаване на по-ефективен план. В тези версии списъкът на сканираните секции се определя още без оглед на предаваните параметри, само въз основа на тялото на заявката.
$n-параметри
Използването параметри — това е добре, позволява да се използват , намалявайки натоварването както на бизнес логиката (стринга на заявката се създава и предава само веднъж), така и на сървъра на БД (не е необходимо повторно парсиране и планиране за всеки екземпляр на заявката).
Променливо количество аргументи
Проблемите ще ни очакват, когато искаме да предадем предварително неизвестно количество аргументи:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Ако оставим заявката в такъв вид, то това, макар и да ни предпази от потенциални инжекции, все пак ще доведе до необходимост от събиране/парсиране на заявката за всеки вариант от броя на аргументите.. Вече е по-добре, отколкото да правим това всеки път, но може да се мине и без това.
Достатъчно е да предадем само един параметър, съдържащ сериализирано представяне на масив:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Единствената разлика е необходимостта явно да преобразуваме аргумента в необходимия тип масив. Но това не предизвиква проблеми, тъй като предварително знаем къде отиваме.
Предаване на селекция (матрица)
Обикновено това са всякакви варианти за предаване на набори данни за вмъкване в базата „за едно запитване“:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...В допълнение към описаните по-горе проблеми с „преклещането“ на заявката, това може да ни доведе и до out of memory и спада на сървъра. Причината е проста — под аргументите PG резервира допълнителна памет, а броят на записите в набора е ограничен само от бизнес логиката на приложенията. В особено клинични случаи сме били свидетели на «номерни» аргументи над $9000 — не е нужно така.
Ще пренапишем запитването, прилагайки вече «двустепенна» сериализация:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Да, в случай на «сложни» стойности в масива, те трябва да са обгърнати в кавички.
Разбира се, че по този начин може да се «развие» селекция с произволен брой полета.
unnest, unnest, …
Периодично се срещат варианти на предаване на вместо «масив от масиви» няколко «масива от колони», за които споменах. :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
С този метод, при грешка в генерирането на списъци със стойности за различни колони, е много лесно да получите напълно неочаквани резултати, зависещи също и от версията на сървъра:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Започвайки още от версия 9.3 в PostgreSQL се появиха пълноценни функции за работа с типа json. Затова, ако определението на входните параметри се случва в браузъра, можете направо там да формировате json-обект за SQL-запитването:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
За предишни версии такъв метод може да се използва за each(hstore), но коректната «свивка» с екраниране на сложни обекти в hstore може да създаде проблеми.
json_populate_recordset
Ако предварително знаете, че данните от «входния» json-масив ще отидат за попълване на някака таблица, можете значително да спестите в «разименуването» на полета и приведението им към нужните типове, използвайки функцията json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
А тази функция просто «развива» предадения масив от обекти в селекция, не разчитайки на формата на таблицата:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
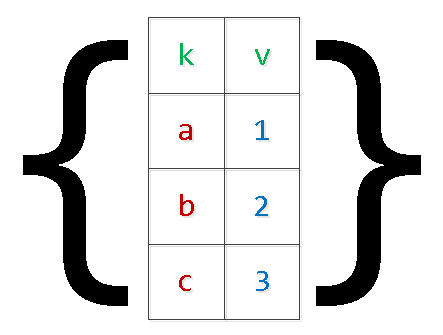
k | v
-----
a | 1
b | 2
TEMPORARY TABLE
Но ако обемът на данните в предаваната селекция е много голям, то да го вкарате в един сериализиран параметър — е трудно, а понякога и невъзможно, тъй като изисква еднократно отделяне на голям обем паметНапример, ако е необходимо да съберете голям пакет данни по събития от външна система за дълго време и след това да го обработите на страната на базата данни.
В такъв случай най-доброто решение би било използването на :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- повтаряйте много-много пъти
...
-- тук правим нещо полезно с цялата таблица
Този метод е важен за рядко предаване на големи обеми данни.
От гледна точка на описанието на структурата на данните, временното табло се различава от "обикновеното" само с един знак в системната таблица pg_class, а в pg_type, pg_depend, pg_attribute, pg_attrdef, … — и по никакъв начин.
Затова в уеб системите с голямо количество краткоживеещи връзки, всяка от тях ще генерира нови системни записи всеки път, които се изтриват с затварянето на връзката с базата данни. В крайна сметка, неконтролираното използване на TEMP TABLE води до "разширяване" на таблиците в pg_catalog и забавяне на много операции, които ги използват.
Разбира се, с това може да се бори с помощта на периодично преминаване през VACUUM FULL по таблиците на системния каталог.
Сесийните променливи
Да предположим, че обработката на данните от предишния случай е достатъчно сложна за една SQL заявка, но искаме да я правим често. Тоест, искаме да използваме процедурна обработка в , но използването на временни таблици за предаване на данни ще бъде твърде скъпо.
Също така не можем да използваме $n-параметри за предаване в анонимния блок. Решението идва от сесийните променливи и функцията current_setting.
До версия 9.2 беше необходимо предварително да се конфигурира custom_variable_classes за "собствените" сесийни променливи. В актуалните версии можете да напишете нещо подобно:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
В други поддържани процедурни езици можете да намерите и други решения.
Знаете ли и други методи? Споделете в коментарите!
Източник: habr.com
