

Здравейте, хабровчани. Днес стартират занятията в първата група на курса . Поради тази причина искаме да ви разкажем как премина откритият уебинар за този курс.
В говорихме за предизвикателствата, пред които са изправени SQL базите данни в ерата на облаците и Kubernetes. Също така разгледахме как SQL базите данни се приспособяват и мутират под влиянието на тези предизвикателства.
Уебинарът бе проведен от , мениджър по доставките на Google Cloud Practice в EPAM Systems.
Когато дърветата бяха малки…
Първо, нека си спомним как започна изборът на СУБД в края на миналия век. Това обаче не би било трудно, тъй като изборът на СУБД по онова време започваше и приключваше Oracle.
В края на 90-те — началото на 2000-те, реално нямаше особено разнообразие, ако говорим за индустриални мащабируеми БД. Да, имаше IBM DB2, Sybase и още няколко бази данни, които идваха и си отиваха, но като цяло те не бяха толкова забележими на фона на Oracle. Съответно, уменията на инженерите от онези времена се свързваха в известна степен с единствения избор, който съществуваше.
Oracle DBA трябваше да може:
- да инсталира Oracle Server от дистрибуцията;
- да конфигурира Oracle Server:
- init.ora;
- listener.ora;
— да създава:
- таблични пространства;
- схеми;
- потребители;
— да извършва резервно копиране и възстановяване;
— да осъществява мониторинг;
— да се бори с неоптималните запитвания.
В същото време от Oracle DBA не се изискваше особено:
- да умее да избира оптималната СУБД или друга технология за съхранение и обработка на данни;
- да осигурява висока наличност и хоризонтална мащабируемост (това не винаги беше въпрос на DBA);
- да знае добре предметната област, инфраструктурата, прикладната архитектура, ОС;
- да извършва зареждане и изтегляне на данни, миграция на данни между различни СУБД.
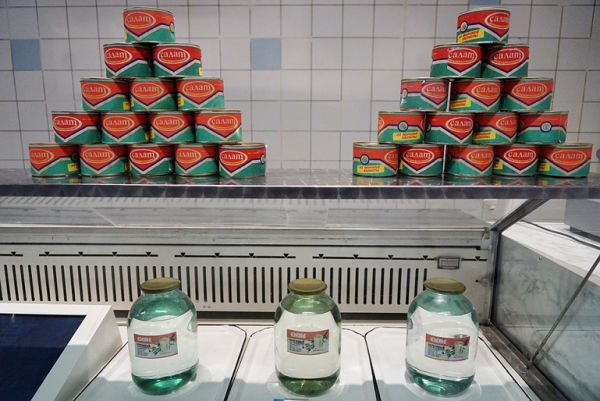
Като цяло, ако говорим за избора в онези времена, той напомня на избора в съветския магазин в края на 80-те:
Нашето време
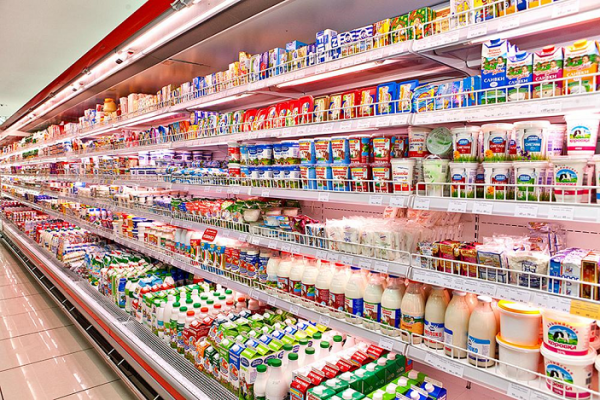
Оттогава, разбира се, дърветата пораснаха, светът се промени и стана така:
Промени се и пазарът на СУБД, което е очевидно от последния доклад на компания Gartner:
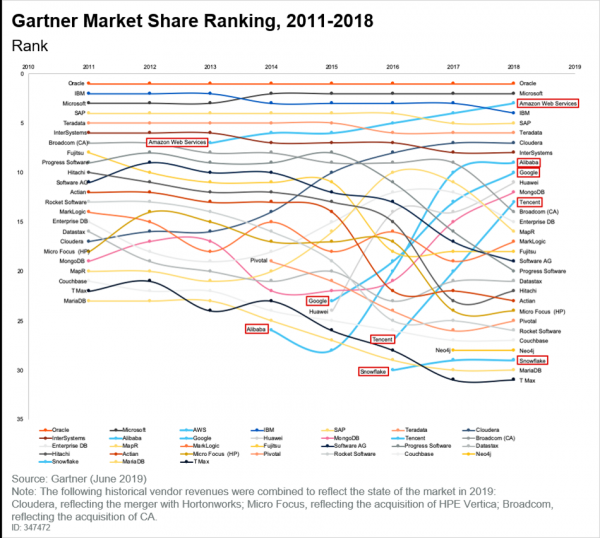
И тук не може да се не отбележи, че облаците заеха своята ниша, чиято популярност расте. Ако прочетем същия доклад на компания Gartner, ще видим следните изводи:
- Много клиенти са на път да мигрират приложенията си в облака.
- Новите технологии първо се появяват в облака и не е сигурно, че някога ще преминат в необлачна инфраструктура.
- Моделът на ценообразуване на принципа pay-as-you-go стана обичаен. Всички искат да плащат само за това, което използват, и това вече не е просто тренд, а просто констатация на факт.
Какво се случва сега?
Днес всички ние сме в облака. А въпросите, които имаме, са свързани с избора. А той е огромен, дори само ако говорим за избор на технологии за СУБД в On-premises формат. Освен това, имаме и managed services и SaaS. Така че, изборът става все по-сложен с всяка изминала година.
В допълнение към въпросите за избора, съществуват и ограничителни фактори:
- цена. Много технологии все още струват пари;
- навиги. Когато говорим за свободен софтуер, възниква въпросът за уменията, тъй като безплатният софтуер изисква от хората, които го инсталират и експлоатират, достатъчна компетентност;
- функционалност. Не всички услуги, които са налични в облака и са изградени, да кажем, дори на база на Postgres, разполагат с еднакви функции, каквито има Postgres On-premises. Това е съществен фактор, който трябва да знаем и разберем. Освен това, този фактор придобива по-голямо значение от познанието за някои скрити възможности на отделна СУБД.
Какво очакват в момента от DA/DE:
- доброто разбиране на предметната област и приложната архитектура;
- умението правилно да избират подходяща технология за СУБД, като се вземат предвид поставените задачи;
- умението да подбират оптималния метод за реализиране на избраната технология в контекста на наличните ограничения;
- умението да извършват пренос и миграция на данни;
- умението да реализират и експлоатират избраните решения.
Следният пример на база GCP демонстрира как е устроен изборът на определена технология за работа с данни в зависимост от тяхната структура:
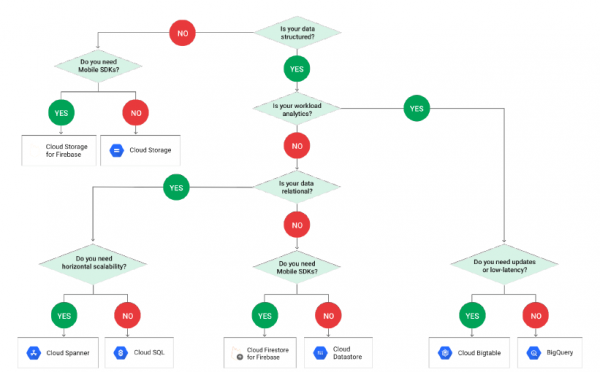
Обърнете внимание, че в схемата отсъства PostgreSQL, а причината е, че той се крие зад терминологията Cloud SQL. И когато попаднем в Cloud SQL, отново трябва да направим избор:
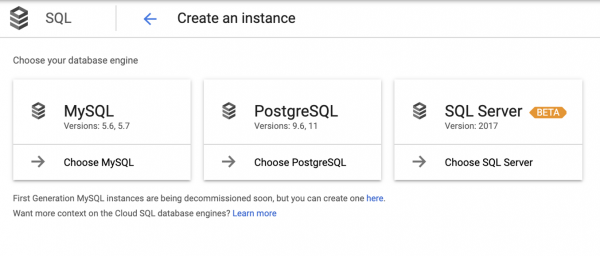
Трябва да се отбележи, че този избор не винаги е прозрачен, затова разработчиците на приложения често се ръководят от интуиция.
В обобщение:
- С все по-актуален става въпросът за избора. И дори ако разглеждаме само GCP, управляемите услуги и SaaS, някакво споменаване на РСУБД се появява едва на 4-та стъпка (а там е и Spanner). Плюс, изборът на PostgreSQL се появява изобщо на 5-та стъпка, а до него са MySQL и SQL Server, тоест има много опции, а изборът е наложителен.
- Не бива да забравяме и ограниченията зад изкушенията. По принцип, всички искат Spanner, но той е скъп. В крайна сметка типичната заявка изглежда така: „Моля, направете ни Spanner, но на цената на Cloud SQL, вие сте професионалисти!“
А какво да правим?
Без да претендираме за последна инстанция, ще кажем следното:
Необходимо е да променим подхода към обучението:
- да учим така, както учехме DBA преди, няма смисъл;
- знанията за един продукт вече не са достатъчни;
- а да знаеш десетки на нивото на един — е невъзможно.
Трябва да знаем не само продукта, а:
- практиката на неговото приложение;
- различните методи за внедряване;
- предимствата и недостатъците на всеки от методите;
- аналогични и алтернативни продукти, за да направим осъзнат и оптимален избор, а не винаги в полза на познатия продукт.
А също така трябва да можем да мигрираме данни и да разбираме основните принципи на интеграция с ETL.
Реален случай
В недалечен минал период ми се наложи да направя бекенд за мобилно приложение. Когато започнах работа по него, бекендът вече беше разработен и готов за внедряване, а екипът от разработчици беше прекарал около две години в този проект. Освен това бяха поставени следните задачи:
- да изградим CI/CD;
- да направим преглед на архитектурата;
- да пуснем всичко в експлоатация.
Самото приложение беше микросервисно, а кодът на Python/Django беше разработен от нулата и веднага в GCP. Що се отнася до целевата аудитория, се предполага, че ще има два региона — САЩ и ЕС, а трафикът се разпределяше чрез Global Load Balancer. Всички Workloads и изчислителна натовареност работеха в Google Kubernetes Engine.
Що се отнася до данните, имаше 3 структури:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
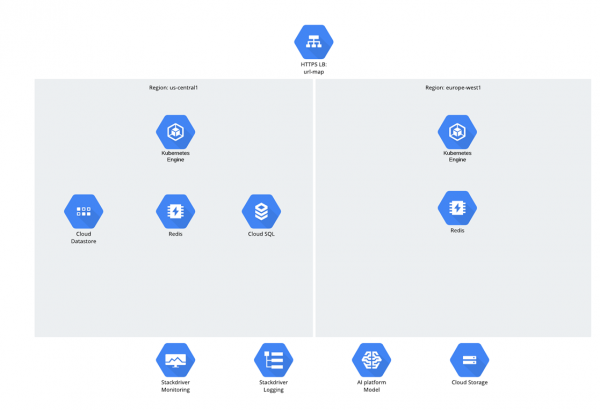
Може да възникне въпросът, защо избрахме Cloud SQL? Честно казано, такъв въпрос през последните години предизвиква някаква неловка пауза — създава се усещането, че хората започнаха да се стесняват от релационни бази, но въпреки това те продължават да ги използват активно ;-).
Що се отнася до нашия случай, Cloud SQL беше избран по следните причини:
- Както беше споменато, приложението беше разработено с Django, а в него има модел за представяне на постоянни данни от SQL база в Python обекти (Django ORM).
- Самият фреймуърк поддържаше достатъчно ограничен списък от СУБД:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Съответно, PostgreSQL беше избран от този списък по-скоро интуитивно (в действителност не е нужно да се избира Oracle).
Какво не достига:
- приложението беше разположено само в 2 региона, а в плановете се появи 3-ти (Азия);
- БД се намираше в северноамериканския регион (Айова);
- от страна на клиента имаше опасения относно възможните забавяния в достъпа от Европа и Азия и проблеми в обслужването в случай на спиране на СУБД.
При положение, че самият Django може да работи с няколко БД паралелно и да ги разделя по четене и писане, записите в приложението не бяха толкова много (повече от 90 % — четене). И в общи линии, ако можеше да се създаде read реплика на основната база в Европа и Азия, това щеше да бъде компромисен вариант за решение. Но какво толкова сложно има?
Но трудността се заключаваше в това, че клиентът не искаше да се откаже от използването на управлявани услуги и Cloud SQL. А възможностите на Cloud SQL в момента са ограничени. Cloud SQL поддържа висока наличност (HA) и read replica (RR), но RR се поддържа само в един регион. Създавайки БД в американския регион, не може да се направи read реплика в европейския регион с помощта на Cloud SQL, въпреки че самият PostgreSQL не го пречи. Кореспонденцията с служителите на Google не доведе до нищо и завърши с обещания в стил „знаем проблема и работим по него, един ден въпросът ще бъде решен “.
Ако изброим възможностите на Cloud SQL в постове, то те могат да изглеждат приблизително така:
1. Висока наличност (HA):
- в рамките на един регион;
- чрез дискова репликация;
- не се използват механизми на PostgreSQL;
- възможно автоматично и ръчно управление — failover/failback;
- при превключване СУБД не е на разположение в продължение на няколко минути.
2. Read Replica (RR):
- в рамките на един регион;
- горещо резервиране;
- поточно репликиране на PostgreSQL.
Освен това, както е обичайно, при избора на технология винаги се сблъскваш с някакви ограничения,:
- клиентът не искаше да създава същности и да използва IaaS, освен през GKE;
- клиентът не искаше да разгръща self service PostgreSQL/MySQL;
- А и изобщо, Google Spanner би бил напълно подходящ, ако не беше цената му, истина е, че с него Django ORM не може да работи, но така или иначе е хубаво нещо.
С оглед на ситуацията, от клиента дойде въпрос за заспиване: „Можете ли да направите нещо подобно, за да бъде като Google Spanner, но да работи и с Django ORM?“
Вариант за решение № 0
Първото, което ми дойде на ума:
- да останем в рамките на CloudSQL;
- вградена репликация между регионите няма да бъде достъпна по никакъв начин;
- да опитам да добавя реплика към съществуващ Cloud SQL by PostgreSQL;
- някъде и по някакъв начин да стартирам инстанс на PostgreSQL, но поне master да не пипам.
Уви, оказа се, че не може да се направи така, тъй като няма достъп до хоста (той изобщо е в друг проект) — pg_hba и така нататък, а пък и нямам достъп като superuser.
Вариант за решение № 1
След поредните размисли и с оглед на предишните обстоятелства разсъжденията се промениха:
- все още се опитваме да останем в рамките на CloudSQL, но преминаваме на MySQL, тъй като Cloud SQL by MySQL има външен master, който:
— е прокси за външен MySQL;
— изглежда като инстанс MySQL;
— е създаден за миграция на данни от други облаци или On-premises.
Тъй като конфигурацията на репликация за MySQL не изисква достъп до хоста, всичко работеше, но беше много нестабилно и неудобно. А когато продължихме, стана направо страшно, тъй като цялата структура се развиваше с terraform'а, а изведнъж се оказа, че външният master не се поддържа от terraform. Да, Google има CLI, но по някаква причина всичко работеше на етапи — понякога се създава, понякога не. Може би, защото CLI бе създаден за миграция на данни отдалеч, а не за реплики.
Собствено, по това стана ясно, че Cloud SQL не е подходящо от нито една страна. Както казват, направихме всичко, което можахме.
Вариант за решение № 2
Тъй като не успяхме да останем в рамките на Cloud SQL, опитахме се да формулираме изискванията за компромисно решение. Изискванията се оказаха следните:
- работа в Kubernetes, максимално използване на ресурсите и възможностите на Kubernetes (DCS, …) и GCP (LB, …);
- липса на ненужен товар от куп ненужни неща в облака, като HA proxy;
- възможност за стартиране на основен регион HA PostgreSQL или MySQL; в останалите региони — HA от RR на основния регион плюс нейно копие (за надеждност);
- multi master (не исках да се свързвам с него, но това не беше много принципно)
.
В резултат на тези изисквания на хоризонта най-накрая се появиха пподходящи варианти СУБД и обвързки:
- MySQL Galera;
- CockroachDB;
- инструменти за PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
Технологията MySQL Galera е разработена от Codership и представлява плъгин за InnoDB. Характеристики:
- мулти мейстър;
- синхронна репликация;
- четене от всякакъв узел;
- запис на всеки узел;
- вграден механизъм HA;
- има Helm chart от Bitnami.
CockroachDB
По описание, нещото е напълно впечатляващо и представлява open source проект, написан на Go. Основен участник е Cockroach Labs (основана от бивши служители на Google). Тази релационна СУБД е създадена да бъде разпределена (с хоризонтално мащабиране „от кутията“) и устойчива на сривове. Авторите на компанията са поставили за цел да „съчетават богатството на функционалността на SQL с хоризонталната достъпност, характерна за NoSQL решенията.“
От приятните бонуси — поддръжка на PostgreSQL протокол за свързване.
Pgpool
Това е надстройка над PostgreSQL, по същество нова същност, която поема всички свързвания и ги обработва. Има собствено натоварващо балансиращо устройство и парсер, лицензирана е под BSD лиценз. Предоставя широки възможности, но изглежда малко плашещо, тъй като наличието на нова същност може да стане източник на допълнителни приключения.
Patroni
Това е последното, на което попаднах, и както се оказа, не напразно. Patroni е open source утилита, която по същество представлява демон на Python, позволяваща автоматично управление на клъстери PostgreSQL с различни типове репликация и автоматично превключване на роли. Необходимостта от нея се оказа много интересна, тъй като тя добре се интегрира с Kubernetes и не носи нови същности.
Какво накрая избрахме
Изборът не беше лесен:
- CockroachDB — страхотно, но доста рисково;
- MySQL Galera — също не лошо, много се използва, но MySQL;
- Pgpool — много излишни същности, интеграцията с облака и K8s е средна;
- Patroni — прекрасна интеграция с K8s, няма излишни същности, добре се интегрира с GCP LB.
Така че, изборът падна на Patroni.
Изводи
Време е да подведем кратки заключения. Да, светът на ИТ инфраструктурата се е променил значително, и това е само началото. И ако преди облаците бяха просто друг тип инфраструктура, то сега всичко е различно. Освен това, иновациите в облаците непрекъснато се появяват, ще продължат да се появяват и, възможно, те ще се появяват само в облаците и само след това, с усилията на стартъпите, ще бъдат прехвърляни в On-premises.
По отношение на SQL, SQL ще продължи да съществува. Това означава, че е необходимо да знаете и да работите с PostgreSQL и MySQL, но по-важно е да знаете как да ги прилагате правилно.
Източник: habr.com
