

Здравей, Хабр!
Работаю в екипа на Tinkoff, който разработва собствен център за уведомления. Основно разработвам на Java, използвайки Spring Boot, и решавам различни технически проблеми, възникващи в проекта.
Повечето от нашите микросервиси комуникират помежду си асинхронно чрез брокер за съобщения. Преди това използвахме IBM MQ като брокер, който вече не можеше да се справя с натоварването, но в същото време предлагаше високи гаранции за доставка.
Като замяна ни предложиха Apache Kafka, която разполага с високи възможности за скалиране, но за съжаление изисква практически индивидуален подход към конфигурирането за различни сценарии. Освен това, механизмът за доставка поне веднъж, който работи в Kafka по подразбиране, не позволява да се поддържа необходимото ниво на консистентност от самото начало. По-долу ще споделя нашия опит с конфигурирането на Kafka, по-скоро ще разкажа как да настроим и да живеем с точно веднъж доставка.
Гарантирана доставка и не само
Параметрите, които ще разгледаме по-долу, ще помогнат да се предотвратят редица проблеми с настройките по подразбиране за свързване. Но първо искам да обърна внимание на един параметър, който ще улесни евентуалното отстраняване на проблеми.
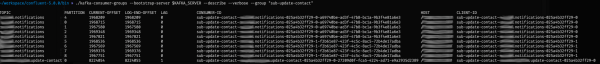
В това ще помогне client.id за Producer и Consumer. На пръв поглед, за стойност може да се използва името на приложението, и в повечето случаи това ще сработи. Въпреки това, ситуация, при която приложението използва няколко Consumer’а и им задавате еднакъв client.id, води до следното предупреждение:
org.apache.kafka.common.utils.AppInfoParser — Error registering AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Ако искате да използвате JMX в приложение с Kafka, това може да създаде проблем. За този случай е най-добре да използвате комбинация от името на приложението и, например, името на топика за стойността на client.id. Резултатът от нашата конфигурация може да се види в изхода на командата kafka-consumer-groups от инструментите на Confluent:
Сега да разгледаме сценария за гарантирана доставка на съобщение. Kafka Producer има параметър acks, който позволява настройка, след колко acknowledgment лидерът на клъстера трябва да считат съобщението за успешно записано. Този параметър може да приеме следните стойности:
- 0 — acknowledgment няма да се считат.
- 1 — параметър по подразбиране, необходим е acknowledgment само от 1 реплика.
- −1 — необходим е acknowledge от всички синхронизирани реплики (настройка на кластера min.insync.replicas).
От изброените стойности е видно, че acks равен −1 дава най-силните гаранции, че съобщението няма да бъде загубено.
Както всички знаем, разпределените системи не са надеждни. За да се защитим от временни неизправности, Kafka Producer предлага параметър retries, който позволява задаването на броя опити за повторно изпращане в рамките на delivery.timeout.ms. Тъй като параметърът retries има по подразбиране стойност Integer.MAX_VALUE (2147483647), броят на повторните изпращания на съобщения може да се регулира, като се променя само delivery.timeout.ms.
Преминаваме към точно веднъж доставка
Изброените настройки позволяват на нашия Producer да доставя съобщения с висока гаранция. Нека сега поговорим за това как да гарантираме записването на само едно копие на съобщение в Kafka топик? В най-простия случай за целта на Producer трябва да се зададе параметър enable.idempotence на стойност true. Идемпотентността гарантира записването само на одно съобщение в конкретна партиция на един топик. Предварителното условие за включване на идемпотентността са стойностите acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. Ако тези параметри не са зададени от разработчика, то автоматично ще бъдат зададени посочените по-горе стойности.
Когато идемпотентността е настроена, е необходимо да се постигне така, че идентични съобщения да попадат всеки път в същите партиции. Това може да се направи, настройвайки ключа и параметъра partitioner.class на Producer. Нека започнем с ключа. За всяко изпращане той трябва да бъде един и същ. Това е лесно постижимо, използвайки някакъв бизнес идентификатор от оригиналното съобщение. Параметърът partitioner.class има по подразбиране стойност — . При тази стратегия за партициониране по подразбиране действаме така:
- Ако партицията е явно зададена при изпращането на съобщението, то я използваме.
- Ако партицията не е указана, но ключът е указан — избираме партицията по хеш от ключа.
- Ако партицията и ключът не са указани — избираме партиции по ред (round-robin).
Освен това, използването на ключа и идемпотентно изпращане с параметър max.in.flight.requests.per.connection = 1 предоставя ви организирана обработка на съобщения в Consumer. Отделно е важно да запомните, че если в кластера ви Kafka е настроено управление достъпа, ще ви трябват права за идемпотентно записване в темата.
Ако случайно ви липсват възможностите за идемпотентно изпращане по ключ или логиката от страната на Producer изисква поддържане на последователност на данните между различни партиции, транзакциите ще ви дойдат на помощ. Освен това, с помощта на верижна транзакция можете условно да синхронизирате запис в Kafka, например, с запис в база данни. За да активирате транзакционно изпращане на Producer, той трябва да притежава идемпотентност и допълнително да зададете transactional.id. Ако в кластерът ви Kafka е настроено управление на достъпа, то и за транзакционния запис, както и за идемпотентния, ще са необходими права за запис, които могат да бъдат предоставени чрез маска, използваща стойността, съхранявана в transactional.id.
Формално, като идентификатор на транзакция можете да използвате всяка низ, например името на приложението. Но ако стартирате няколко инстанции на едно и също приложение с идентичен transactional.id, първата стартирана инстанция ще бъде спряна с грешка, тъй като Kafka ще я считат за зомби-процес.
org.apache.kafka.common.errors.ProducerFencedException: Producer в опита да направи операция с стара епоха. Или има нов Producer с същия transactionalId, или транзакцията на Producer е изтекла от брокера.За да решим този проблем, добавяме към името на приложението суфикс под формата на името на хоста, което получаваме от променливите на средата.
Producer е настроен, но транзакциите в Kafka управляват само обхвата на видимост на съобщението. Независимо от статуса на транзакцията, съобщението веднага попада в темата, но притежава допълнителни системни атрибути.
За да не бъдат такива съобщения прочетени от Consumer преди време, той трябва да зададе параметъра isolation.level на стойност read_committed. Такъв Consumer ще може да чете нетранзакционни съобщения както и преди, а транзакционни — само след комит.
Ако сте задали всички изброени по-горе настройки, тогава сте конфигурирали exactly once delivery. Поздравления!
Но има още един нюанс. Transactional.id, който настряхме по-горе, всъщност е префикс на транзакцията. Към него на мениджъра на транзакции се добавя пореден номер. Полученият идентификатор се издава на transactional.id.expiration.ms, който се конфигурира на кластер Kafka и има стойност по подразбиране „7 дни“. Ако в този период приложението не е получавало съобщения, при опит за следващото транзакционно изпращане ще получите InvalidPidMappingException. След това координаторът на транзакциите ще издаде нов последователен номер за следващата транзакция. При това съобщението може да бъде загубено, ако InvalidPidMappingException не бъде обработен правилно.
Вместо обобщения
Както можете да видите, не е достатъчно просто да изпращате съобщения в Kafka. Трябва да избирате комбинация от параметри и да бъдете готови за бързи промени. В тази статия се опитах детайлно да покажа настройката за exactly once delivery и описах няколко проблема с конфигурациите client.id и transactional.id, с които се сблъскахме. По-долу в кратка форма са представени настройките на Producer и Consumer.
Producer:
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — за подредено изпращане)
- transactional.id = ${application-name}-${hostname}
Consumer:
- isolation.level = read_committed
За да минимизираме грешките в бъдещите приложения, направихме собствена обвивка около spring-конфигурацията, където вече са зададени стойности за някои от посочените параметри.
А ето и няколко материала за самостоятелно изучаване:
Източник: habr.com
