

2019 година измина, а ние все още нямаме стандартно решение за агрегиране на логове в Kubernetes. В тази статия бихме искали, използвайки примери от практиката, да споделим търсенията си, срещнатите проблеми и техните решения.
Но първо, трябва да уточня, че различните клиенти разбират под събиране на логове много различни неща:
- някой иска да вижда security и audit логове;
- някой — централизирано логиране на цялата инфраструктура;
- а на някой му е достатъчно да събира само логовете на приложението, изключвайки, например, балансировките.
За това как реализирахме различните "желания" и с какви трудности се сблъскахме — под кат.
Теория: за инструментите за логове
Предистория за компонентите на системата за логиране
Логиране е преминало дълъг път, в резултат на който се развиха методологии за събиране и анализ на логове, които ние прилагаме и днес. Още през 50-те години на 20-ти век във Fortran се появи аналог на стандартните потоци за вход и изход, които помагаха на програмистите при отстраняване на грешки в техните програми. Това бяха първите компютърни логове, които облекчаваха живота на програмистите от онова време. Днес виждаме в тях първия компонент на системата за логиране — източник или "производител" (producer) на логове.
Компютърните науки не стояха на място: появиха се компютърни мрежи, първите клъстери… Започнаха да работят сложни системи, състоящи се от няколко компютъра. Сега системните администратори трябваше да събират логове от няколко машини, а в особени случаи можеха да добавят и съобщения от ядрото на операционната система, ако възникнеше необходимост за разследване на системен срив. За да опишат системите за централизирано събиране на логове, в началото на 2000-те години излезе , който стандартизира remote_syslog. Така се появи още един важен компонент: колектор (сборщик) на логове и тяхното хранилище.
С увеличаването на обема на логовете и навлизането на уеб технологиите се постави въпросът за удобното извеждане на логовете за потребителите. На мястото на простите конзолни инструменти (awk/sed/grep) дойдоха по-напреднали преглеждачи на логове — трети компонент.
В контекста нарастващия обем на логовете стана ясно и нещо друго: логовете са необходими, но не всички. Освен това различните логове изискват различно ниво на съхранение: единични могат да се загубят след един ден, докато други трябва да се съхраняват 5 години. Така в системата за логиране бе добавен компонент за филтриране и маршрутизиране на данните — да го наречем филтър.
Складовете също направиха значителен скок: от обикновени файлове преминаха на релационни бази данни и след това на документоориентирани хранилища (например, Elasticsearch). Така от колектор се отдели хранилище.
В крайна сметка, самото понятие лог се разшири до нещо като абстрактен поток от събития, които желаем да съхраняваме за историята. По-точно — в случай, че е необходимо да проведем разследване или да съставим аналитичен отчет…
В резултат, за сравнително кратък период от време, събирането на логове се разви в важна подсистема, която с право може да се нарече един от подразделите в Big Data.
Ако някога обикновените print’ове бяха достатъчни за "система за логиране", то сега ситуацията се е променило значително.
Kubernetes и логовете
Когато в инфраструктурата дойде Kubernetes, съществуващият проблем за събиране на логове не заобиколи и него. В известен смисъл той стана дори по-болезнен: управлението на инфраструктурната платформа бе не само опростено, но и същевременно усложнено. Много стари услуги започнаха миграция към микросервизни пътища. В контекста на логовете това се изрази в увеличаващия се брой на източниците на логове, техния специален жизнен цикъл и необходимостта да се следят чрез логовете взаимовръзките на всички компоненти на системата…
Поглеждайки напред, мога да потвърдя, че в момента, за съжаление, няма стандартизиран вариант на логиране за Kubernetes, който да се отличава положително от всички останали. Най-популярните в общността схеми се свеждат до следните:
- някой разгръща стек EFK (Elasticsearch, Fluentd, Kibana);
- някой — опитва наскоро издадения или използва ;
- нас (а може би и не само нас?..) до голяма степен удовлетворява собствената разработка — …
Обикновено използваме такива комбинации в K8s клъстери (за self-hosted решения):
- ;
- .
Но няма да се спирам на инструкциите за инсталиране и конфигуриране. Вместо това, ще се фокусирам върху недостатъците и по-глобалните изводи за ситуацията с логовете като цяло.
Практика с логовете в K8s
„Всекидневни логове“, колко много сте вие?..
Централизираното събиране на логове от достатъчно голяма инфраструктура изисква значителни ресурси, които ще отидат за събиране, съхранение и обработка на логовете. В хода на експлоатацията на различни проекти се сблъскахме с различни изисквания и произтичащите от тях проблеми.
Ще опитаме ClickHouse
Нека разгледаме централизирано хранилище на проект с приложение, което генерира логове доста активно: над 5000 реда в секунда. Ще започнем работа с неговите логове, съхранявайки ги в ClickHouse.
Веднъж когато е необходим максимален реален времеви контрол, 4-ядреният сървър с ClickHouse вече ще бъде натоварен по дисковата подсистема:
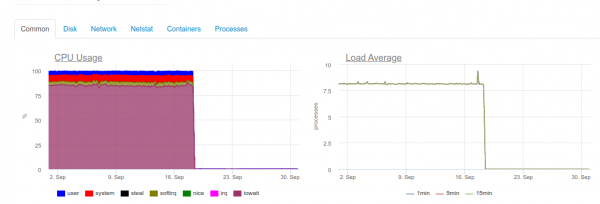
Такъв тип натоварване е свързано с това, че се опитваме да пишем максимално бързо в ClickHouse. И базата данни реагира на това с повишено дисково натоварване, поради което може да се появят следните грешки:
DB::Exception: Прекалено много части (300). Сливането се обработва значително по-бавно от вмъкванията
Работата е там, че в ClickHouse (в които са данните от логовете) имат своите предизвикателства при операциите за запис. Вмъкнатите данни генерират временно партициониране, което след това се слива с основната таблица. В резултат на това, записът става много изискуващ към диска, а също така се прилага ограничение, за което получихме уведомление по-горе: в 1 секунда могат да се слеят не повече от 300 субпартиции (фактически това са 300 вмъквания в секунда).
За да избегнем такова поведение, възможно най-големи парчета и не по-често от 1 път на 2 секунди. Въпреки това, записването на големи пакети предполага, че трябва да пишем по-рядко в ClickHouse. Това, от своя страна, може да доведе до препълване на буфера и загуба на логове. Решението е да увеличим буфера на Fluentd, но тогава ще се увеличи и потреблението на памет.
Забележка: Друга проблемна страна на нашето решение с ClickHouse беше свързана с това, че партиционирането в нашия случай (loghouse) е реализирано чрез външни таблици, свързани . Това води до ненужно голямо време за изпълнение при извличане на големи времеви интервали, тъй като метатаблицата преглежда всички партиции – дори тези, които сигурно не съдържат необходимите данни. Въпреки това, този подход може спокойно да бъде обявен за остарял за актуалните версии на ClickHouse (c ).
В крайна сметка става ясно, че за събиране на логове в реално време в ClickHouse ресурсите не са достатъчни за всеки проект (по-точно, разпределението им няма да бъде целесъобразно). Освен това ще е необходимо да се използва акумулатор, до който ще се върнем по-късно. Описаният по-горе случай е реален. И в този момент не можахме да предложим надеждно и стабилно решение, което да удовлетворява клиента и да позволява събиране на логовете с минимално закъснение…
А Elasticsearch?
Известно е, че Elasticsearch се справя с големи натоварвания. Ще го опитаме в същия проект. Сега натоварването изглежда по следния начин:
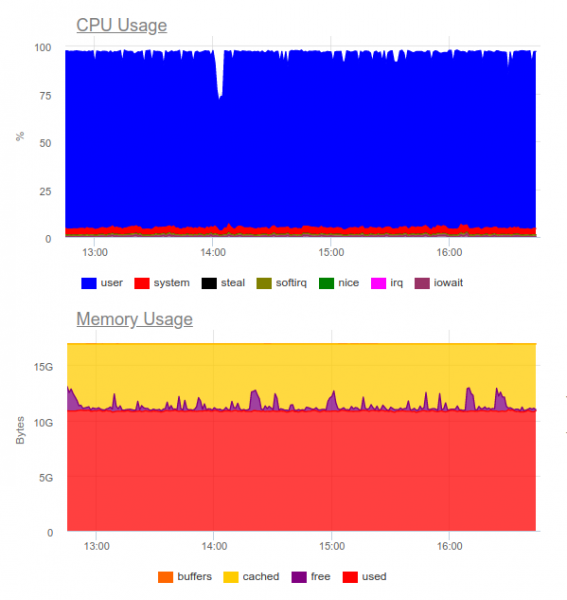
Elasticsearch успя да обработи потока от данни, но записването на такива обеми в него силно натоварва CPU. Това се решава с организиране на кластер. Чисто технически, това не е проблем, но ще се окаже, че само за работа на системата за събиране на логове вече използваме около 8 ядра и имаме допълнителен високо натоварен компонент в системата…
Резултат: такъв вариант може да бъде оправдан, но само в случай, че проектът е голям и неговото ръководство е готово да вложи значителни ресурси в системата за централизирано логиране.
Тогава възниква закономерният въпрос:
Кои логове наистина са необходими?
 Нека опитаме да променим самия подход: логовете трябва едновременно да бъдат информативни и да не покриват всяко събитие в системата.
Да предположим, че имаме преуспяваща интернет-магазин. Кои логове са важни? Да събираме максимално количество информация, например, от платежния шлюз – отлична идея. А обаче от услугата за рязане на изображения в каталога на продуктите, ни интересуват не всички логове: достатъчни са само грешки и разширен мониторинг (например, на процента от 500-те грешки, които генерира този компонент).
Ето, стигаме до извода, че централизираното логиране не винаги е оправдано. Много често клиентът иска да събере всички логове на едно място, въпреки че всъщност от всички логове са необходими само условни 5% съобщения, които са критични за бизнеса:
- Понякога е достатъчно да настроите, да речем, само размера на контейнерния лог и събирателя на грешки (например, Sentry).
- За разследването на инциденти често може да е достатъчно известието за грешка и всъщност голям локален лог.
- Имахме проекти, които се справяха изцяло само с функционални тестове и системи за събиране на грешки. На разработчика не му бяха необходими логове, за да види всичко по трасетата на грешките.
Илюстрация от живота
Добър пример може да бъде друга история. Получихме запитване от екипа по сигурността на един от клиентите, който вече използваше търговско решение, разработено още преди внедряването на Kubernetes.
Беше необходимо да 'сдружим' системата за централизирано събиране на логове с корпоративния датчик за откриване на проблеми — QRadar. Тази система може да приема логове по протокол syslog и да извлича файлове по FTP. Въпреки това, интегрирането ѝ с плъгина remote_syslog за fluentd не се получи веднага. (както се оказа, ). Проблемите с настройката на QRadar се оказаха от страна на екипа по сигурността на клиента.
В резултат част от логовете, критични за бизнеса, бяха качвани на FTP QRadar, а другата част — пренасочваха по remote syslog директно от възлите. За това дори написахме — може би, той ще помогне на някого да реши аналогичен проблем… Благодарение на получената схема, клиентът сам получаваше и анализираше критични логове (с помощта на любимите си инструменти), а ние успяхме да намалим разходите за системата за логване, запазвайки само последния месец.
Още един пример показва как не трябва да се прави. Един от нашите клиенти за обработка на всеки събития, постъпващи от потребителя, правеше многоредов неструктуриран изход на информация в лога. Както лесно може да се досетите, подобни логове бяха изключително неудобни за четене и съхранение.
Критерии за логове
Подобни примери водят до заключението, че освен избора на система за събиране на логове трябва да проектирим и самите лога!Какви са изискванията тук?
- Логовете трябва да се съхраняват в машиночитаем формат (например, JSON).
- Логовете трябва да бъдат компактни и с възможност за промяна на степента на логване, за да отстранят евентуални проблеми. При това в production среди трябва да се стартират системи с ниво логване подобно на Предупреждение или Грешка.
- Логовете трябва да бъдат нормализирани, тоест всяка линия в обекта на логовете трябва да има един и същ тип поле.
Неструктурираните логове могат да доведат до проблеми с зареждането на логовете в хранилище и до пълно спиране на тяхната обработка. За илюстрация — пример с грешка 400, с която много хора вероятно са се сблъсквали в логовете на fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
Грешката означава, че изпращате към индекса поле, типът на което е нестабилен. Най-простият пример — поле в логовете на nginx с променлива $upstream_status. В него може да има както число, така и низ. Например:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staffs/265.png", "protocol": "HTTP/1.1", "status": "200", "body_size": "906", "referrer": "https://example.com/staff", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staff", "protocol": "HTTP/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
В логовете се вижда, че сървърът 10.100.0.10 е отговорил с грешка 404 и заявката е изпратена към друго хранилище на съдържание. В резултат, в логовете стойността стана следната:
"upstream_response_time": "0.001, 0.007"
Тази ситуация е толкова разпространена, че дори е получила отделно .
А какво стана с надеждността?
Има случаи, когато е жизненоважно да имате всички логове без изключение. И при типичните схеми за събиране на логове за K8s, предложени / разглеждани по-горе, има проблеми.
Например, fluentd не може да събира логове от краткоживеещи контейнери. В един от нашите проекти контейнерът с миграция на бази данни е живял по-малко от 4 секунди и след това е бил изтрит — според съответната анотация:
"helm.sh/hook-delete-policy": hook-succeeded
Поради това логът на изпълнението на миграцията не е попадал в хранилището. В този случай може да помогне политиката before-hook-creation.
Друг пример — ротацията на логовете на Docker. Да речем, че има приложение, което активно записва в логовете. При нормални условия успяваме да обработим всички логове, но щом възникне проблем — например, както беше описано по-горе с неправилния формат — обработката спира, а Docker ротира файла. Резултатът — критични за бизнеса логове могат да бъдат загубени.
Затова важно е да се разделят потоковете на логовете, вграждането на изпращането на най-ценните директно в приложението, за да се осигури тяхната безопасност. Освен това, не би било излишно създаването на някакъв «акумулатор» на логове, който да може да преодолее кратка недостъпност на хранилището при запазване на критичните съобщения.
Накрая, не бива да забравяме, че всяка подсистема е важно качествено да се наблюдава. В противен случай лесно може да се сблъскате със ситуация, в която fluentd е в състояние CrashLoopBackOff и не изпраща нищо, а това предвещава загуба на важна информация.
Изводи
В тази статия не разглеждаме SaaS решения като Datadog. Много от описаните тук проблеми вече са разрешени от търговски компании, специализирани в събирането на логове, но не всички могат да използват SaaS по различни причини. (основните са цената и спазването на 152-ФЗ).
Централизираното събиране на логове първоначално изглежда като проста задача, но всъщност такава не е. Важно е да помним, че:
- Логването в детайли е разумно само за критични компоненти, а за останалите системи може да се настрои мониторинг и събиране на грешки.
- Логовете в production трябва да бъдат минимални, за да не натоварват излишно системата.
- Логовете трябва да са машинно четими, нормализирани и да имат строг формат.
- Наистина критичните логове трябва да се изпращат по отделен поток, който да е отделен от основните.
- Струва си да се помисли за акумулатор на логове, който може да спаси от пикове на натоварване и да направи натоварването на хранилището по-равномерно.
Тези прости правила, ако се прилагат навсякъде, биха позволили описаните по-горе схеми да работят – дори въпреки липсата на важни компоненти (акумулатора). Ако обаче не се придържате към такива принципи, задачата лесно ще доведе вас и инфраструктурата до още един високо натоварен (и в същото време малко ефективен) компонент на системата.
P.S.
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
