

Здравей, Хабр! Наборите данни за Big Data и машинното обучение нарастват експоненциално и трябва да успеем да ги обработваме. Нашият пост е за още една иновационна технология в сферата на високопроизводителните изчисления (HPC, High Performance Computing), показана на щанда на Kingston на . Това е прилагане на Hi-End системи за съхранение на данни (СХД) в сървъри с графични процесори (GPU) и технологията GPUDirect Storage. Благодарение на директния обмен на данни между СХД и GPU, заобикаляйки CPU, значително се ускорява зареждането на данни в GPU-ускорители, така че приложенията Big Data работят на максималната производителност, която предлагат GPU. От своя страна, разработчиците на HPC-системи се интересуват от постиженията в областта на СХД с изключителна скорост на вход/изход — каквито предлага Kingston.
Производителността на GPU надминава зареждането на данни
Откакто през 2007 година беше създадена CUDA — софтуерно-апаратна архитектура за паралелни изчисления на базата на GPU за разработване на приложения за обща цел, хардуерните възможности на самите GPU нараснаха невероятно. Днес GPU се прилагат все повече в областта на HPC-приложения, като големи данни (Big Data), машинно обучение (ML, machine learning) и дълбочинно изучаване (DL, deep learning).
Нека да отбележим, че въпреки сходството на термините, последните два представляват алгоритмично различни задачи. ML обучава компютъра на базата на структурирани данни, докато DL – на базата на отговор от невронна мрежа. Примерът, който помага да се разберат различията, е доста прост. Нека предположим, че компютър трябва да разграничи снимки на котки и кучета, които се зареждат от СХД. За ML е необходимо да се подаде набор от изображения с множество тагове, всеки от които определя определена характеристика на животното. За DL е достатъчно да се зареди значително по-голямо количество изображения, но с един единствен таг „това е котка“ или „това е куче“. DL е много подобно на начина, по който учат малките деца – просто им показват изображения на кучета и котки в книги и в реалния живот (често дори не обяснявайки детайлните разлики), а мозъкът на детето сам започва да определя типа на животното след определено критично количество картинки за сравнение (по оценки, става въпрос само за стотина-две показвания през целия период на ранно детство). Алгоритмите DL все още не са достатъчно усъвършенствани: за да може невронната мрежа да работи толкова успешно с определянето на образи, е необходимо да се подадат и обработят в GPU милиони изображения.
Заключението на предисловието: на база GPU могат да се изграждат HPC приложения в областта на Big Data, ML и DL, но съществува проблем – наборите от данни са толкова обширни, че времето, необходимо за зареждане на данни от системата за съхранение в GPU, започва да намалява общата производителност на приложението. С други думи, бързите графични процесори остават недозапълнени заради бавния вход-изход на данни, идващи от други подсистеми. Разликата в скоростта на вход-изход между GPU и шина към CPU/СХД може да бъде порядък.
Как работи технологията GPUDirect Storage?
Процесът на вход-изход се контролира от CPU, както и процесът на зареждане на данни от хранилището в графичните процесори за последваща обработка. Оттук произлиза нуждата от технология, която да предостави директен достъп между GPU и NVMe диск за бързо взаимодействие помежду си. Първата такава технология бе предложена от NVIDIA и наречена GPUDirect Storage. По същество, това е вид на по-рано разработената от тях технология GPUDirect RDMA (Remote Direct Memory Address).
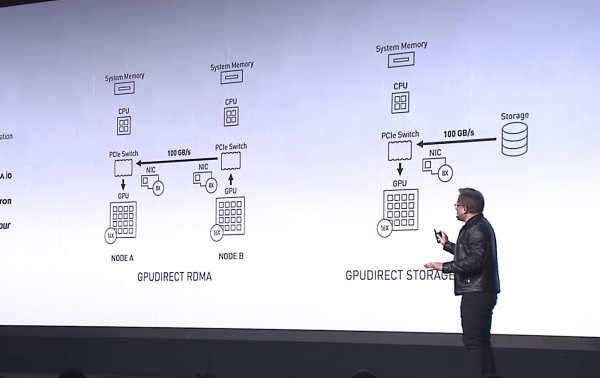
Дженсън Хуан, главен изпълнителен директор на NVIDIA, представя GPUDirect Storage като вид GPUDirect RDMA на изложението SС-19. Източник: NVIDIA
Разликата между GPUDirect RDMA и GPUDirect Storage е в устройствата, между които се осъществява адресацията. Технологията GPUDirect RDMA е преназначена за прехвърляне на данни директно между входната карта на мрежовия интерфейс (NIC) и паметта на GPU, докато GPUDirect Storage предоставя директен път за предаване на данни между локално или отдалечено хранилище, като NVMe или NVMe през Fabric (NVMe-oF) и паметта на GPU.
И двата варианта, GPUDirect RDMA и GPUDirect Storage, избягват излишните прехвърляния на данни през буфера в паметта на CPU и позволяват на механизма за директен достъп до памет (DMA) да прехвърля данните от мрежовата карта или хранилището директно в паметта на GPU или обратно, и всичко това без натоварване на централния процесор. За GPUDirect Storage местоположението на хранилището няма значение: това може да бъде NVMe диск в единица с GPU, в стелаж или свързан по мрежа като NVMe-oF.
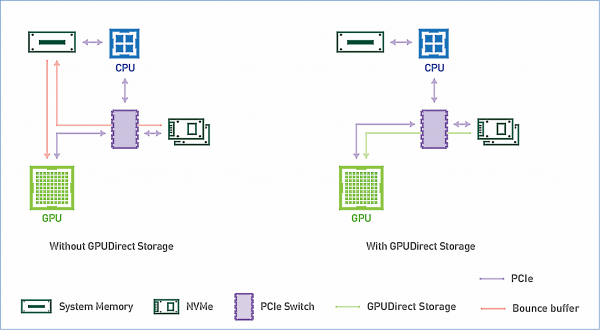
Схема на работа на GPUDirect Storage. Източник: NVIDIA
Hi-End СХД на NVMe са търсени на пазара на HPC приложения.
С осъзнаването, че с появата на GPUDirect Storage интересът на големите клиенти ще бъде насочен към предлагането на системи за съхранение с входно/изходна скорост, съответстваща на пропускната способност на GPU, на изложението SC-19 Kingston показа демонстрационна система, състояща се от СХД на база NVMe дискове и единица с GPU, в която се извършваше анализ на хиляди спътникови снимки в секунда. За такава СХД на база 10 накопители DC1000M U.2 NVMe вече писахме. .
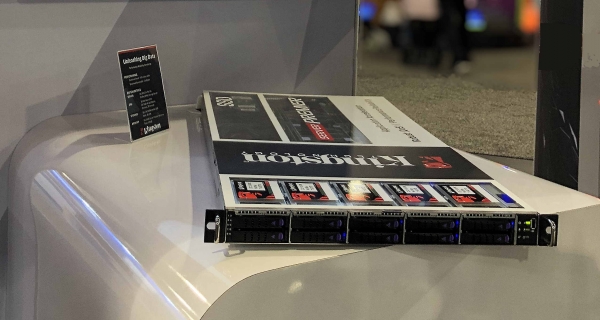
СХД на база 10 накопители DC1000M U.2 NVMe достойно допълва сървър с графични ускорители. Източник: Kingston.
Тази СХД е реализирана във вид на стоечен юнит 1U или повече и може да се мащабира в зависимост от броя дискове DC1000M U.2 NVMe, където всеки с капацитет 3.84-7.68 TB. DC1000M е първият модел NVMe SSD в форм-фактор U.2 в серията устройства на Kingston за дата центрове. Той има рейтинг на издръжливост (DWPD, Drive writes per day), позволяващ перезаписване на данните до пълния капацитет веднъж на ден в продължение на гаранционния срок на устройството.
В теста fio v3.13 на операционната система Ubuntu 18.04.3 LTS, Linux kernel 5.0.0-31-generic, изложбеният образец на СХД показа скорост на четене (Sustained Read) 5.8 млн IOPS при устойчива пропускна способност (Sustained Bandwidth) 23.8 Gbit/s.
Ариел Перес, бизнес мениджър SSD в Kingston, описа новите СХД: „Готови сме да снабдим следващото поколение сървъри със SSD решения U.2 NVMe, за да отстраним много от тесните места в предаването на данни, които традиционно са свързани със системата за съхранение. Съчетавайки NVMe SSD устройства и нашата премиум оперативна памет Server Premier DRAM, Kingston става един от най-пълните доставчици на интегрирани решения за обработка на данни в индустрията.“
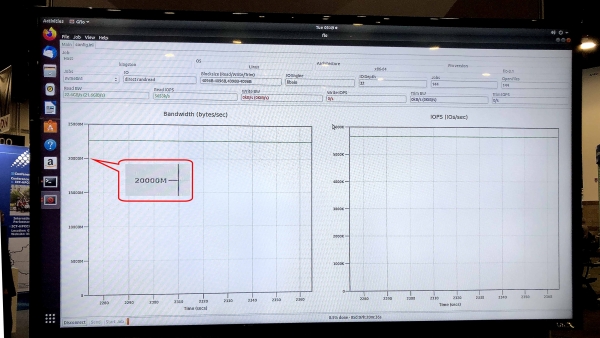
Тестът gfio v3.13 показа пропускна способност от 23.8 Гбит/с за демонстрационната СХД с дискове DC1000M U.2 NVMe. Източник: Kingston
Как ще изглежда типичната система за HPC приложения, в която е внедрена технологията GPUDirect Storage или подобна на нея? Това е архитектура с физическо разделение на функционалните блокове в стойката: едно-две устройства на оперативната памет, още няколко на изчислителните узли GPU и CPU и едно или няколко устройства за СХД.
С анонса на GPUDirect Storage и възможното появяване на подобни технологии от други производители на GPU, за Kingston се увеличава търсенето на СХД, предназначени за приложения с висока производителност. Показателят ще бъде скоростта на четене на данни от СХД, сравнима с пропускната способност на 40 или 100 Гбитни мрежови карти на входа в изчислителния блок с GPU. Така, ултра бързите СХД, включително външни NVMe през Fabric, ще преминат от екзотика към основна част за HPC приложения. Освен в науката и финансовите изчисления, те ще намерят приложение в много други практически области, като системи за безопасност от ниво мегаполис Safe City или центрове за наблюдение в транспорт, където е необходима скорост на разпознаване и идентификация на ниво милиони HD изображения в секунда“ — определи пазарната ниша на водещите СХД.
Допълнителна информация за продуктите на Kingston може да бъде намерена на компанията.
Източник: habr.com
