

Как да преведем бизнес изисквания в конкретни структури от данни на примера на проектирането на база за месинджър "от нула".
- Част 1: проектираме скелета на базата
Нашата база няма да бъде толкова мащабна и разпределена, или , а "за да има", но да е добре — функционално, бързо и да се събира на един сървър PostgreSQL — за да може да разположим отделен екземпляр на услугата някъде отстрани, например.
Затова няма да засягаме въпросите за шардирование, репликация и георазпределени системи, а ще се фокусираме върху схемните решения вътре в БД.
Стъпка 1: Малко бизнес-специфика
Нашето обменяне на съобщения ще проектираме не абстрактно, а ще го вградим в средата . Тоест, хората при нас не "просто си разменят съобщения", а общуват помежду си в контекста на решаването на определени бизнес задачи.
А какви бизнес задачи има?.. Нека видим на примера на Василий — ръководителя на отдела по разработка.
- "Николай, ние имаме нужда от пача за тази задача днес!"
Значи, кореспонденцията може да се води в контекста на някакъв документ. - "Коля, да играем ли Dota вечерта?"
Тоест дори и при само една двойка събеседници общуването може да се води по различни теми. - "Петър, Николай, вижте приложението с цените за новия сървър."
Така, едно съобщение може да има няколко получатели. При това, съобщението може да съдържа прикачени файлове. - "Семен, и ти също хвърли поглед."
И трябва да има възможност в съществуващата кореспонденция да поканим нов участник.
За сега да спрем на този списък с "очевидни" нужди.
Без разбиране на приложната специфика на задачата и зададените от нея ограничения, проектирането на ефективна схема на БД за нейното решение практически е невъзможно.
Стъпка 2: Минимална логическа схема
Схемно, всичко изглежда много подобно на email кореспонденция — традиционен инструмент за водене на бизнес. Да, "алгоритмично" много бизнес задачи си приличат, затова и инструментите за тяхното решаване ще бъдат структурно сходни.
Нека зафиксируем получената логическа схема на отношенията между субектите. За по-лесно разбиране на нашия модел ще използваме най-примитивния вариант на отображение без усложнения UML или IDEF-нотации:
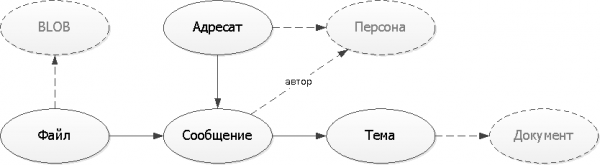
В нашия пример персона, документ и бинарното „тяло“ на файла са „външни“ сущности, които съществуват самостоятелно и без нашия сервис. Затова ще ги възприемем по-нататък като някои линкове „някъде“ по UUID.
Рисувайте схеми колкото се може по-просто — повечето от тези, на които ще ги показывате, не са експерти в четенето на UML/IDEF. Но — рисувайте задължително.
Стъпка 3: Проектираме структурата на таблиците
За имената на таблиците и полетатаКъм "руските" названия на полетата и таблиците може да се подхожда по различен начин, но това е въпрос на вкус. Тъй като нямаме разработчици и чужденци, а PostgreSQL ни позволява да даваме имена дори на йероглифи, стига те да са в кавички, предпочитаме да именуваме обектите точно и ясно, за да не възникват неясноти.
Тъй като съобщенията се пишат от много хора едновременно, част от тях могат да го правят в офлайн режим, най-простият вариант е да използвате UUID като идентификатори не само за външни сущности, но и за всички обекти в нашия сервис. Освен това, можете да ги генерирате дори на клиентската страна — това ще ни помогне да осигурим изпращането на съобщения при краткотрайна недостъпност на БД, а вероятността за колизия е изключително малка.
Черновата структура на таблиците в нашата база ще изглежда така:
Таблици : RU
CREATE TABLE "Тема"(
  "Тема"
    uuid
      PRIMARY KEY
, "Документ"
    uuid
, "Название"
    text
);

CREATE TABLE "Сообщение"(
  "Сообщение"
    uuid
      PRIMARY KEY
, "Тема"
    uuid
, "Автор"
    uuid
, "ДатаВремя"
    timestamp
, "Текст"
    text
);

CREATE TABLE "Адресат"(
  "Сообщение"
    uuid
, "Персона"
    uuid
, PRIMARY KEY("Сообщение", "Персона")
);

CREATE TABLE "Файл"(
  "Файл"
    uuid
      PRIMARY KEY
, "Сообщение"
    uuid
, "BLOB"
    uuid
, "Имя"
    text
);
Таблици : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Най-просто, когато описваме формата, е да започнем да „развиваме“ графа на връзките от таблиците, които не се свързват сами с никого.
Стъпка 4: Изясняваме неочевидните нужди
Всичко, проектирахме база, в която може отлично да се пише и някак си да се чете.
Нека да влезем в обувките на потребителя на нашия сервис — какво бихме искали да правим с неговата помощ?
- Последни съобщения
Това хронологично сортиран по различни признаци регистър на „моите“ съобщения. Където аз съм един от адресатите, където съм автор, където ми писаха, а аз не отговорих, където не ми отговориха, … - Участници в кореспонденцията
Кои всъщност участват в този дълъг-дълъг чат?
Нашата структура позволява да решим и двете тези задачи «по принцип», но бързо — не. Проблемът е, че за сортиране в рамките на първата задача не е възможно да се създаде индекс, подходящ за всички участници (и трябва да извлечем всички записи), а за решаване на втората е необходимо да извлечем всички съобщения по темата.
Непредвидени потребителски задачи могат да поставят сериозен въпрос относно производителността.
Стъпка 5: Разумна денормализация
И двете наши проблеми ще помогнат да решим допълнителни таблици, в които ще дублираме част от данните, необходими за формиране на подходящи индекси за нашите задачи.
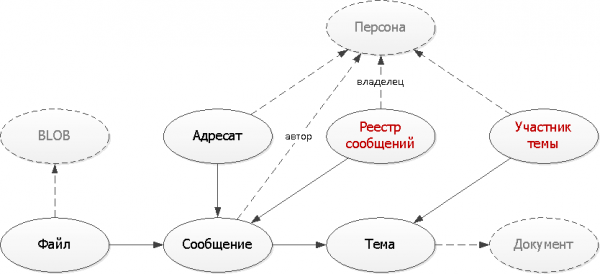
Таблици : RU
CREATE TABLE "РегистърНаСъобщенията"(
  "Собственик"
    uuid
, "ТипНаРегистъра"
    smallint
, "ДатаЧас"
    timestamp
, "Съобщение"
    uuid
, PRIMARY KEY("Собственик", "ТипНаРегистъра", "Съобщение")
);
CREATE INDEX ON "РегистърНаСъобщенията"("Собственик", "ТипНаРегистъра", "ДатаЧас" DESC);

CREATE TABLE "УчастникВТемата"(
  "Тема"
    uuid
, "Лице"
    uuid
, PRIMARY KEY("Тема", "Лице")
);
Таблици : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Тук приложихме два типични подхода, използвани при създаване на помощни таблици:
- Умножаване на записите
Създаваме по една оригинална запис на съобщение и веднага няколко производни записи в различни видове регистри за различни собственици — както за изпращача, така и за получателя. Затова всеки от регистрите сега попада на индекс — понеже в типичния случай искаме да видим само първата страница. - Уникализиране на записите
При всяко изпращане на съобщение в рамките на конкретна тема е достатъчно да проверим дали вече съществува такъв запис. Ако не — добавяме го в нашия «речник».
В следващата част на статията ще стане въпрос за в структурата на нашата база.
Източник: habr.com
