

Успешно планираха структурата на нашата PostgreSQL база за съхранение на кореспонденция. Измина година, потребителите активно я запълват и в нея вече има милиони записи, и… нещо започна да забавя всичко.
- Част 2: секционираме "на живо"
Работата е там, че С увеличаването на обема на таблицата нараства и "дълбочината" на индексите — макар и логаритмично. Но с времето това принуждава сървъра да обработва значително повече страници данни , отколкото в началото.Тук на помощ идва
сектирането . Искам да подчертая, че става въпрос не за шардове, тоест разпределение на данните между различни бази или сървъри. Защото, дори да разделите данните на.
сървъри, не можете да избегнете проблема с "раздуването" на индексите с времето. Ясно е, че ако можете да си позволите да пускате нов сървър всеки ден, проблемите ви вече няма да са свързани само с конкретната база данни. няколко Ние ще разгледаме не конкретни скриптове за реализиране на секциониране „в железата“, а самия подход — какво и как да "разделим на парчета", и до какво води такова желание.
Още веднъж да определим нашата цел: и днес, и утре, и след година числото на четими PostgreSQL данни при всяка операция на четене/запис да остане приблизително същото.
Концепция
За всякакви
хронологично натрупвани данни (съобщения, документи, логове, архиви, …) естественият избор за ключ за секциониране е датата/времето на събитието . В нашия случай такова събитие емоментът на изпращане на съобщението . Забелязваме, че потребителите практически винаги.
работят само с "последните" такива данни — четат последните съобщения, анализират последните логове,… Не, разбира се, те могат да превъртат и по-назад във времето, но го правят много рядко. От тези ограничения става очевидно, че оптималното решение за съобщенията ще бъде
"на всеки ден" секции — защото почти винаги нашият потребител ще чете това, което е получено "днес" или "вчера". Ако през деня пишем и четем практически само в една секция, то това ни дава и
по-ефективно използване на паметта и диска — тъй като всичките индекси на секцията лесно се вписват в оперативната памет, за разлика от "големите и дебели" в цялата таблица. step-by-step
step-by-step
В общи линии всичко казва, че печалбата е постижима, но за да я постигнем, ще трябва да положим много усилия — защото разделянето на една от съществата води до необходимостта да "разрежем" и свързаните с нея.
Съобщение, неговите свойства и проекции
Ако решим да разделим съобщенията по дати, то и зависимите от тях същества-свойства (прикачени файлове, списък на получателите) е разумно да разделим също по дата на съобщението..
Тъй като една от типичните ни задачи е именно прегледът на регистрите на съобщенията (непрочетени, входящи, всички), то е логично също да ги "включим" в разделянето по дати на съобщенията.
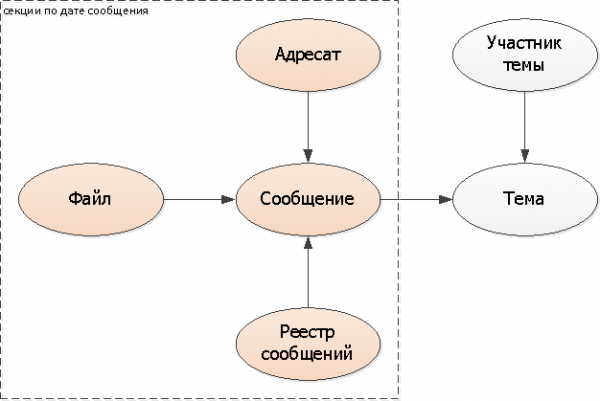
Добавяме ключ за разделяне (датата на съобщението) във всички таблици: получатели, файл, регистри. В самото съобщение може да не се добавя, а да се използва съществуващото ДатаВреме.
Теми
Тъй като темата е една за няколко съобщения, не може да я "разрежем" в същия модел, трябва да се опираме на нещо друго. В нашия случай идеално подхожда датата на първото съобщение в кореспонденцията. — тоест моментът на създаване на самата тема.
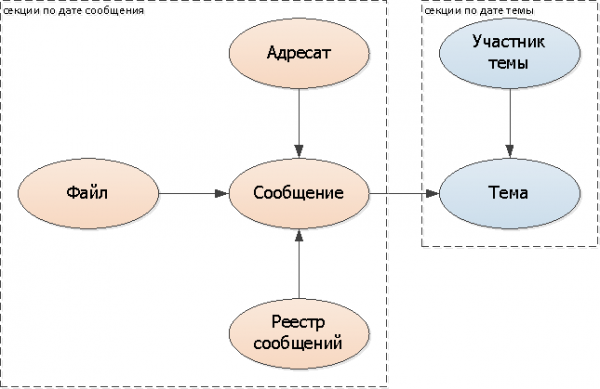
Добавяме ключ за разделяне (датата на темата) във всички таблици: тема, участник.
Но сега веднага имаме два проблема:
- в коя секция да търсим съобщения по тема?
- в коя секция да търсим темата от съобщението?
Може, разбира се, да продължим да търсим във всички секции, но това ще е много тъжно и ще опропасти всичките ни печалби. Затова, за да знаем къде конкретно да търсим, ще направим логически връзки/индикатори към секциите:
- в съобщението ще добавим поле с датата на темата,
- към темата ще добавим набор от дати на съобщенията в тази кореспонденция (може да бъде отделна таблица, а може и масив от дати).
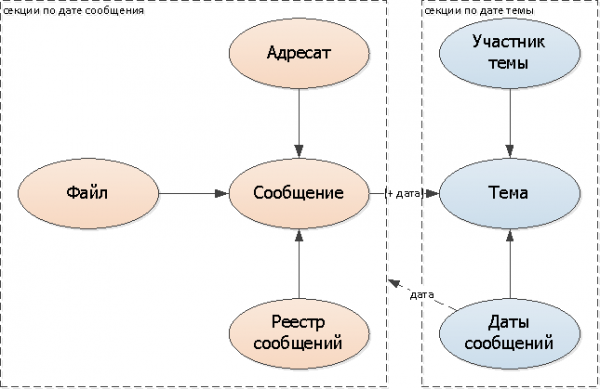
Тъй като модификациите на списъка с дати на съобщенията за всяка отделна кореспонденция ще бъдат малко (почти всички съобщения попадат в 1-2 съседни дни), ще се спра точно на такъв вариант.
В крайна сметка структурата на нашата база придоби следния вид с оглед на разделянето:
Таблици: RU, при отвращение към кирилицата в имената на таблици/полета е по-добре да не се гледа.
-- секции по дата на съобщението
CREATE TABLE "Съобщение_YYYYMMDD"(
  "Съобщение"
    uuid
      PRIMARY KEY
, "Тема"
    uuid
, "ДатаТема"
    date
, "Автор"
    uuid
, "ДатаЧас" -- използваме като дата
    timestamp
, "Текст"
    text
);

CREATE TABLE "Адресат_YYYYMMDD"(
  "ДатаСъобщение"
    date
, "Съобщение"
    uuid
, "Лице"
    uuid
, PRIMARY KEY("Съобщение", "Лице")
);

CREATE TABLE "Файл_YYYYMMDD"(
  "ДатаСъобщение"
    date
, "Файл"
    uuid
      PRIMARY KEY
, "Съобщение"
    uuid
, "BLOB"
    uuid
, "Име"
    text
);

CREATE TABLE "РегистърСъобщения_YYYYMMDD"(
  "ДатаСъобщение"
    date
, "Собственик"
    uuid
, "ТипРегистър"
    smallint
, "ДатаЧас"
    timestamp
, "Съобщение"
    uuid
, PRIMARY KEY("Собственик", "ТипРегистър", "Съобщение")
);
CREATE INDEX ON "РегистърСъобщения_YYYYMMDD"("Собственик", "ТипРегистър", "ДатаЧас" DESC);

-- секции по дата на темата
CREATE TABLE "Тема_YYYYMMDD"(
  "ДатаТема"
    date
, "Тема"
    uuid
      PRIMARY KEY
, "Документ"
    uuid
, "Заглавие"
    text
);

CREATE TABLE "УчастникТемата_YYYYMMDD"(
  "ДатаТема"
    date
, "Тема"
    uuid
, "Лице"
    uuid
, PRIMARY KEY("Тема", "Лице")
);

CREATE TABLE "ДатиСъобщенияТемата_YYYYMMDD"(
  "ДатаТема"
    date
, "Тема"
    uuid
      PRIMARY KEY
, "Дата"
    date
);
Спестяваме стотинка
А ако не използваме въз основа на разпределението на стойностите на полето (чрез тригери и наследяване или PARTITION BY), а „ръчно“ на ниво приложение, можем да забележим, че стойността на ключа за секциониране вече се съхранява в името на самата таблица.
Затова, ако толкова много се тревожите за обема на съхраняваните данни, от тези „излишни“ полета можете да се откажете и да се обръщате адресно към конкретни таблици. Въпреки че всички заявки от няколко секции в този случай ще трябва да се изнесат на страна на приложението.
Източник: habr.com
