

Добър ден! Казвам се Данил Липовой, нашият екип в Сбертех започна да използва HBase като хранилище на оперативни данни. При изучаването му се натрупа опит, който искахме да систематизираме и опишем (надяваме се, че ще е полезен за много хора). Всички посочени по-долу експерименти бяха проведени с версии HBase 1.2.0-cdh5.14.2 и 2.0.0-cdh6.0.0-beta1.
- Обща архитектура
- Запис на данни в HBASE
- Четене на данни от HBASE
- Кеширане на данни
- Пакетна обработка на данни MultiGet/MultiPut
- Стратегия за разделяне на таблици на региони (спилинг)
- Отказоустойчивост, компактиране и локализация на данни
- Настройки и производителност
- Натоварващо тестване
- Изводи
1. Обща архитектура
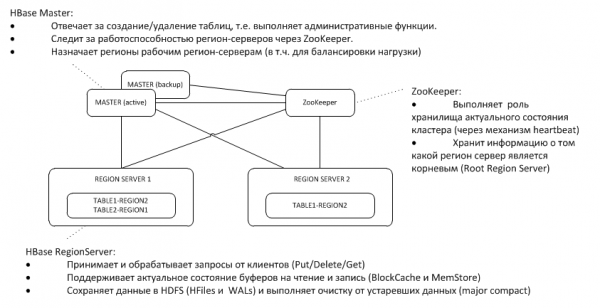
Резервният Master следи heartbeat на активния на узел ZooKeeper и в случай на изчезване поема функциите на мастера.
2. Запис на данни в HBASE
Първо разглеждаме най-простия случай – записване на обект ключ-стойност в определена таблица чрез put(rowkey). Клиентът първо трябва да установи къде се намира кореновият регионален сървър (Root Region Server - RRS), който съхранява таблицата hbase:meta. Тази информация получава от ZooKeeper. След това се обръща към RRS и чете таблицата hbase:meta, от която извлича информация за това кой RegionServer (RS) отговаря за съхранението на данните по зададения ключ rowkey в интересуващата го таблица. С цел последваща употреба мета-таблицата се кешира от клиента и затова последващите запитвания преминават по-бързо, директно към RS.
След като RS получи заявката, първо я записва в WriteAheadLog (WAL), което е необходимо за възстановяване в случай на срив. След това съхранява данните в MemStore. Това е буфер в паметта, който съдържа сортиран набор от ключове за този регион. Таблицата може да бъде разделена на региони (партитиции), всеки от които съдържа неперекриващ се набор от ключове. Това позволява, при разполагане на регионите на различни сървъри, да се постигне по-висока производителност. Въпреки очевидността на това твърдение, по-късно ще видим, че то не работи във всички случаи.
След като записа е поставен в MemStore, клиентът получава отговор, че записа е успешно съхранен. Въпреки това, той реално се съхранява само в буфера и ще попадне на диск само след като премине определен времеви интервал или при запълване с нови данни.
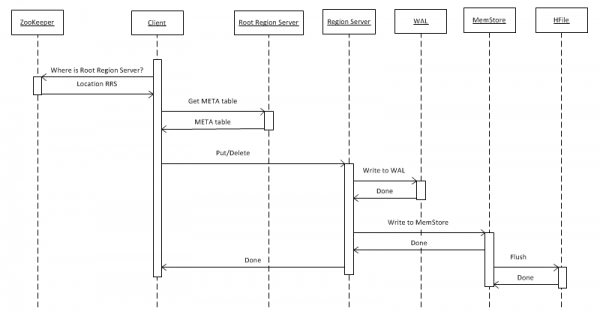
При извършване на операцията «Delete» физическото изтриване на данни не се осъществява. Те просто се отбелязват като изтрити, а самото унищожаване се случва в момента на извикването на функцията major compact, за която е написано по-подробно в т. 7.
Файлове в формат HFile се събират в HDFS и от време на време се стартира процесът minor compact, който просто свързва малки файлове в по-големи, без да изтрива нищо. С времето това се превръща в проблем, който се проявява само при четене на данни (към което ще се върнем по-късно).
Освен описания по-горе процес на зареждане, има много по-ефективна процедура, която представлява вероятно най-силната страна на тази БД – BulkLoad. Тя се основава на това, че сами формираме HFiles и ги поставяме на диска, което позволява отлична мащабируемост и постигане на доста прилични скорости. По същество, ограничението тук не е HBase, а възможностите на хардуера. По-долу са представени резултатите от зареждането на клъстера, състоящ се от 16 RegionServers и 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 потока), версия HBase 1.2.0-cdh5.14.2.
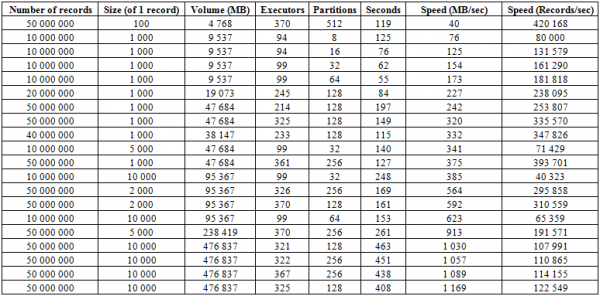
Тук се вижда, че увеличавайки броя на партициите (регионите) в таблицата, както и изпълнителите на Spark, получаваме увеличение на скоростта на зареждане. Освен това, скоростта зависи от обема на записа. Големите блокове дават нарастване в измерение МБ/сек, малките – в количеството на вкараните записи за единица време, при равни условия.
Също така, можем да стартираме зареждане в две таблици едновременно и да получим удвояване на скоростта. По-долу е видно, че записът на блокове от 10 КБ едновременно в две таблици става със скорост около 600 Мб/сек за всяка (общо 1275 Мб/сек), което съвпада със скоростта на запис в една таблица 623 МБ/сек (виж №11 по-горе).
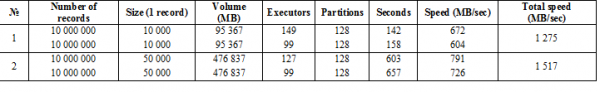
А вот второто стартиране с записи от 50 КБ показва, че скоростта на зареждане вече не нараства съществено, което говори за приближаване към пределните стойности. Важно е да се има предвид, че на самия HBASE тук практически не се създава натоварване, всичко, което му се изисква, е първо да предостави данните от hbase:meta, а след това при поставянето на HFiles, да сброси данните от BlockCache и да запази буфера MemStore на диска, ако не е празен.
3. Четене на данни от HBASE
Ако считаме, че всяка информация от hbase:meta вече е налична за клиента (вижте т. 2), то заявката веднага отива на онзи RS, където се съхранява необходимият ключ. Първо търсенето се извършва в MemCache. Независимо дали данните са налични там или не, търсенето също така се осъществява в буфера BlockCache и при необходимост в HFiles. Ако данните бъдат намерени в файла, те ще бъдат поставени в BlockCache и при следващата заявка ще бъдат върнати по-бързо. Търсенето в HFile става относително бързо благодарение на използването на филтъра Блюм, тоест, считайки малък обем данни, той веднага определя дали този файл съдържа необходимия ключ, и ако не, преминава към следващия.
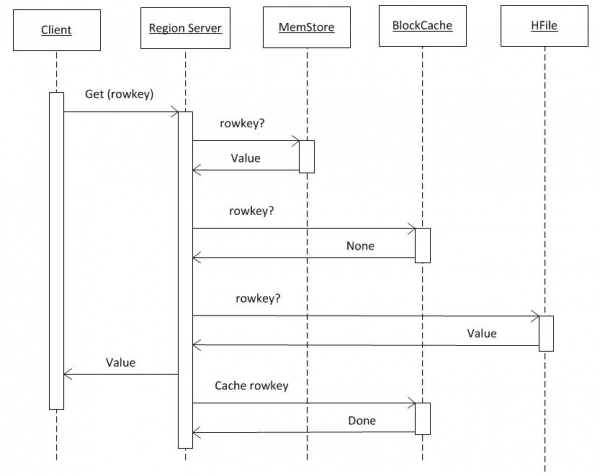
След като получи данни от тези три източника, RS формулира отговор. В частност, той може да предаде няколко намерени версии на обекта, ако клиентът е поискал версииране.
4. Кеширане на данни
Буферите MemStore и BlockCache заемат до 80% от предоставената on-heap памет на RS (останалото е резервирано за сервизни задачи на RS). Ако типичният режим на употреба е такъв, че процесите записват и веднага четат тези данни, то е разумно да се намали BlockCache и да се увеличи MemStore, тъй като при запис данните не попадат в кеша за четене, използването на BlockCache ще става по-рядко. Буферът BlockCache се състои от две части: LruBlockCache (винаги on-heap) и BucketCache (обикновено off-heap или на SSD). BucketCache следва да се използва, когато има много запитвания за четене и те не могат да се поберат в LruBlockCache, което води до активна работа на Garbage Collector. Все пак не бива да се очаква радикален ръст на производителността от използването на кеш за четене, но към това ще се върнем в т. 8.
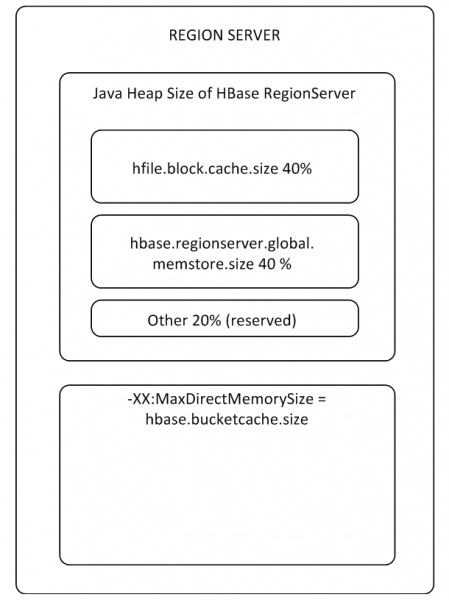
BlockCache е един за целия RS, а MemStore е собствен за всяка таблица (по един за всяко Column Family).
Как В теорията, при запис, данните не попада в кеша и всъщност, такива параметри CACHE_DATA_ON_WRITE за таблицата и „Cache DATA on Write“ за RS са зададени на false. Но на практика, ако запишете данните в MemStore, след което го изтриете на диск (така освобождавайки го), след това изтриете полученото файл, то при извършване на get заявка, ние успешно получаваме данните. И дори ако напълно деактивираме BlockCache и запълним таблицата с нови данни, след това достигнем до сброса на MemStore на диск, ги изтрием и поискате от друга сесия, те все пак ще бъдат извлечени отнякъде. И така, HBase съхранява в себе си не само данни, но и мистериозни загадки.
hbase(main):001:0> create 'ns:magic', 'cf'
Създадена таблица ns:magic
Отне 1.1533 секунди
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Отне 0.2610 секунди
hbase(main):003:0> flush 'ns:magic'
Отне 0.6161 секунди
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Параметърът „Cache DATA on Read“ е настроен на false. Ако имате идеи, заповядайте да ги обсъдим в коментарите.
5. Пакетна обработка на данни MultiGet/MultiPut
Обработката на единични заявки (Get/Put/Delete) е доста скъпа операция и следователно е препоръчително да се комбинират, когато е възможно, в List или List, което осигурява значителен прирост на производителността. Особено това важи за операцията на запис, докато при четене има следния подводен камък. На графиката по-долу е показано времето за четене на 50 000 записа от MemStore. Четенето е извършено в един поток и по хоризонталната ося е показано броят ключове в заявката. Тук се вижда, че при увеличаване до хиляда ключа в една заявка, времето за изпълнение намалява, т.е. скоростта се увеличава. Въпреки това, при включен по подразбиране режим MSLAB, след този праг започва радикално спадане на производителността, като колкото по-голям е обемът на данните в записа, толкова по-дълго е времето за работа.
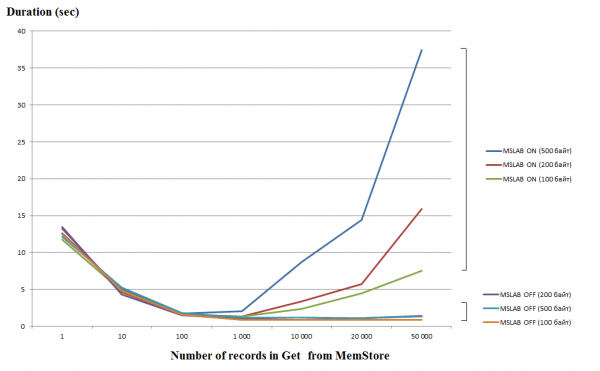
Тестовете са извършени на виртуална машина, 8 ядра, версия HBase 2.0.0-cdh6.0.0-beta1.
Режимът MSLAB има за цел да намали фрагментацията на heap, която възниква поради смесването на нови и стари поколения данни. Като решение на проблема, при включен MSLAB данните се поставят в относително малки клетки (chunk) и се обработват на порции. В резултат, когато обемът в запитан пакет данни надвишава определения размер, производителността рязко спада. От друга страна, деактивирането на този режим също не е желателно, тъй като води до забавяния поради GC в моменти на интензивна работа с данни. Добро решение е увеличаването на обема на клетките, в случай на активен запис чрез put, едновременно с четенето. Струва си да се отбележи, че проблемът не възниква, ако след записа се изпълни команда flush, която сбрасыва MemStore на диск, или ако се извършва зареждане чрез BulkLoad. В таблицата по-долу е показано, че заявките от MemStore на по-големи обеми данни (и с одинаково количество) водят до забавяне. Въпреки това, увеличавайки chunksize, връщаме времето за обработка обратно към нормата.
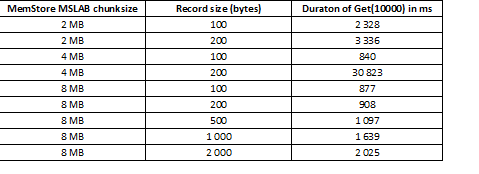
Освен увеличаването на chunksize, помага и разделянето на данните по региони, т.е. сплитинг на таблици. Това води до по-малко запитвания за всеки регион, а ако те попаднат в клетка, отговорът остава добър.
6. Стратегия за разделяне на таблиците на региони (сплитинг)
Тъй като HBase е ключова стойностна база данни и партиционирането се извършва по ключ, е изключително важно да се разделят данните равномерно по всички региони. Например, партиционирането на такава таблица на три части ще разпредели данните на три региона:
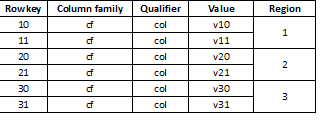
Понякога това води до рязко забавяне, ако по-късно заредените данни са с примерни long стойности, които в повечето случаи започват с една и съща цифра, например:
1000001
1000002
…
1100003
Тъй като ключовете се съхраняват като масив от байтове, те всички ще започват еднакво и ще принадлежат на един регион #1, който съхранява този диапазон от ключове. Има няколко стратегии за разделяне:
HexStringSplit – Превръща ключа в низ с хексадецимално кодиране в диапазона „00000000“ => „FFFFFFFF“, като запълва отляво с нули.
UniformSplit – Превръща ключа в масив от байтове с хексадецимално кодиране в диапазона „00“ => „FF“, като запълва отдясно с нули.
Освен това, можете да зададете произволен диапазон или набор от ключове за разделяне и да настроите автоматично сплитване. Въпреки това, един от най-простите и ефективни подходи е UniformSplit и използването на конкатенация на хеш, например, старшата двойка байтове от пускането на ключа през функция CRC32(rowkey) и самия rowkey:
хеш + rowkey
Тогава всички данни ще бъдат разпределени равномерно по регионите. При четене, първите два байта просто се отхвърлят и остава първоначалният ключ. Освен това RS контролира количеството данни и ключове в региона и при надвишаване на лимитите автоматично го разделя на части.
7. Отказоустойчивост и локализация на данните
Тъй като за всеки ключов набор отговаря само един регион, решението на проблемите, свързани с паденията на RS или изваждането от експлоатация, е съхраняването на необходимите данни в HDFS. При падение на RS, мастера го открива чрез отсъствие на heartbeat на узла ZooKeeper. Тогава той назначава обслужвания регион на друг RS и тъй като HFiles се съхраняват в разпределената файлова система, новият собственик ги прочита и продължава да обслужва данните. Въпреки това, тъй като част от данните може да е в MemStore и не е успяла да попадне в HFiles, за възстановяване на историята на операциите се използва WAL, която също се съхранява в HDFS. След прилагане на промените, RS е способен да отговаря на запитвания, но преместването води до това, че част от данните и процесите, които ги обслужват, попадат на различни възли, т.е. намалява локалността.
Решението на проблема е major compaction – тази процедура премества файловете на тези възли, които отговарят за тях (където са разположени техните региони), в резултат на което по време на тази процедура натиска върху мрежата и дисковете рязко нараства. Въпреки това, в бъдеще достъпът до данните значително се ускорява. Освен това, major_compaction обединява всички HFiles в един файл в рамките на региона и също така изчиства данните в зависимост от настройките на таблицата. Например, можете да зададете количеството версии на обектите, което трябва да се запази, или времето на съществуване, след което обектът се изтрива физически.
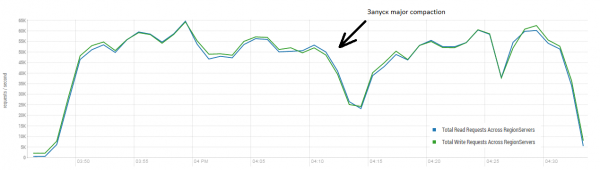
Тази процедура може да има много положително влияние върху работата на HBase. На картинката по-долу се вижда как е деградирала производителността в резултат на активна записване на данни. Видно е, че в една таблица 40 потока пишат и 40 потока едновременно четат данни. Пишещите потоци формират все повече и повече HFiles, които се прочитат от другите потоци. В резултат на това все повече данни трябва да бъдат изтрити от паметта и в крайна сметка започва да работи GC, който практически парализира цялата работа. Стартирането на major compaction доведе до почистване на натрупалите се отпадъци и възстановяване на производителността.
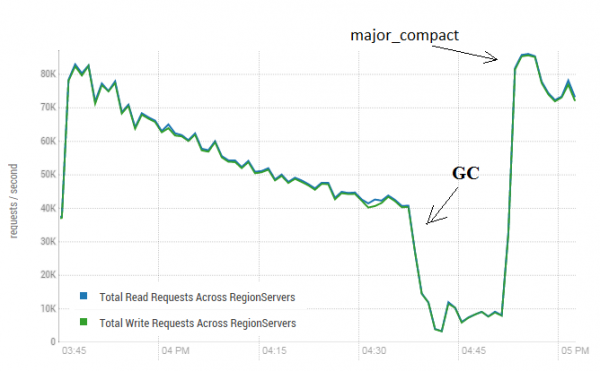
Тестът се проведе на 3 DataNode и 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 потока). Версия HBase 1.2.0-cdh5.14.2
Важно да се отбележи, че стартирането на major compaction е било извършено на 'жива' таблица, в която активно се записваха и четяха данни. В мрежата имаше твърдения, че това може да доведе до неправилен отговор при четене на данните. За проверка бе стартиран процес, който генерираше нови данни и ги записваше в таблицата. След това незабавно четеше и сравняваше дали получената стойност съвпада с записаната. По време на работата на този процес major compaction бе стартиран около 200 пъти и не бяха регистрирани никакви грешки. Вероятно проблемът се проявява рядко и само при високо натоварване, затова е по-безопасно да се спират планово процессите на запис и четене и да се извършва почистване без да се допуска такова спадане на GC.
Също така major compaction не влияе на състоянието на MemStore, за да се нулира на диск и да се компактизира, е необходимо да се използва flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Настройки и производителност
Както вече беше споменато, HBase показва най-голям успех там, където не е необходимо да прави нищо, по време на изпълнение на BulkLoad. Въпреки това, това се отнася за повечето системи и хора. Въпреки това, този инструмент е по-подходящ за масово влагане на данни на големи блокове, докато ако процесът изисква изпълнението на множество конкурентни заявки за четене и запис, се използват описаните по-горе команди Get и Put. За определяне на оптималните параметри бяха извършени стартирания при различни комбинации от параметри на таблиците и настройки:
- 10 потока бяха стартирани едновременно 3 поредни пъти (да го наречем блок от потоци).
- Времето за работа на всички потоци в блока бе средно аритметично и беше окончателният резултат от работата на блока.
- Всички потоци работеха с една и съща таблица.
- Преди всяко стартиране на блока от потоци се изпълняваше major compaction.
- Всеки блок извършваше само една от следните операции:
— Put
— Get
— Get+Put
- Всеки блок извършваше 50 000 повторения на своята операция.
- Размерът на записа в блока е 100 байта, 1000 байта или 10000 байта (случайно).
- Блоковете се стартираха с различен брой запитвания за ключове (или един ключ, или 10).
- Блоковете се стартираха при различни настройки на таблицата. Параметрите бяха променяни:
— BlockCache = включен или изключен
— BlockSize = 65 Кб или 16 Кб
— Партиции = 1, 5 или 30
— MSLAB = включен или изключен
Така блокът изглежда така:
a. Режимът MSLAB се включва или изключва.
b. Беше създадена таблица, за която бяха установени следните параметри: BlockCache = true/none, BlockSize = 65/16 Kb, Партиции = 1/5/30.
c. Беше настроено GZ компресиране.
d. Стартираха се 10 нишки, които едновременно извършваха 1/10 операции put/get/get+put в тази таблица с записи от 100/1000/10000 байта, изпълнявайки 50 000 запитвания последователно (ключовете бяха произволни).
e. Пункт d беше повторен три пъти.
f. Времето за работа на всички нишки беше средно.
Бяха проверени всички възможни комбинации. Предсказуемо е, че с увеличаване на размера на записа скоростта ще намалява или че деактивирането на кеширането ще доведе до забавяне. Все пак целта беше да се разбере степента и значимостта на влиянието на всеки параметър, затова събраните данни бяха подадени на функция за линейна регресия, което позволява да се оцени достоверността чрез t-статистиката. По-долу са представени резултатите от работата на блоковете, извършващи операции Put. Пълният набор от комбинации 2*2*3*2*3 = 144 варианта + 72, тъй като някои бяха изпълнени два пъти. Следователно общо 216 стартирания:
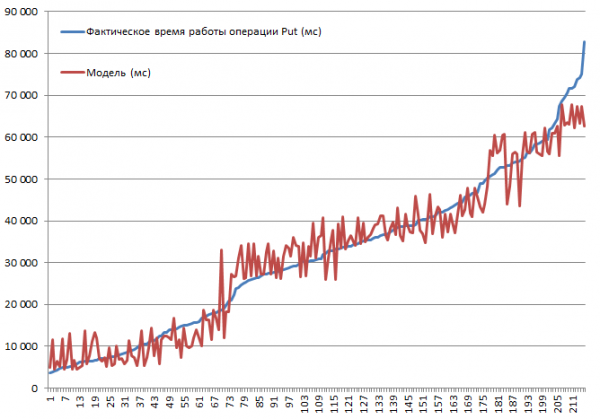
Тестовете бяха проведени на мини-клъстер, състоящ се от 3 DataNode и 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 потока). Версия HBase 1.2.0-cdh5.14.2.
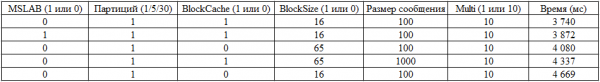
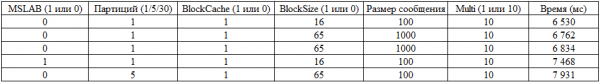
Най-високата скорост на вставяне от 3.7 сек беше получена при деактивиран режим MSLAB, на таблица с една партиция, с активиран BlockCache, BlockSize = 16, записи от 100 байта по 10 на поръчка.
Най-ниската скорост на вставяне от 82.8 сек беше получена при активиран режим MSLAB, на таблица с една партиция, с активиран BlockCache, BlockSize = 16, записи от 10000 байта по 1 на поръчка.
Сега да погледнем модела. Наблюдаваме добро качество на модела по R2, но е напълно ясно, че екстраполацията тук е противопоказана. Реалното поведение на системата при промяна на параметрите ще бъде нелинейно; този модел не е нужен за прогнози, а за разбиране на случилото се в рамките на зададените параметри. Например тук виждаме по критерия на Стюдент, че за операция Put параметрите BlockSize и BlockCache нямат значение (което в общи линии е предсказуемо):
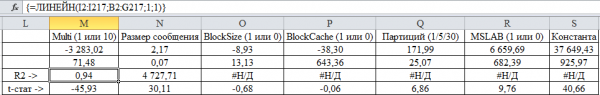
Увеличаването на броя на партиции води до намаляване на производителността, което е малко неочаквано (вече видяхме положителното влияние на увеличаването на броя на партиции при BulkLoad), въпреки че е обяснимо. Първо, при обработката се налага да се формират заявки към 30 региона вместо един, а обемът на данните не е достатъчен, за да донесе полза. Второ, общото време на работа се определя от най-бавния RS, а тъй като броят на DataNode е по-малък от броя на RS, част от регионите имат нулева локализация. Нека видим и петте лидери:
Сега оценяваме резултатите от изпълнението на блоковете Get:
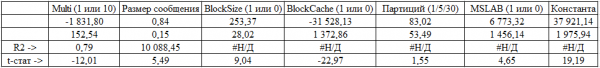
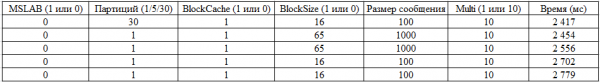
Броят на партиции изгуби значение, което вероятно се обяснява с факта, че данните се кешират добре и кешът за четене е най-значимият (статистически) параметър. Естествено, увеличаването на броя на съобщенията в заявката също е доста полезно за производителността. Най-добрите резултати:
Накрая ще разгледаме модела на блока, който първо изпълнява get, а след това put:
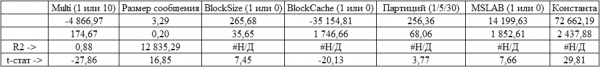
Тук всички параметри са значими. Резултатите на лидерите:
9. Натоварващо тестване
Накрая ще стартираме сравнително прилично натоварване, но винаги е по-интересно, когато има с какво да се сравнява. На сайта на DataStax – ключовият разработчик на Cassandra има НТ на редица NoSQL хранилища, включително HBase версия 0.98.6-1. Натоварването се извършваше с 40 потока, размерът на данните е 100 байта, SSD дискове. Резултатът от тестването на операциите Read-Modify-Write показа такива резултати.
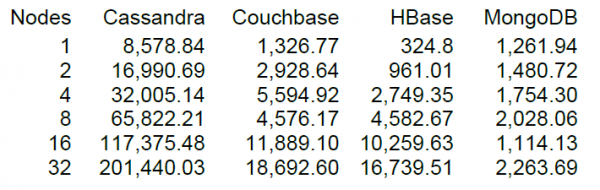
Насколько разбрах, четенето се осъществяваше на блокове от 100 записа и за 16 нод HBase тестът на DataStax показа производителност от 10 хиляди операции в секунда.
Удобно е, че в нашия клъстер също има 16 нода, но не много «удобно», че на всеки от тях има по 64 ядра (потока), докато в теста на DataStax имат само по 4. От една страна, те имат SSD дискове, а ние имаме HDD и по-нова версия на HBase, а употребата на CPU по време на натоварването почти не се увеличава (визуално с 5-10 процента). Обаче, все пак ще опитаме да стартираме на тази конфигурация. Настройките на таблиците са по подразбиране, четенето се извършва в диапазона на ключове от 0 до 50 милиона на случаен принцип (т.е. всъщност всеки път ново). В таблицата има 50 милиона записа, разпределени на 64 партиции. Ключовете са хеширани по crc32. Настройките на таблиците са дефолтни, MSLAB е включен. Стартиране на 40 потока, всеки поток чете набор от 100 случайни ключа и веднага записва генерирани 100 байта обратно по тези ключове.
Стенд: 16 DataNode и 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 потока). Версия HBase 1.2.0-cdh5.14.2.
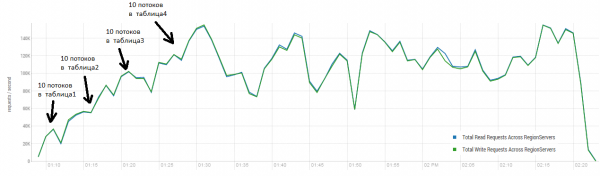
Средният резултат е около 40 хиляди операции в секунда, което е значително по-добре от теста на DataStax. Обаче в името на експеримента можем леко да променим условията. Доста малко вероятно е цялата работа да се извършва изключително с една таблица, а също така само с уникални ключове. Да предположим, че има некакъв «горещ» набор ключове, който генерира основното натоварване. Затова ще опитаме да създадем натоварване с по-големи записи (10 KB), също така на партиди по 100, в 4 различни таблици, ограничавайки диапазона на запитваните ключове до 50 хиляди. На графиката по-долу е показано стартиране на 40 потока, всеки поток прочита набор от 100 ключа и веднага записва произволни 10 KB по тези ключове обратно.
Стенд: 16 DataNode и 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 потока). Версия HBase 1.2.0-cdh5.14.2.
По време на натоварването няколко пъти се стартира major compaction, както бе показано по-горе, без тази процедура производителността ще деградира постепенно, обаче по време на изпълнението възниква и допълнително натоварване. Просадките са причинени от различни причини. Понякога потоките приключваха работа и докато те се рестартираха, възникваше пауза, понякога външни приложения създаваха натоварване на клъстера.
Четенето и незабавната запис на данни са един от най-тежките сценарии за работа с HBase. Ако се изпълняват само put заявки с малки размери, например по 100 байта, и те се комбинират в пакети от 10-50 хиляди, могат да се достигнат стотици хиляди операции в секунда, а подобна е ситуацията и със заявки само за четене. Забележително е, че резултатите са значително по-добри от тези на DataStax, благодарение на обработката на заявки в пакети от 50 хиляди.
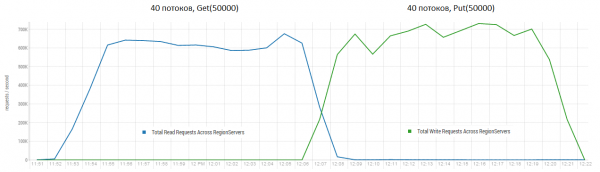
Стенд: 16 DataNode и 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 потока). Версия HBase 1.2.0-cdh5.14.2.
10. Изводи
Тази система е достатъчно гъвкаво настраиваемая, но влиянието на многобройни параметри все още остава неизвестно. Част от тях бяха тествани, но не бяха включени в окончателния набор от тестове. Например, предварителните експерименти показаха незначителна стойност на параметъра DATA_BLOCK_ENCODING, който кодира информация, използвайки стойности от съседни клетки, което е обяснимо за данни, генерирани случайно. При наличие на голямо количество повтарящи се обекти печалбата може да е значителна. В заключение, HBase произвежда впечатление на сериозна и обмислена база данни, която при работа с големи блокове данни може да бъде достатъчно производителна. Особено ако има възможност за разпределяне на времето за четене и запис.
Ако нещо, според вас, е недостатъчно разкрито, съм готов да разкажа по-подробно. Предлагам да споделим опит или да обсъдим, ако не сте съгласни с нещо.
Източник: habr.com
