

Всички говорят за процесите на разработка и тестване, обучение на персонала, повишаване на мотивацията, но тези процеси са недостатъчни, когато минутата престой на услугата струва космически суми. Какво да правим, когато извършваме финансови транзакции под стриктен SLA? Как да увеличим надеждността и отказоустойчивостта на нашите системи, изключвайки разработката и тестването?
Следващата конференция HighLoad++ ще се проведе на 6 и 7 април 2020 година в Санкт Петербург. Подробности и билети на . 9 ноември, 18:00. HighLoad++ Москва 2018, зала "Дели + Калкута". Тезиси и .
Евгений Кузовлев (по-нататък – ЕК): – Приятели, здравейте! Казвам се Кузовлев Евгений. Аз съм от компанията EcommPay, конкретно подразделение – EcommPay IT, IT подразделението на групата компании. И днес ще поговорим за престои – как да ги избегнем, как да минимизираме последствията им, ако не успеем да ги избегнем. Темата е обявена така: "Какво да правим, когато минутата престой струва 100 000 долара"? Да кажем предварително, цифрите са сравними.
С какво се занимава EcommPay IT?
Кои сме ние? Защо съм тук пред вас? Защо имам право да ви говоря тук? И за какво ще говорим по-подробно?
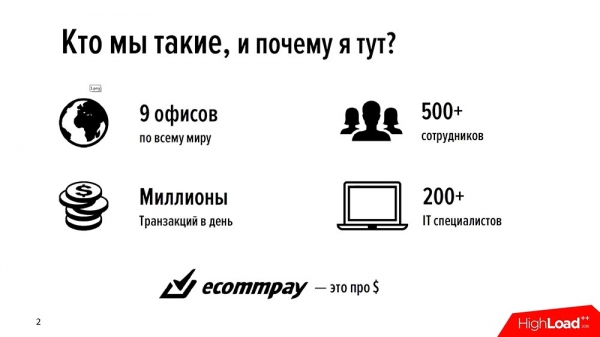
Групата компании EcommPay е международен еквайър. Ние обработваме плащания по целия свят – в Русия, Европа, Югоизточна Азия (На всякъде по света). Имаме 9 офиса, 500 служители общо и по-малко от половината от тях са IT специалисти. Всичко, което правим, всичко, с което печелим пари, сме направили сами.
Всички наши продукти (а имаме доста – в линията на големите IT продукти имаме около 16 различни компонента) сме написали сами; ние сами пишем, ние сами развиваме. В момента извършваме около милион транзакции на ден (може би е по-точно да кажем милиони). Ние сме млада компания, на малко над шест години.
Преди 6 години това беше стартап, когато момчетата дойдоха заедно с бизнеса. Те бяха обединени около идеята (нямаше нищо друго, освен идеята) и ние тръгнахме. Както всеки стартап, тичахме бързо... За нас скоростта беше по-важна от качеството.
В даден момент спрягахме: осъзнахме, че не можем да живеем със същата скорост и качество и че трябва да поставим акцент върху качеството. Тогава взехме решение да напишем нова платформа, която да бъде правилна, мащабируема и надеждна. Започнахме разработката на тази платформа (инвестирахме, развивахме, тестваме), но в някакъв момент осъзнахме, че разработката и тестването не ни позволяват да постигнем ново ниво на качество на услугата.
Създавате нов продукт, пускате го в продукция, но все пак нещо може да не тръгне както трябва. Днес ще говорим за това как да достигнем ново качествено ниво (как ние го постигнахме, нашият опит), оставяйки настрана разработката и тестването; ще обсъдим какво е достъпно за експлоатацията – какво може да направи сама експлоатацията и какво може да предложи на тестването, за да повлияе на качеството.
Дауntime. Заповеди на експлоатацията.
Винаги основният камък, за който днес ще говорим, е даунтаймът. Страшна дума. Ако имаме даунтайм, значи нещата не са добре. Бързаме да го отстраним, администраторите държат сървъра – дано не падне, както се пее в онази песен. Това е темата на нашия разговор днес.
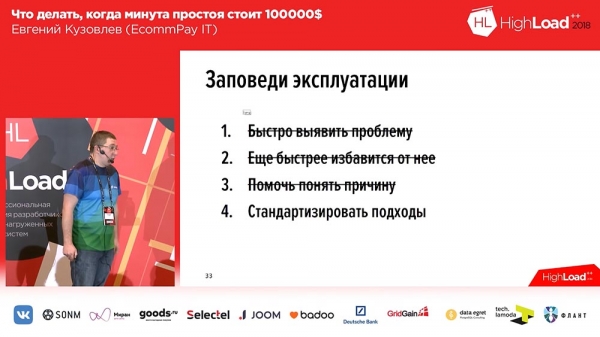
Когато започнахме да променяме подходите си, съставихме 4 заповеди. Те са представени в слайдове:
Тези заповеди са достатъчно прости:
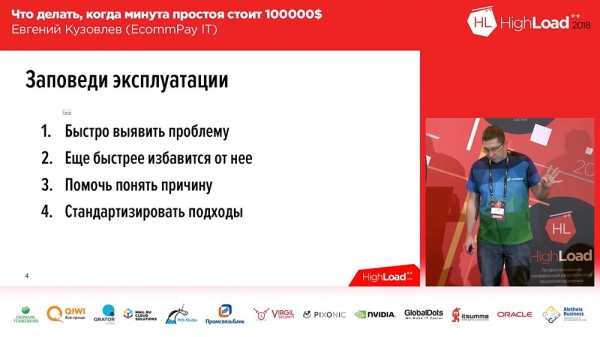
- Бързо да идентифицираме проблема.
- Още по-бързо да се отстраним от него.
- Да помогнем да се разбере причината (по-късно, за разработчиците).
- И да стандартизираме подходите.
Ще обърна внимание на точка № 2. Ние се отстраняваме от проблема, а не го решаваме. Решаването е второстепенно. За нас важното е, че потребителят е защитен от този проблем. Той ще съществува в някаква изолирана среда, но тази среда не ще контактува с него. Всъщност, ще преминем през тези четири групи проблеми (някои по-подробно, други по-малко подробно), ще разкажа какво използваме, какъв е нашият съответен опит в решенията.
Отстраняване на проблеми: когато се случват и какво да направим с тях?
Но нека да започнем не по ред, а с точка № 2 – как бързо да се справим с проблема? Имаме проблем – трябва да го решим. "Какво да правим с това?" – основният въпрос. И когато започнахме да мислим как да решим проблема, разработихме някои изисквания, на които решаването на проблеми трябва да отговаря.
За да формулираме тези изисквания, решихме да си зададем въпроса: "Кога се появяват проблеми?" И проблемите, както се оказа, възникват в четири случая:
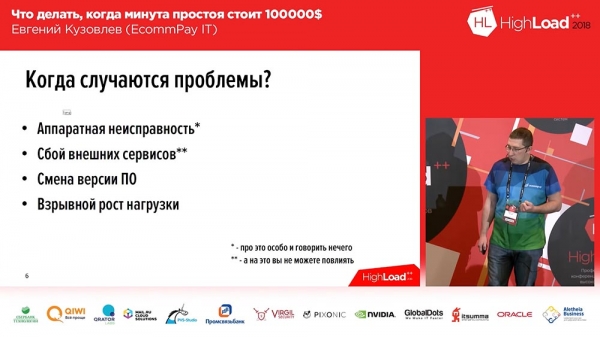
- Аппаратна неизправност.
- Сбой на външни услуги.
- Смяна на версия на софтуер (този така наречен деплой).
- Взривен ръст на натоварването.
За първите две няма да говорим. Аппаратната неизправност се решава сравнително лесно: трябва да имате всичко дублирано. Ако става въпрос за дискове – дисковете трябва да бъдат в RAID, ако е сървър – сървърът трябва да бъде дублиран, ако имате мрежова инфраструктура – трябва да поставите второ копие на мрежовата инфраструктура, т.е. вземате и дублирате. И ако нещо се провали, вие преминавате на резервните мощности. Тук е трудно да се каже нещо повече.
Вторият случай е сбой на външни услуги. За повечето системи това не е проблем, но не и за нас. Тъй като обрабатываме плащания, ние сме агрегатор, който стои между потребителя (който въвежда картовите си данни) и банките, платежните системи (като "Виза", "МастърКард", "Мир" и т.н.). Внешните ни услуги (платежни системи, банки) имат свойството да се сриват. Нито ние, нито вие (ако имате такива услуги) можем да повлияем на това.
Какво тогава да направим? Има два варианта. Първо, ако можете, трябва да дублирате тази услуга по някакъв начин. Например, ние ако можем, пренасочваме трафика от една услуга на друга: обработвали сме, например, карти през "Сбербанк", ако "Сбербанк" има проблеми – пренасочваме трафика [условно] към "Райфайзен". Второто, което можем да направим – е много бързо да забележим сбоя на външните услуги, затова ще говорим за скоростта на реакция в следващата част на доклада.
На практика от тези четири можем конкретно да повлияем на смяната на версиите на софтуера – да предприемем действия, които ще подобрят ситуацията в контекста на разгръщането и в контекста на експлозивния ръст на натоварването. Всъщност, ние именно това и направихме. Тук, отново, малко уточнение…
От тези четири проблеми няколко се решават веднага, ако имате облак. Ако сте в облаците на „Майкрософт Ажур“, „Озон“, ползвате нашите облаци, от „Яндекс“ или „Мейл“, тогава поне хардуерната неизправност става техен проблем и веднага всичко става добре от гледна точка на хардуерната неизправност.
Ние сме малко нестандартна компания. Тук всички говорят за „Кубернетс“, за облаци – ние нямаме нито „Кубернетс“, нито облаци. Затова пък имаме стойки с желязо в много дата центрове, и на това желязо сме принудени да живеем, ние сме принудени да носим отговорност за всичко това. Затова в този контекст ще поговорим. И така, за проблемите. Първите две оставяме за по-късно.
Смяна на версията на софтуера. Основи
При нас разработчиците нямат достъп до продукцията. Защо е така? Просто защото сме сертифицирани по PCI DSS, и разработчиците ни просто нямат право да се намесват в „прод“. Всичко, точка. Съвсем. Затова отговорността на разработката приключва точно в момента, в който разработката предаде билд на релиз.
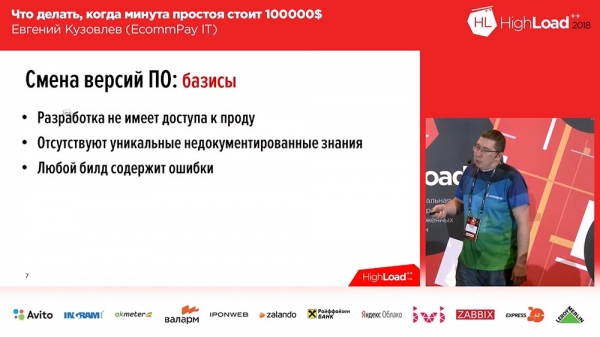
Нашият втори принцип, който също ни помага много – е, че няма уникални недокументирани знания. Надявам се и при вас да е така. Защото, ако не е – ще имате проблеми. Проблемите възникват тогава, когато тези уникални недокументирани знания не присъстват в нужното време и на нужното място. Да предположим, че един човек знае как да разгръща конкретен компонент – и този човек го няма, в отпуск е или е болен – всичко, имате проблеми.
И трети принцип, до който стигнахме. Достигнахме до него през болка, кръв, сълзи – стигнахме до извода, че всеки наш билд съдържа грешки, дори и да е без грешки. Ние решихме за себе си: когато разгръщаме нещо, когато въвеждаме нещо в продукция – нашият билд е с грешки. Сформирахме изисквания, на които нашата система трябва да отговаря.
Изисквания за смяна на версията на софтуера
Тези изисквания са три:
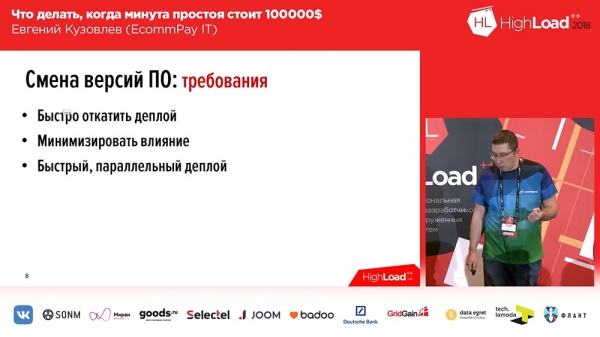
- Трябва бързо да отменим разгръщането.
- Трябва да минимизираме влиянието на неуспешното разгръщане.
- И ние трябва да имаме възможността бързо да разположим новата версия паралелно.
Точно в този ред! Защо? Защото първо, при разполагането на нова версия скоростта не е важна, но ако нещо се обърка, е важно бързо да се върнете назад с минимално въздействие. Но ако имате набор от версии на продукция, за които сте открили, че съдържат грешка (както гръм от ясно небе, разполагането не е било осъществено, но грешката е там) - за вас е важна скоростта на разполагането на следващото. Какво направихме, за да задоволим тези изисквания? Прибягнахме до такава методология:
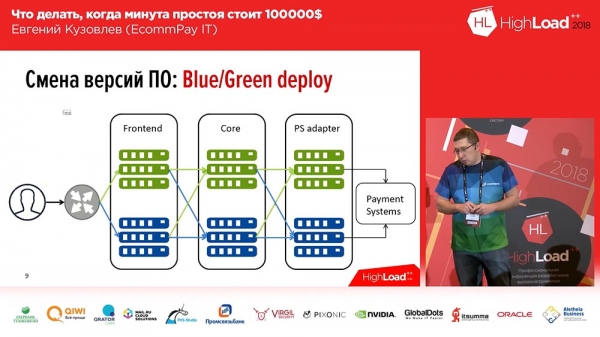
Тя е доста известна, не я изобретихме - това е Blue/Green деплой. Какво е това? За всяка група сървъри, на които стоят вашите приложения, трябва да имате копие. Копие "топло": на него няма трафик, но по всяко време този трафик може да бъде насочен към него. Това копие съдържа предишната версия. При разполагането вие качвате кода на неактивното копие. След това пренасочвате част от трафика (или целия) към новата версия. По този начин, за да промените потока на трафика от старата версия към новата, трябва да направите само едно действие: трябва да смените балансировчика в апстийм, да промените направлението - от един апстийм на друг. Това е много удобно и решава проблема с бързото прехвърляне и бързото връщане назад.Тук също е решението на втория въпрос - минимизация: можете да насочите към новата линия, новия код, само част от трафика (да речем, например, 2%). И тези 2% - те не са 100%! Ако сте загубили 100% от трафика при неуспешно разполагане - това е страшно, но ако загубите 2% от трафика - това е неприятно, но не е фатално. Освен това, потребителите вероятно дори няма да го забележат, тъй като в някои случаи (не във всички) един и същи потребител, натискайки F5, ще попадне на друга, работеща версия.
Blue/Green деплой. Роутинг
Но не всичко е толкова просто с „Blue/Green деплой“… Всички наши компоненти могат да бъдат разделени на три групи:
- това е фронтендът (страниците за плащане, които виждат нашите клиенти);
- ядрото на процесинга;
- адаптер за работа с платежни системи (банки, „MasterCard“, „Visa“…).
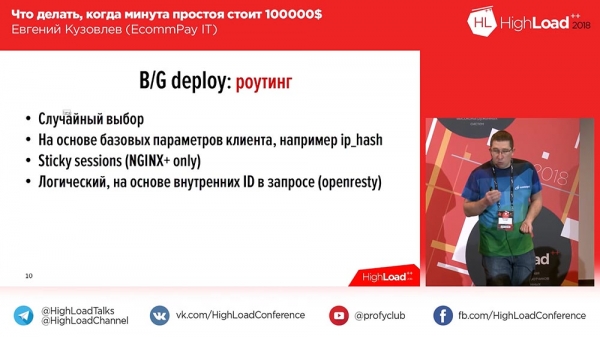
И тук има нюанс – нюансът е в маршрутизацията между линиите. Ако просто прехвърлите 100% от трафика, нямате тези проблеми. Но ако искате да пренасочите 2%, започвате да имате въпроси: „Как да го направя?“ Най-простото, направо: можете да настроите случайно разпределение, Round Robin в nginx и да имате 2% наляво, 98% надясно. Но това не винаги е подходящо.
При нас, например, потребителят взаимодейства със системата не с едно запитване. Това е нормално: 2, 3, 4, 5 запитвания – вашите системи могат да бъдат същите. И ако е важно за вас всички запитвания на потребителя да идват на същата линия, на която е дошло първото запитване, или (вторият момент) всички запитвания на потребителя да идват на нова линия след пренасочване (може да е започнал работа по-рано със системата, преди пренасочването) – тогава случайното разпределение не ви подхожда. Има следните опции:
Първият вариант, най-простият – на база основни параметри на клиента (IP Hash). Имате IP, и по айпишника разделяте надясно-наляво. Тогава ще сработи вторият описан от мен случай, когато е настъпило разгръщане, потребителят вече може да е започнал работа с вашата система, и от момента на разгръщането всички запитвания отиват на новата линия (на същата, да кажем).Ако по някакви причини това не ви подхожда и трябва задължително да изпращате запитвания на същата линия, на която дойде първичното, инитно запитване на потребителя, тогава имате два варианта…
Първият вариант: можете да вземете платен nginx+. Там има механизъм за Sticky sessions, който при първичното запитване на потребителя задава сесия на потребителя и я свързва с определен апстрийм. Всички последващи запитвания от потребителя в рамките на живота на сесията ще се изпращат на същия апстрийм, на който е била зададена сесията.Това не ни подхождаше, защото вече имахме обикновен nginx. Преходът към nginx+ не беше точно скъп, просто беше малко болезнено за нас и не много правилно. Например, „Sticky sessions“ не сработиха за нас поради простата причина, че „Sticky sessions“ не дават възможност за маршрутизиране по признака „или-или“. Може да се зададе, че правим „Sticky sessions“ например по айпишника или по айпишника и по бисквитки, или по POST параметър, но „или-или“ – там вече става по-сложно.
Затова стигнахме до четвъртия вариант. Взехме nginx на «стероиди» (т.е. openresty) – това е същият nginx, който допълнително поддържа включването на last-скриптове. Можете да напишете last-скрипт, да го подадете на този «опенрест», и този last-скрипт ще се изпълни, когато дойде заявка от потребителя.
И ние написахме такъв скрипт, инсталирахме си «опенрест» и в този скрипт преглеждаме 6 различни параметъра по конкатенацията «Или». В зависимост от наличието на единия или другия параметър, знаем, че потребителят е дошъл на една страница или на друга, на една линия или на друга.
Blue/Green внедряване. Предимства и недостатъци
Разбира се, можеше да се направи малко по-просто (да използваме същите «Стики сешнс»), но имаме и един нюанс – с нас взаимодействат не само потребителите в рамките на една обработка на една транзакция… Но и платежните системи: ние, след като обработим транзакцията (изпращайки заявка към платежната система), получаваме обратен повик.
И да кажем, ако в нашия контур можем да предадем IP адреса на потребителя във всичките заявки и на база на IP адреса на потребителите да разделим трафика, не можем да кажем на «Виза»: «Хей, ние сме такава ретро-компания, всъщност сме международни (на сайта и в Русия)… Моля, предайте ни IP адреса на потребителя допълнително в допълнително поле, вашият стандартизиран протокол»! Разбира се, те няма да се съгласят.
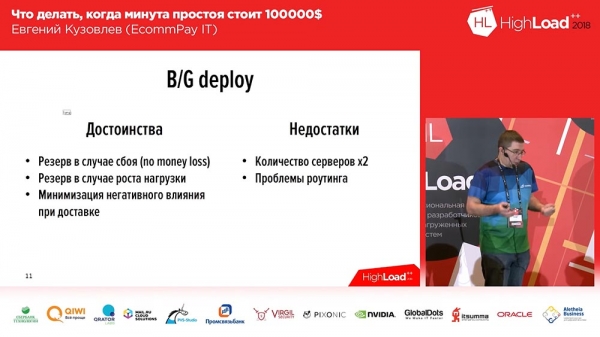
Затова това не ни подхожда – направихме openresty. Съответно, с маршрутизацията ни се получи следното:«Блу/Грийн» внедряването има, съответно, предимства, за които споменах, и недостатъци.
Недостатъците са два:
- трябва да се задълбочите в маршрутизацията;
- вторият основен недостатък – това са разходите.
Трябва ви два пъти повече сървъри, трябва ви два пъти повече операционни ресурси, трябва да отделяте двоен ресурс за поддръжка на целия този зоопарк.
Между другото, сред предимствата – още нещо, което не споменах преди: имате резерв в случай на увеличаване на натоварването. Ако имате експлозивен растеж на натоварването, и сред вас се е струпала голяма група потребители, просто включвате втора линия за разпределение 50 на 50 – и веднага имате х2 сървъра в клъстера си, докато не решите проблема с наличността на сървъри.
Как да направим бърз деплой?
Говорихме за това как да решим проблема с минимизацията и бързото върщане, но въпросът остава: "А как да се деплойва бързо"?
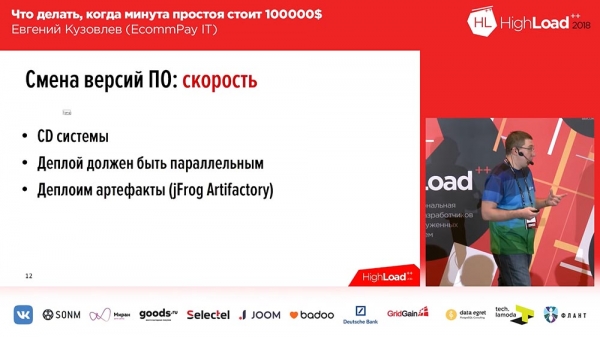
Тук е кратко и всичко е просто.- Трябва да имате CD-система (Постоянна доставка) – без нея не можете. Ако имате един сървър, можете да деплойвате ръчно. При нас има около хиляда и петстотин сървъра и ръчно не можем да правим това – разбирате, че можем да наемем отдел, който да е с размерите на тази зала, само за да деплойва.
- Деплойът трябва да е паралелен. Ако деплойвате последователно, нещата са зле. Един сървър – нормално, хиляда и петстотин сървъра ще деплойвате целия ден.
- Отново, за увеличаване на скоростта, това вече не е задължително, вероятно. При деплой обикновено се извършва компилация на проекта. Имате уеб проект, имате фронтенд част (там правите уеб пак, npm компилирате – нещо такова), и този процес в принцип не трае дълго – около 5 минути, но тези 5 минути могат да бъдат критични. Затова ние, например, не правим така: премахнахме тези 5 минути, деплойваме артефакти.
Какво е артефакт? Артефактът е събран билд, в който вече е извършена цялата компилация. Този артефакт съхраняваме в хранилище на артефакти. В миналото използвахме две такива хранилища – Nexus и сега jFrog Artifactory). "Нексус" първоначално използвахме, защото започнахме да практикуваме този подход в java-приложения (той беше подходящ за това). После добавихме част от приложенията, написани на PHP; и "Нексус" вече не беше подходящ, затова избрахме jFrog Artifactory, който може да артифактира практически всичко. Дори стигнахме до това, че в това хранилище на артефакти съхраняваме собствени бинарни пакети, които събираме за сървърите.
Експлозивен растеж на натоварването
Говорихме за смяна на версия на софтуера. Следващото, което имаме – е експлозивен растеж на натоварването. Тук вероятно разбирам под експлозивен растеж на натоварването не съвсем правилна неща…
Създадохме нова система – тя е сервизно ориентирана, стилна, красива, с работници навсякъде, опашки навсякъде, асинхронност навсякъде. В такива системи данните могат да вървят по различни потоци. За първата транзакция могат да участват 1-вият, 3-тият, 10-тият работник, а за втората транзакция – 2-ри, 4-ти, 5-ти. И днес, да предположим, сутрин имате поток от данни, който използва първите три работника, докато вечер внезапно се променя и всичко се задействува от другите три работника.
И се получава така, че трябва по някакъв начин да мащабирате работниците, необходимо е да мащабирате услугите си, като същевременно не допускате излишно увеличаване на ресурсите.
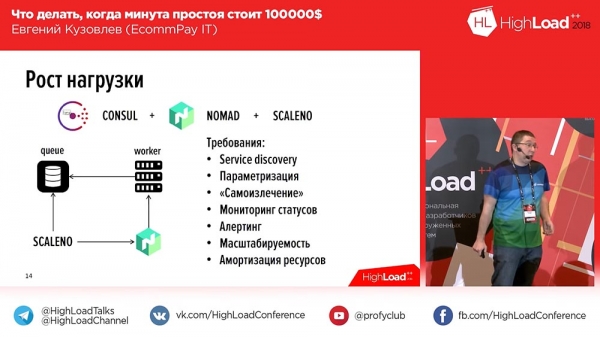
Определихме изискванията си. Тези изисквания са достатъчно прости: да има Service discovery, параметризация – всичко е стандартно за изграждане на такива мащабируеми системи, с изключение на един пункт – амортизация на ресурсите. Казахме, че не сме готови ресурсите да се амортизират, за да топлят пространството. Взехме „Консул“, взехме „Номад“, който управлява нашите работници.Защо това е проблем за нас? Нека се върна малко назад. За нас стоят в момента около 70 платежни системи. Сутрин трафикът минава през „Сбербанк“, след това „Сбербанк“ спира, например, и ние го пренасочваме към друга платежна система. Имахме 100 работника до „Сбербанк“, а след това трябва рязко да увеличим 100 работника за друга платежна система. И всичко това е желателно да става без човешка намеса. Защото, ако има човешка намеса – инженер трябва да седи 24/7 и само това да прави, тъй като такива сривове, когато 70 системи са зад вас, се случват редовно.
Затова се обърнахме към „Номад“, който има открит IP, и написахме собственото си решение Scale-Nomad – ScaleNo, което прави следното: следи растежа на опашката и намалява или увеличава броя на работниците в зависимост от динамиката на промяна на опашката. Когато го направихме, помислихме: „Може би да го направим open source?“ После го погледнахме – той е прост, като две стотинки.
Все още не сме го направили open source, но ако случайно след доклада, след осъзнаването, че ви трябва такова нещо, възникне необходимост от него, в последния слайд има моите контакти – моля, свържете се с мен. Ако се съберат поне 3-5 човека – ще го направим open source.
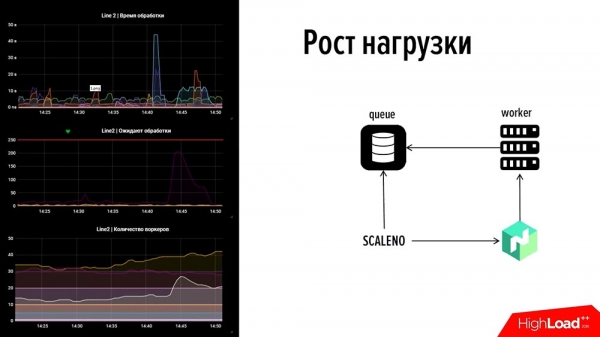
Как работи това? Нека да видим! Преди всичко: отляво има част от нашия мониторинг: една линия, отгоре – време за обработка на събития, в средата – брой транзакции, отдолу – брой работници.Ако погледнем, на тази картинка има залагане. На горния график една от линиите излезе извън границите за 45 секунди – една от платежните системи се срина. Веднага след това беше показан трафик за 2 минути и започна ръст на опашката в другата платежна система, където нямаше работници (не сме изразходвали ресурси – напротив, правилно ги използвахме). Не искахме да натоварваме – имаше минимално количество, около 5-10 работници, но те не се справяха.
На последния график се вижда „бухал“, който точно показва, че „Скалено“ удвои това количество. И после, когато графикът леко спадна, той леко намали – количеството работници беше променено автоматично. Така работи тази функция. Говорихме за точка № 2 – „Как бързо да се отстраняват причините“.
Мониторинг. Как бързо да идентифицираме проблема?
Сега първата точка – „Как бързо да идентифицираме проблема?“ Мониторинг! Трябва бързо да разберем определени неща. Какви неща трябва бързо да разберем?
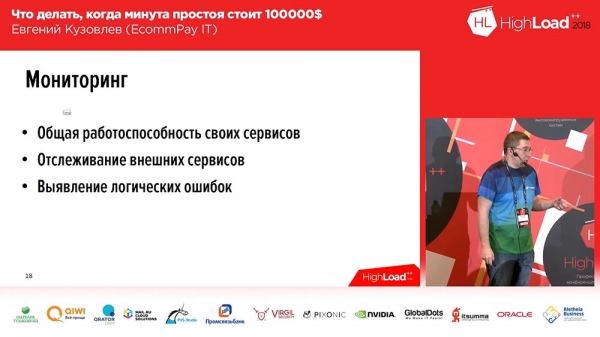
Три неща!- Трябва бързо да разберем и да разберем работоспособността на собствените си ресурси.
- Трябва бързо да разберем излизането от строя, да следим работоспособността на системите, които са външни за нас.
- Третата точка – идентификация на логически грешки. Това е, когато системата работи при вас, по всички показатели всичко е наред, но нещо не е както трябва.
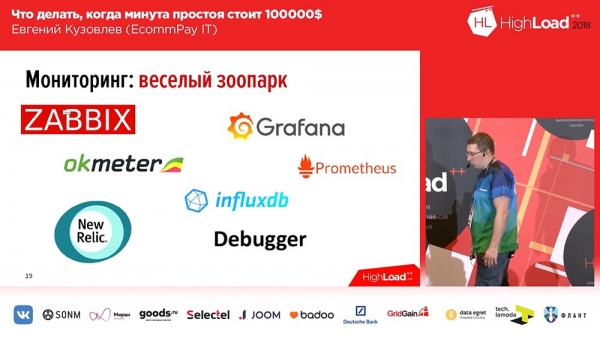
Тук вероятно не мога да кажа нещо особено интересно. Ще бъда капитан Очевидност. Търсехме какво има на пазара. Създадохме „весел зоопарк“. Ето какъв зоопарк имаме в момента:
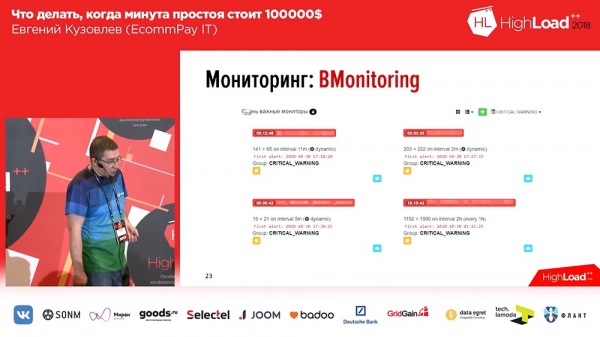
Използваме „Заббикс“ за мониторинг на „железото“, за мониторинг на основните показатели на сървърите. „Окметер“ използваме за бази данни. „Графана“ и „Прометей“ използваме за всички останали показатели, които не попадат в първите две, като част от тях – с „Графана“ и „Прометея“, друга част – „Графана“ с „Инфлюкс“ и Telegraf.Преди година искахме да използваме New Relic. Страхотен инструмент, който умееше всичко. Обаче колкото и много да може, толкова и скъпо е. Когато нараснахме до обем от 1500 сървъра, дойде вендорът и каза: „Нека сключим договор за следващата година“. Погледнахме цената и решихме, че не, така няма да стане. Сега отказваме New Relic, имаме около 15 сървъра оставени под наблюдение на New Relic. Цената се оказа напълно изкривена.
Има един инструмент, който реализирахме сами – това е Debugger. Първоначално го нарекохме „Баггер“, но след това дойде учител по английски и се засмя безкрайно, затова го преименувахме на „Дебаггер“. Какво е това? Това е инструмент, който всъщност за 15-30 секунди на всеки компонент, като „черна кутия“ на системата, пуска тестове за общата работоспособност на компонента.
Например, ако имаме външна страница (платежна страница) – просто я отваря и проверява как трябва да изглежда. Ако става въпрос за обработка, пуска тестова „транзакция“ – проверява дали тази „транзакция“ стига. Ако става дума за връзка с платежни системи – съответно пускаме тестов заявка, където можем, и следим дали всичко е наред.
Какви показатели са важни за мониторинг?
Какво основно наблюдаваме? Кои показатели са важни за нас?
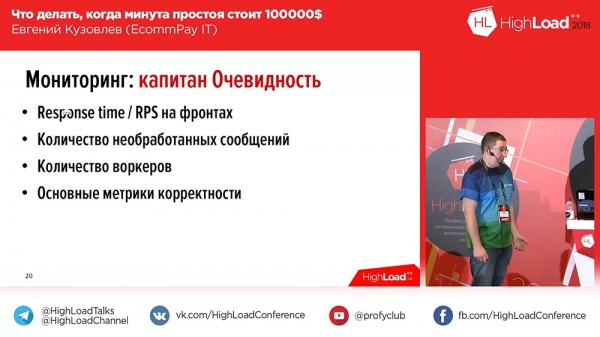
- Време за отговор / RPS на предните линии – много важен показател. Той веднага показва, че нещо не е наред.
- Броят на обработените съобщения във всички опашки.
- Броят на работниците.
- Основните метрики за коректност.
Последният пункт – „бизнесов“, „бизнесова“ метрика. Ако искате да наблюдавате същото, трябва да определите една-две метрики, които са основни за вас. Нашата метрика е проходимостта (отношението на броя успешни транзакции към общия поток транзакции). Ако в нея се променя нещо за интервал от 5-10-15 минути – значи, имаме проблеми (ако промените са съществени).
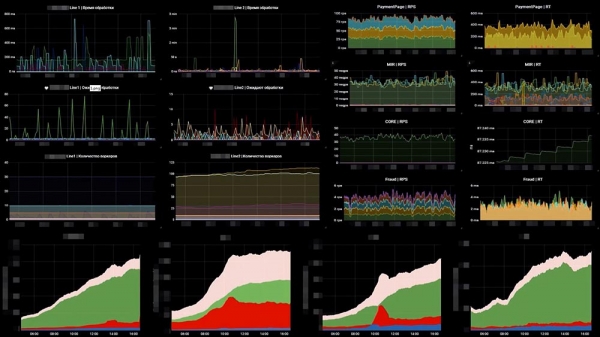
Как изглежда при нас – пример на един от нашите бордове:
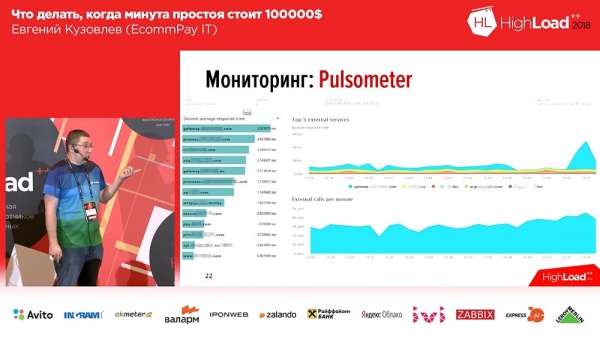
От ляво на графиката – 6 диаграми, което съответства на линиите – брой работници и брой съобщения в опашките. От дясната страна – RPS, RTS. Отдолу – същата тази метрика "бизнесова". И при "бизнесовата" метрика веднага виждаме, че нещо не е наред на двете средни диаграми... Това е именно падането на поредната система, която стои зад нас.Второто, което трябваше да направим – е да следим за падането на външни платежни системи. Тук използвахме OpenTracing – механизъм, стандарт, парадигма, която позволява трасировка на разпределени системи; и го променихме малко. Стандартната OpenTracing парадигма казва, че изграждаме трасировка на всеки отделен запит. На нас не ни беше нужно това, и го обединихме в обобщаваща трасировка, агрегационна. Създадохме инструмент, който ни позволява да следим скоростта на системите, които стоят зад нас.
Графикът ни показва, че една от платежните системи започна да отговаря за 3 секунди – имахме проблеми. В същото време, тази система реагира, когато проблемите започнат, в интервал от 20-30 секунди.И третият клас ошибки в мониторинга, който имаме – е логическият мониторинг.
Честно казано, не знаех какво да нарисувам на този слайд, защото дълго търсихме на пазара нещо, което да ни подхожда. Нищо не намерихме, затова се наложи да го направим сами.
Какво имам предвид под логически мониторинг? Представете си: правите си система (например, копие на "Тиндер"); направили сте я, пуснали сте я. Успешният мениджър Васи Пупкин я инсталира на телефона си, вижда там момиче, харесва я... а харесването отива не при момичето – харесването отива при охранителя Михалич от същия бизнес център. Мениджърът слиза надолу и после се пита: "А защо този охранител Михалич му се усмихва толкова приятно?"В такива ситуации… За нас тази ситуация звучи малко по-различно, защото (както писах) това е такава репутационна загуба, която косвено води до финансови загуби. При нас ситуацията е обратна: можем да понесем пряка финансова загуба – например, ако проведем транзакция като успешна, а тя е била неуспешна (или обратното). Трябваше да напишем собствен инструмент, който следи по бизнес показатели броя успешни транзакции в динамика за времеви интервал. Нищо на пазара не намерихме! Именно тази идея исках да предам. За решаването на подобни задачи на пазара няма нищо.
Това беше по въпроса как бързо да идентифицираме проблема.
Как да определим причините за деплоя
Третата група задачи, които решаваме, е след като идентифицираме проблема, след като сме го разрешили, би било добре да разберем причината за разработката, за тестването и да направим нещо по въпроса. Следователно, трябва да изследваме, трябва да изтеглим логовете.
Ако говорим за логовете (основната причина – логовете), основната част от логовете ни е в ELK Stack – почти всички така. При някого може би не е в ELK, но ако пишете логове в гигабайти, рано или късно ще стигнете до ELK. Ние ги пишем в терабайти.
Тук има проблем. Поправихме, коригирали сме грешката за потребителя, започнахме да разкопаваме какво е било, влязохме в 'Кибаната', въведохме id на транзакцията и получихме такава дълга поредица (показва много). И в тази дълга поредица не се разбира нищо. Защо? Защото не е ясно коя част се отнася към кой worker, коя част се отнася към кой компонент. И в този момент разбрахме, че ни е необходимо проследяване – това е именно OpenTracing, за което говорих.Помислихме за това преди година, насочихме погледа си към пазара и там открихме два инструмента – 'Зипкин' (Zipkin) и 'Егерь' (Jaeger). 'Егерь' е всъщност идеологическият наследник, идеологическото продължение на 'Зипкин'. В 'Зипкин' всичко е добре, освен това, че не може да агрегират, не може да включва логовете в трасировката, само трасировка на времето. А 'Егерь' предлага това.
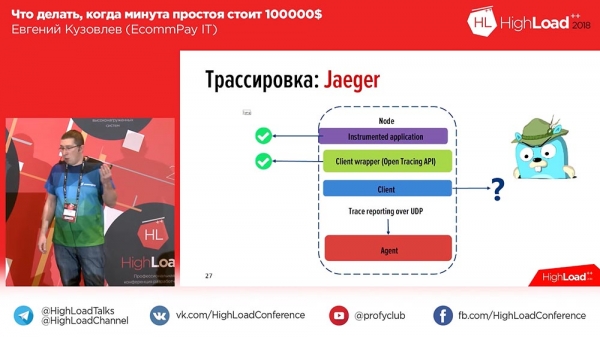
Погледнахме на „Егеря“: възможно е да се инструментират приложения, възможно е да се записват в Api (стандартът Api за PHP тогава, разбира се, не беше одобрен – това беше преди година, а сега вече е одобрен), но нямаше клиент. „Добре“, помислихме ние, и написахме собствен клиент. Какво получихме? Ето как изглежда:
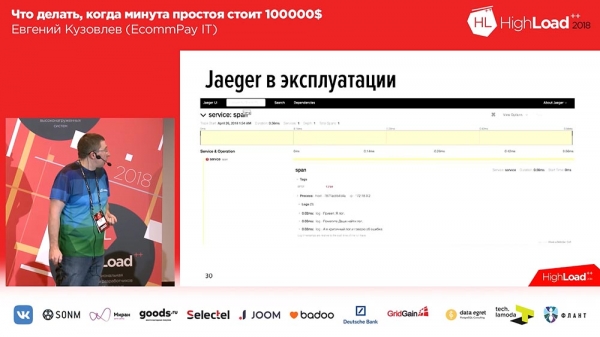
В „Егера“ за всяко съобщение се създават span-ове. Тоест, когато потребителят отвори системата, вижда един или два блока за всяко входящо запитване (1-2-3 – колкото входящи запитвания от потребителя, толкова блока). За да улесним потребителите, добавихме тагове към логовете и времевата трасировка. Съответно, в случай на грешка, нашето приложение ще маркира логовете с подходящия таг Error. Може да се филтрира по тага Error и да се покажат само спановете, които съдържат блока с грешката. Ето как изглежда, ако разгърнем span:
Вътре в спана има набор от трейсове. В този случай това са три тестови трейса, а третият трейс ни казва, че е възникнала грешка. В същото време тук виждаме и времевата трасировка: отгоре имаме времева шкала и виждаме в какъв времеви интервал е записан конкретният лог.Съответно, всичко е минало отлично. Написахме собствено разширение и го направихме с отворен код. Ако искате да работите с трасировката, ако искате да работите с „Егеря“ на PHP – имаме нашето разширение, можете да го използвате, както се казва:
Нашето разширение – това е клиент за работа с OpenTracing Api, направено като php-разширение, т.е. ще трябва да го съберете и да го подложите на системата. Преди година не имаше нищо друго. Сега се появиха и други клиенти, които са като компоненти. Въпросът е ваш: или изтегляте компонентите с composer, или използвате разширението – изборът е ваш.Корпоративни стандарти
Говорихме за три заповеди. Четвъртата заповед – да стандартизираме подходите. За какво става дума? Това е горе-долу за това:
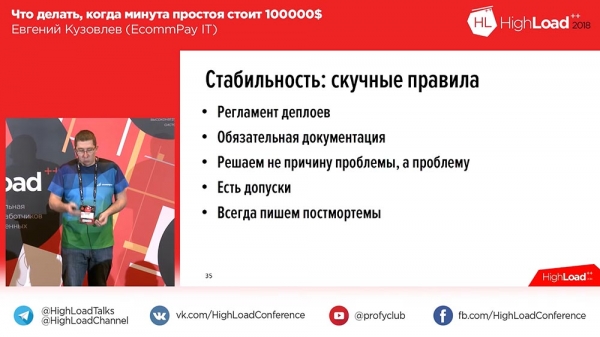
Защо тук е думата „корпоративни“? Не защото сме голяма или бюрократична компания, не! Думата „корпоративна“ исках да използвам в контекста, че всяка компания, всеки продукт трябва да има свои стандарти, и при вас също. Какви стандарти имаме ние?- Имаме регламент за деплойване. Без него не можем да се движим, не можем. Деплойваме около 60 пъти седмично, тоест деплойовете ни се случват практически постоянно. В същото време имаме, например, в регламента за деплойване забрана за деплой в петък – принципно, не деплойваме.
- Задължителна е документацията. Нито един нов компонент не попада в продукция, ако няма документация, дори ако е разработен от нашите RnD специалисти. Изискваме от тях инструкция за деплой, карта за мониторинг и приблизително описание (в какъвто формат программистите могат да напишат) как работи този компонент, как да го отстраняваме при проблеми.
- Ние решаваме не причината за проблема, а самия проблем – за което вече говорих. Важно е за нас да предпазим потребителя от проблеми.
- Имаме допуски. Например, не считаме за даунтайм, ако в продължение на две минути сме загубили 2 % от трафика. Това по принцип не попада в нашата статистика. Ако е повече в процентно отношение или времево, тогава вече го считаме.
- И винаги пишем постмортеми. Каквото и да се случи, всяка ситуация, когато нещата се държат необичайно в продукция, ще бъде отразена в постмортема. Постмортемът е документ, в който пишете какво се е случило, подробен тайминг, какво сте направили за поправка и (това е задължителен блок!) какво ще направите, за да предотвратите подобно в бъдеще. Това е задължително, необходимо за последващ анализ.
Какво се счита за даунтайм?
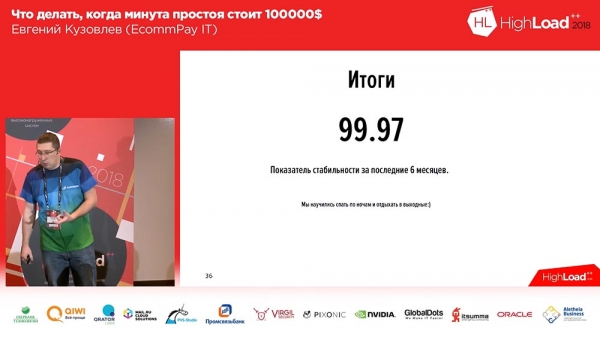
Към какво доведе всичко това?Това доведе до факта, че (изправяхме определени проблеми със стабилността, което не удовлетворяваше нито клиентите, нито нас) през последните 6 месеца нашият показател за стабилност беше 99,97. Може да се каже, че това не е много. Да, имаме с какво да се стремим. От този показател, около половината – това е стабилността, която не е наша, а на нашия уеб приложение защитен стена, който стои пред нас и се използва като услуга, но на клиентите им е все едно.
Научихме се да спим спокойно нощем. Най-накрая! Преди шест месеца не можехме. И на тази нотка с резултатите, искам да направя едно пояснение. Снощи имаше чудесно докладване за системата за управление на ядрен реактор. Ако ме чуват хората, които написаха тази система – моля, забравете за това, което казах за "2% - това не е даунтайм". За вас 2% — това е даунтайм, дори и за две минути!
Всичко това! Вашите въпроси.
За балансиращите устройства и миграцията от базата данни
Въпрос от аудиторията (нарича се В): – Добра вечер. Благодаря много за такъв администраторски доклад! Въпросът ми е кратък, на тема вашите балансиращи устройства. Споменахте, че имате WAF, значи, колкото разбирам, в ролята на балансиращо устройство ползвате нещо външно...
ЕК: – Не, в ролята на балансиращо устройство ползваме нашите собствени услуги. В този случай WAF е само инструмент за защита от DDoS.
В: – Може ли няколко думи за балансиращите устройства?
ЕК: – Както вече споменах, това е група сървъри в openresty. В момента имаме 5 резервни групи, които отговарят изключително... Тоест, сървърът, на който е инсталиран чисто openresty, единствено проксирва трафика. Следователно, за разбиране, колко трафик поддържаме: текущият ни стандартен поток трафик е няколко стотин мегабита. Те се справят, всичко е наред, дори не се напрягат.
В: – Също прост въпрос. Има Blue/Green deployment. Какво правите, например, с миграциите от базата данни?
ЕК: – Добър въпрос! Вижте, в нашия Blue/Green deployment имаме отделни опашки за всяка линия. Тоест, ако говорим за опашките за събития, които се предават от работник на работник, там има отделни опашки за синята и зелената линия. Ако говорим за самата база данни, ние нарочно я стеснихме, колкото можехме, почти всичко преместихме в опашки, в базата данни имаме само стек от транзакции. И стекът от транзакции е един за всички линии. С база данни в този контекст: не я разделяме на синя и зелена, защото и двете версии на кода трябва да знаят какво се случва с транзакцията.
Приятели, имам награда, за да ви подстегна – книга. И трябва да я връча за най-добрия въпрос.
В: – Здравейте. Благодаря за доклада. Въпросът ми е такъв. Следите плащанията, следите услугите, с които общувате... Но как наблюдавате, че човек по някакъв начин е отишъл на вашата страница за плащане, е извършил плащане, а проектът му е приспаднал парите? Тоест как наблюдавате, че marchant е достъпен и е приел вашия callback?
ЕК: – „Мерчант“ за нас в този случай е точно такъв външен сервис, както и платежната система. Ние следим скоростта на отговор на „мерчанта“.
За шифроването на базата данни
В: – Здравейте. Имам малък въпрос. Имате ли чувствителни данни по PCI DSS. Исках да разбера как съхранявате PAN номера в опашките, които трябва да предавате? Използвате ли криптиране? И оттук произлиза вторият въпрос: по PCI DSS е необходимо периодично да се пре-криптира базата при промени (уволнение на администратори и т.н.) – как става с достъпността в този случай?
ЕК: – Прекрасен въпрос! Първо, в опашките не съхраняваме PAN номера. Нямаме право да съхраняваме PAN никъде в открит вид, следователно използваме специална услуга (наричаме я „Кейдемон“) – това е услуга, която прави само едно: приема съобщение и изпраща криптирано съобщение. И именно с това криптирано съобщение съхраняваме всичко. Съответно, дължината на ключа ни е под килобайт, за да е наистина сериозно и надеждно.В: – Вече важат 2 килобайта ли?
ЕК: – Изглежда, че вчера беше 256… Докъде още?!
Съответно, това е първото. А на второ място, решението, което имаме, поддържа процедура за пре-криптиране – там има два комплекта „кекове“ (ключове), които дават „деки“, които криптират (key – това са ключовете, dek – производни на ключовете, които криптират). И при иницииране на процедурата (провежда се редовно, на всеки 3 месеца или подобно) зареждаме нов набор „кекове“, и преминаваме през пре-криптиране на данните. Имаме отделни услуги, които извлекат всички данни, криптират ги отново; до данните се съхранява идентификатор на ключа, с който са криптирани. Съответно, веднага щом данните са криптирани с новите ключове, изтриваме старите ключове.
Понякога плащанията трябва да се извършват ръчно…
В: – Тоест, ако е извършен възстановяване по определена операция, ще декриптирате с стария ключ?
ЕК: – Да.
В: – Тогава още един малък въпрос. Когато настъпи някакъв срив, падане, инцидент, е необходимо да се прокара транзакцията ръчно. Има такава ситуация.
ЕК: – Да, има.
В: – Откъде получавате тези данни? Или сами ходите ръчно в това хранилище?
ЕК: – Не, разбира се – имаме някаква бек-офис система, която съдържа интерфейс за нашата поддръжка. Ако не знаем в какъв статус е транзакцията (например, докато платежната система не отговори с таймаут) – ние принципно не знаем, т.е. окончателният статус присвояваме само при пълна убеденост. В този случай сваляме транзакцията в специален статус за ръчна обработка. Сутринта на следващия ден, щом поддръжката получи информация, че в платежната система остават такива транзакции, те ги обработват ръчно в този интерфейс.
В: – Имам няколко въпроса. Един от тях е за продължението на зоната PCI DSS: как извличате логовете от нея? Такъв въпрос, защото разработчикът е могъл да постави каквото и да било в логовете! Вторият въпрос е: как излагате хотфиксове? Ръчно в базата – това е един вариант, но могат да бъдат и безплатни хотфиксове – каква е процедурата там? И третият въпрос вероятно е свързан с RTO, RPO. Вие сте имали наличност 99,97, почти четири деветки, но разбирам, че имате и втори дата център, и трети дата център, и пети дата център… Как се занимавате с тяхната синхронизация, репликация и всичко останало?ЕК: – Нека започнем с първия. Първият въпрос беше за логовете, нали? Когато се пишат логове, имаме прослойка, която маскира всички чувствителни данни. Тя гледа по маската и по допълнителните полета. Съответно, логовете ни излизат с вече замаскирани данни и контур на PCI DSS. Това е една от регулярните задачи, която е поставена на отдела за тестване. Те са задължени да проверяват всяка задача, включително и логовете, които пишат, и това е една от регулярните задачи при код ревю, за да се контролира, че разработчикът не е записал нещо. Последваща проверка на това се извършва редовно от отдела за информационна сигурност, около веднъж седмично: вземат се логовете за последния ден на произволен принцип и те минават през специален скенер-анализатор от тестовите сървъри, за да проверят всичко това.
За hot-fix-ите. Това е включено в нашите регламенти за внедряване. Имаме отделна точка относно хотфиксовете. Считаме, че внедряваме хотфиксове денонощно, когато ни е необходимо. Веднага щом версията е компилирана, щом е преминала тестовете, щом разполагаме с артефакт – повдига се дежурен системен администратор по повикване от техническата поддръжка и той внедрява това в момента, когато е необходимо.По отношение на „четирите деветки“. Цифрата, която имаме в момента, всъщност е била постигната и стремяхме се към нея в един от центровете за данни. Сега имаме втори център за данни и започваме да маршрутизираме между тях, а въпросът за крос-центровата репликация е наистина нетривиален. Опитвахме да го решим по различни начини: опитахме да използваме същия „Тарантул“ – не се получи, веднага казвам. Затова стигнахме до извода, че правим поръчка на „сенса“ ръчно. Всяко приложение всъщност изисква необходимата синхронизация в асинхронен режим и изпраща „промяна – готово“ между центровете за данни.
В: – Ако имате втори, защо нямате трети? Защото никой не е вършил Split-brain...
ЕК: – А нямаме „Сплит-брейн“. Поради факта, че всяко приложение функционира в мулти-мастър режим, не е важно в кой център е постъпила заявката. Готови сме на това, че в случай, че един център за данни се срине (на това залагаме) и по време на заявката на потребителя преминем към втория център, сме готови да загубим този потребител, действително; но това ще бъдат единици, абсолютни единици.
В: – Добър вечер. Благодаря за доклада. Разказвахте за вашия дебъгер, който в продукция върти някакви тестови транзакции. Ами, разкажете за тестовите транзакции! Колко дълбоко отива?
ЕК: – Тя преминава през целия цикъл на компонента. За компонента няма разлики между тестова транзакция и боева. От логическа гледна точка, това е просто някакъв отделен проект в системата, в който се реализират само тестови транзакции.
В: – А къде я отсичате? Ето, Core изпрати...
ЕК: – Ние следим за „Кора“ в този случай за тестовите транзакции... Имаме такова нещо като маршрутизация: „Кор“ знае в коя платежна система да изпрати – ние изпращаме в фалшива платежна система, която просто дава http-отбивка и толкова.
В: – Кажете ли, моля, имате ли приложение, написано като един огромен монолит, или сте го разделили на някакви услуги или дори микросервизи?
ЕК: – Ние не сме монолит, разбира се, имаме приложение, ориентирано към услуги. Шегуваме се, че имаме услуги от монолити – те наистина са достатъчно големи. Не бихме могли да наречем това микросервизи, но точно това са услуги, в които работят работници на разпределени машини.
Ако услугата на сървъра е компрометирана…
В: – Тогава имам следващ въпрос. Дори и да беше монолит, вие все пак казахте, че имате много от тези instant-сървъри, всички те по принцип обработват данни, и въпросът е: "В случай на компрометиране на един от instant-сървърите или приложението, на някой отделен елемент, имат ли някакъв контрол на достъпа? Кой от тях какво може да прави? Към кого да се обръщам за какви данни?
ЕК: – Да, несъмнено. Изискванията за сигурност са доста сериозни. Първо, имаме открити движения на данни, и портовете са само тези, по които предварително предполагахме движение на трафика. Ако компонентът комуникира с базата данни (да кажем, с „Муськуло”) по 5-4-3-2, ще му бъдат отворени само 5-4-3-2, а другите портове, другите направления на движение на трафика няма да са достъпни. Освен това трябва да разберете, че в продукцията съществуват около 10 различни контура на сигурност. И дори да е компрометирано приложението по някакъв начин, не дай Боже, злонамеренецът няма да може да получи достъп до конзолата за управление на сървъра, защото това е друга мрежова зона на безопасност.В: – А мен в този контекст ме интересува повече моментът, че имате известни договори с услугите – какво могат да правят, през какви „екшъни” могат да взаимодействат помежду си… И в нормален поток определени услуги искат определен набор от „екшъни” от другата услуга. Към другите те по принцип не се обръщат в нормална ситуация, и имат различни зони на отговорност. Но ако един от тях е компрометиран, ще може ли да извика „екшъни” от тази услуга?
ЕК: Разбирам. Ако в нормална ситуация с друг сървър комуникацията изобщо е била разрешена, то – да. Според SLA договора не следим, че са ти разрешени само първите 3 действия, а 4-то действие не е разрешено. Това вероятно е излишно за нас, тъй като имаме четиристепенна система за защита в принципа за контурите. Предпочитаме да се защитаваме на ниво контури, а не на ниво интериор.
Как работят Visa, MasterCard и „Сбербанк“
В: Искам да уточня момента относно прехвърлянето на потребителя от един дата център на друг. Доколкото знам, „Виза“ и „МастърКард“ работят с бинарен синхронен протокол 8583, там стоят миксери. И исках да разбера, сега става въпрос за прехвърляне – това пряко ли е „Виза“ и „МастърКард“ или до платежните системи, до обработващите?
ЕК: Това е до міксерите. Міксерите ни стоят в един дата център.
В: Грубо казано, имате ли една точка на свързване?
ЕК: За „Виза“ и „МастърКард“ – да. Просто защото „Виза“ и „МастърКард“ изискват достатъчно сериозни инвестиции в инфраструктура за сключване на отделни договори за получаване на втора двойка миксери, например. Те са резервирани в рамките на един дата център, но ако, не дай Боже, центърът ни, където стоят миксерите за свързване с „Виза“ и „МастърКард“, спре да функционира, то връзката с „Виза“ и „МастърКард“ ще бъде загубена...
В: Как могат да бъдат резервирани? Знам, че „Виза“ позволява да се поддържа само едно свързване в принцип!
ЕК: Те сами предоставят оборудването. Във всеки случай, получихме оборудване, което е резервирано вътрешно.
В: Тоест стълбата от тях Connects Orange?
ЕК: – Да.
В: Какво обаче става в този случай: ако вашият дата център изчезне, какво да правим нататък? Или просто трафикът спира?
ЕК: Не. В такъв случай просто ще прехвърлим трафика на друг канал, който, разбира се, ще бъде по-скъп за нас, по-скъп за клиентите. Но трафикът няма да минава през нашето директно свързване с „Виза“, „МастърКард“, а през условен „Сбербанк“ (много обобщено).
Извинявайте, ако съм засегнал служителите на „Сбербанк“. Но според нашата статистика от руските банки „Сбербанк“ пада най-често. Не минава месец, без нещо да не се скапе в „Сбербанк“.

Малко реклама 🙂
Благодаря, че оставате с нас. Харесвате ли нашите статии? Искате ли да видите повече интересни материали? Подкрепете ни, като направите поръчка или я препоръчате на познати, , уникален аналог на entry-level сървъри, създаден от нас за Вас: (налични опции с RAID1 и RAID10, до 24 ядра и до 40GB DDR4).
Dell R730xd два пъти по-евтин в дата-центъра Equinix Tier IV в Амстердам? Само при нас в Нидерландия! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — от $99! Четете за това
Източник: habr.com
