

Ще разгледаме работата на Zabbix с базата данни TimescaleDB като backend. Ще покажем как да я стартирате от нулата и как да мигрирате от PostgreSQL. Също така ще предоставим сравнителни тестове за производителността на две конфигурации.
HighLoad++ Сибир 2019. Зала «Томск». 24 юни, 16:00. Тезиси и . Следващата конференция HighLoad++ ще се проведе на 6 и 7 април 2020 година в Санкт Петербург. Подробности и билети .
Андрей Гущин (по-нататък – АГ): – Аз съм инженер по техническа поддръжка на ZABBIX (по-нататък – «Заббикс»), треньор. Работя повече от 6 години в техническата поддръжка и директно съм се сблъсквал с производителността. Днес ще говоря за производителността, която може да предостави TimescaleDB в сравнение с обикновен PostgreSQL 10. Също така ще представя малко входна информация – как всъщност работи.
Основни предизвикателства пред производителността: от събиране до почистване на данни
Започваме с това, че има определени предизвикателства пред производителността, с които се сблъсква всяка система за мониторинг. Първото предизвикателство пред производителността е бързото събиране и обработка на данни.
Добрата система за мониторинг трябва бързо и навременно да получава всички данни, да ги обработва според тригерните изрази, тоест да ги обработва по определени критерии (в различни системи това е различно) и да ги съхранява в базата данни, за да може по-късно да използва тези данни.
Второто предизвикателство пред производителността е съхранението на историята. Трябва да се съхраняват данни в базата, а също така да има бърз и удобен достъп до метриките, събрани за определен период от време. Най-важното е да имате удобен достъп до тези данни, за да ги използвате в отчети, графики, тригери, в определени прагови стойности, за известия и прочие.
Третото предизвикателство пред производителността е почистването на историята, тоест когато настъпи момент, в който не е необходимо да се съхраняват подробни метрики, събрани за 5 години (даже месеци или два месеца). Някои възли от мрежата са изтрити или някои хостове, метриките вече не са нужни, защото са остарели и спират да се събират. Всичко това трябва да се почисти, за да не се разрасне базата данни до голям размер. И в общи линии почистването на историята често е сериозно изпитание за хранилището – много често оказва сериозно влияние върху производителността.
Как да решим проблемите с кеширането?
Сега ще говоря конкретно за „Zabbix“. В „Zabbix“ първият и вторият повик са решени с помощта на кеширане.
Събиране и обработка на данни – ние използваме оперативна памет за съхранение на всички тези данни. Сега ще се говори по-подробно за тези данни.
Също така на страната на базата данни има определено кеширане за основните заявки – за графики и други елементи.
Кеширане на страната на самия Zabbix-сървър: имаме ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Какво е това?
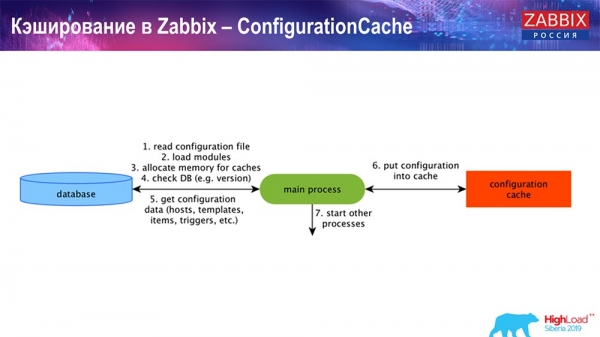
ConfigurationCache – основният кеш, в който съхраняваме метрики, хостове, елементи от данни, тригери; всичко необходимо за обработка на препроцесирането, събиране на данни от които хостове, с каква честота. Всичко това се съхранява в ConfigurationCache, за да не се налага да правим излишни запитвания към базата данни. След стартиране на сървъра, обновяваме този кеш (създаваме го) и го обновяваме периодично (в зависимост от настройките на конфигурацията).
Кеширане в Zabbix. Събиране на данни
Тук схемата е доста голяма:
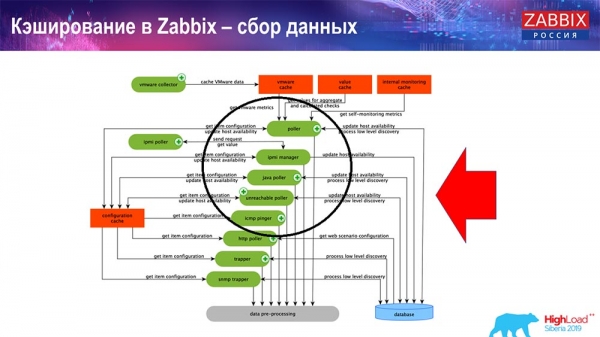
Основните в схемата – са тези събирачи:
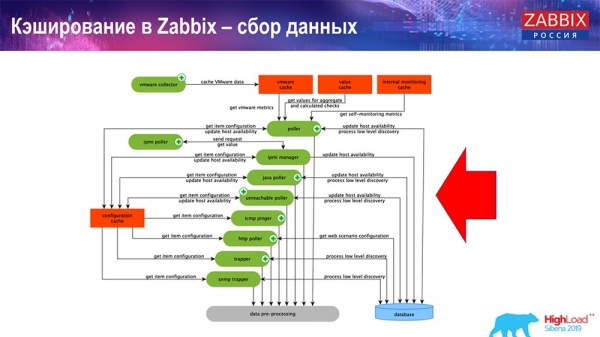
Това са самите процеси на събиране, различни „полери“, които отговарят за различни видове събирания. Те събират данни по icmp, ipmi, по различни протоколи и предават всичко на препроцесиране.
PreProcessing HistoryCache
Също така, ако имаме изчисляеми елементи от данни (онези, които познават „Zabbix“ – знаят), има изчисляеми, агрегатни елементи от данни, – ги взимаме директно от ValueCache. За това как той се запълва, ще разкажа по-късно. Всички тези събирачи използват ConfigurationCache, за да получат своите задачи и след това предават на препроцесиране.
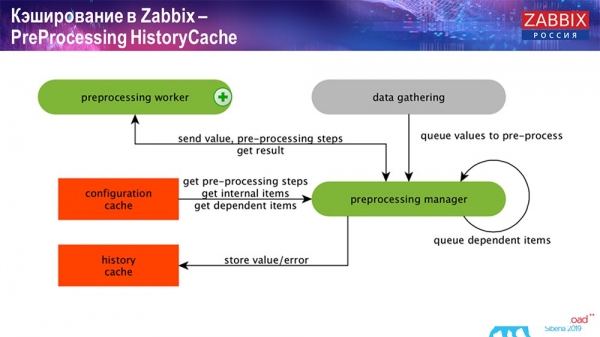
Препроцесиране също така използва ConfigurationCache, за да получи стъпките на препроцесирането, обработва тези данни по различни начини. Започвайки от версия 4.2, той е изнесен на прокси. Това е много удобно, тъй като самото препроцесиране е доста тежка операция. И ако имате много голям „Zabbix“ с много елементи от данни и висока честота на събиране, това значително улеснява работата.
Съответно, след като обработим тези данни по някакъв начин с помощта на препроцесиране, ги съхраняваме в HistoryCache, за да ги обработим по-късно. С това завършваме събирането на данни. Преминаваме към основния процес.
Работа на History syncer
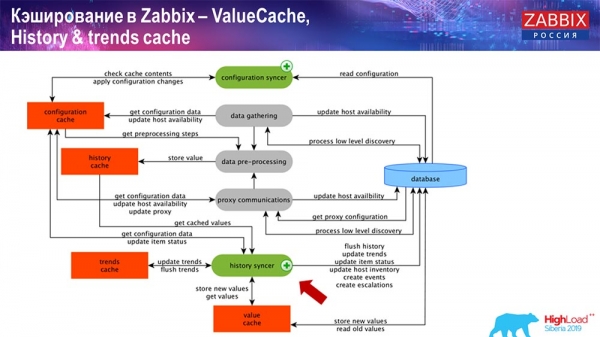
Основният процес в „Zabbix“ (тъй като е монолитна архитектура) е History syncer. Това е основният процес, който се занимава с атомарната обработка на всеки елемент от данните, тоест на всяка стойност:
- постъпва стойност (той я взима от HistoryCache);
- проверява в Configuration syncer: дали има тригери за изчисляване – изчислява ги;
ако има – създава събития, създава ескалация за създаване на уведомление, ако това е необходимо според конфигурацията; - записва тригерите за последваща обработка, агрегация; ако агрегирате за последния час и така нататък, тази стойност запомня ValueCache, за да не се обръща към таблицата на историята; по този начин, ValueCache се запълва с необходимите данни, които са нужни за изчисляване на тригерите, изчисляваните елементи и т.н.;
- след това History syncer записва всичките данни в базата данни;
- базата данни ги записва на диск – с това процесът на обработка приключва.
Бази данни. Кеширане
На страната на БД, когато искате да видите графики или някакви отчети за събития, има различни кешове. Но в рамките на тази презентация няма да говоря за тях.
За MySQL има Innodb_buffer_pool, още куп различни кешове, които също могат да бъдат настроени.
Но това са основните:
- shared_buffers;
- effective_cache_size;
- shared_pool.
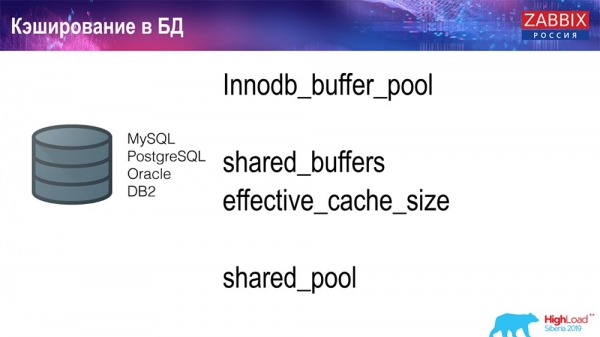
За всички бази данни посочих, че има определени кешове, които позволяват да се държат в оперативната памет данните, които често са необходими за запитвания. Там имат свои технологии за това.
За производителността на базата данни
Съответно, има конкурентна среда, тоест „Zabbix“-сървърът събира данни и ги записва. При рестартиране също чете от историята, за да напълни ValueCache и така нататък. Тук могат да имате скриптове и отчети, които използват „Zabbix“-API, който е построен на базата на уеб интерфейса. „Zabbix“-API влиза в БД и извлича необходимите данни за получаване на графики, отчети или някакъв списък със събития, последни проблеми.
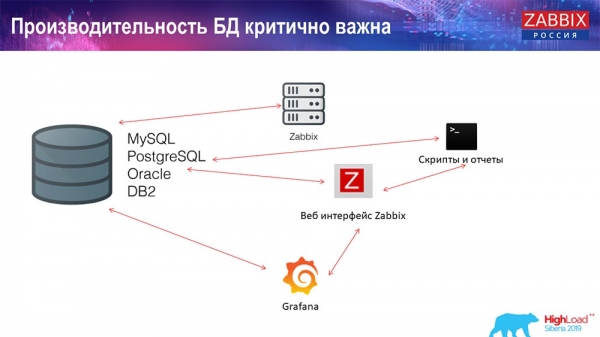
Също така е много популярно решение за визуализация – Grafana, която нашите потребители използват. Може да влиза директно както чрез „Zabbix“-API, така и чрез БД. Тя също така създава определена конкуренция за получаване на данни: необходима е по-фина, добра настройка на БД, за да отговаря на бързото извеждане на резултати и тестването.
Изчистване на историята. В Zabbix има Housekeeper
Третият метод, който се използва в «Zabbix», е изчистването на историята с помощта на Housekeeper. «Хаускиперът» спазва всички настройки, то есть в нашите данни е указан периодът за съхранение (в дни), колко дълго да се съхраняват трендовете и динамиката на промените.
Не споменах за TrendCache, който се изчислява в реално време: постъпват данни, ние ги агрегирахме за един час (предимно става въпрос за данни от последния час), средно количество / минимално и записваме това веднъж на час в таблицата за динамика на промените («Трендс»). «Хаускиперът» се стартира и изтрива данни от БД с обикновени селекции, което не винаги е ефективно.
Как да разберем, че това не е ефективно? Можете да видите на графиците за производителност на вътрешните процеси следната картина:
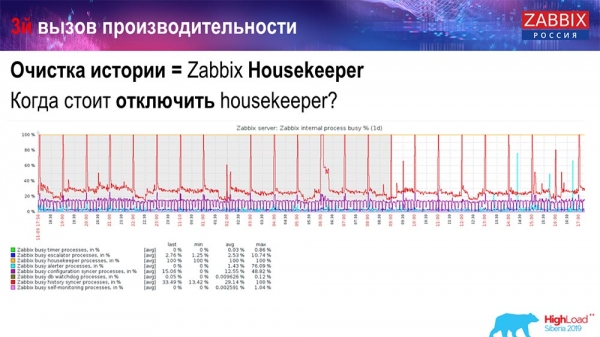
Вашият History syncer постоянно е зает (червен график). А над него е «рицарският» график. Това е «Хаускиперът», който се стартира и чака от БД да изтрие всички редове, които той е зададен.
Да вземем някакъв Item ID: нужно е да изтрием последните 5000; разбира се, по индексите. Но обикновено датасетът е доста голям – БД все пак го чете от диска и го зарежда в кеш паметта, а това е много скъпа операция за БД. В зависимост от размерите му, това може да доведе до определени проблеми с производителността.
Можете да изключите «Хаускиперът» по прост начин – имаме познатия уеб интерфейс. Настройката в Administration general (настройки за «Хаускипера») изключва вътрешната поддръжка за вътрешната история и трендовете. Съответно, «Хаускиперът» вече не управлява това:
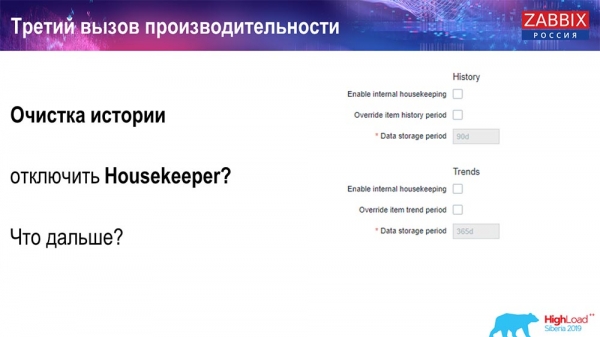
Какво може да се направи нататък? Вие сте изключили, вашите графици са се изравнили… Какви могат да бъдат по-нататъшните проблеми? Какво може да помогне?
Партициониране (секциониране)
Обикновено това се настройва на всяка релационна база данни, която изброих, по различен начин. На MySQL има своя технология. Но в общи линии те са много сходни, ако говорим за PostgreSQL 10 и MySQL. Разбира се, има много вътрешни различия как всичко това е реализирано и как то влияе на производителността. Но в общи линии, създаването на нова партиция също често води до определени проблеми.
В зависимост от вашия setup (колко много данни създавате за един ден), обикновено се настройва най-ниската стойност – 1 ден/партиция, а за „трендове“, динамика на промените – 1 месец/нова партиция. Това може да се променя, ако имате много голям setup.
Нека веднага кажа за размерите на setup: до 5000 нови стойности в секунда (nvps) – това се счита за малък „сетап“. Средният – от 5 до 25 хиляди стойности в секунда. Всичко над това – вече е големи и много големи инсталации, които изискват много внимателна настройка на базата данни.
При много големи инсталации 1 ден – може да не е оптимално. Лично съм виждал на MySQL партиции по 40 гигабайта на ден (и повече). Това е много голям обем данни, който може да доведе до проблеми. Трябва да се намалява.
Защо е нужно партициониране?
Какво дава Partitioning, мисля, че всички знаят – това е секциониране на таблици. Често това са отделни файлове на диска и спан-запроси. Той по-оптимално избира една партиция, ако попада в нормално партициониране.
За „Забикс“, в частност, се използва по рендж, по диапазон, тоест ние използваме таймстамп (обикновено число, времето от началото на епохата). Задавате начало на деня/край на деня, и това е партиция. Съответно, ако искате данни от преди два дни, всичко това се избира от базата данни по-бързо, защото трябва само един файл да се зареди в кеша и да се издаде (а не голяма таблица).
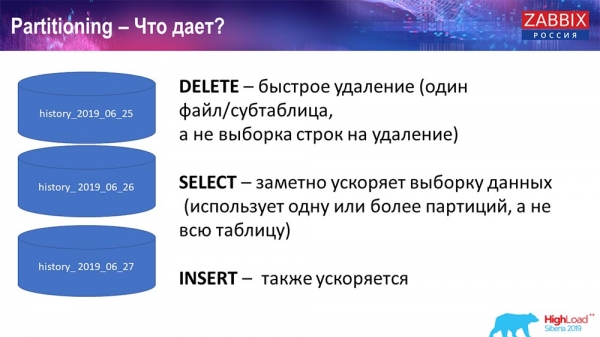
Много бази данни също ускоряват insert (вмъкване в една child-таблица). Докато говоря абстрактно, но това също е възможно. Партиционирането често помага.
Elasticsearch за NoSQL
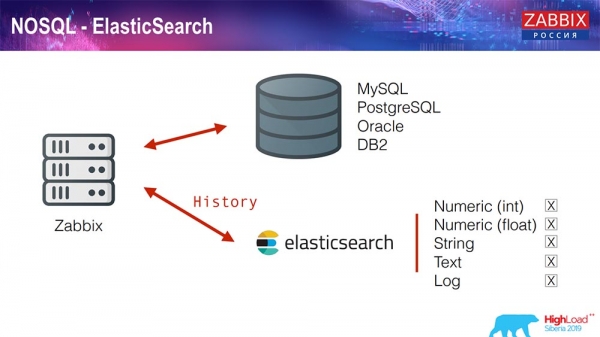
Наскоро, в 3.4, внедрихме решение за NoSQL. Добавена е възможността за запис в Elasticsearch. Можете да записвате отделни типове: избирате – или числа пишете, или някакви знаци; имаме стринг-текст, логове можете да записвате в Elasticsearch… Съответно, уеб-интерфейсът вече също ще се обръща към Elasticsearch. Това отлично работи в някои случаи, но в момента може да се използва.
TimescaleDB. Хипертаблици
За 4.4.2 обърнахме внимание на нещо, както TimescaleDB. Какво е това? Това е разширение за PostgreSQL, т.е. има нативен интерфейс на PostgreSQL. Освен това, това разширение позволява много по-ефективна работа с времеви данни и автоматично партициониране. Как изглежда това:
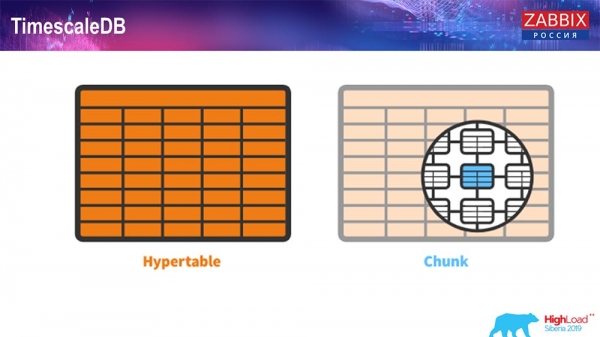
Това е hypertable – има такова понятие в Timescale. Това е хипертаблица, която създавате, и в нея се намират чанкове (chunk). Чанк-ите са партиции, това са child таблици, ако не се лъжа. Наистина е ефективно.
TimescaleDB и PostgreSQL
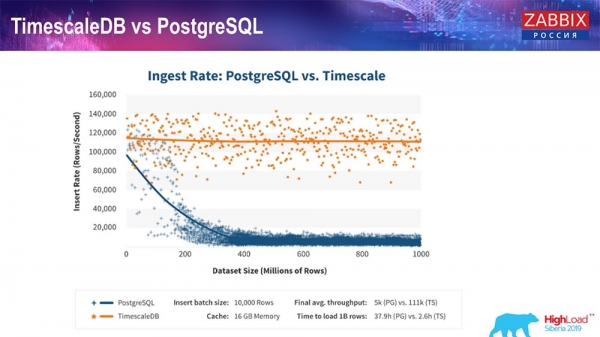
Как уверяват производителите на TimescaleDB, те използват по-правилен алгоритъм за обработка на заявки, по-специално insert-ите, който позволява почти постоянна производителност при увеличаващ се размер на dataset-вмъкването. Тоест след 200 милиона реда, обикновеният PostgreSQL започва да се представя много зле и губи производителност почти до нула, докато Timescale позволява да вмъквате инсерти възможно най-ефективно при всяко количество данни.
Как да инсталирате TimescaleDB? Всичко е просто!
В документацията му е описано – можете да го инсталирате от пакети за всякакви… Зависим е от официалните пакети на PostgreSQL. Можете да го компилирате ръчно. Така се случи, че ми се наложи да компилирам за БД.
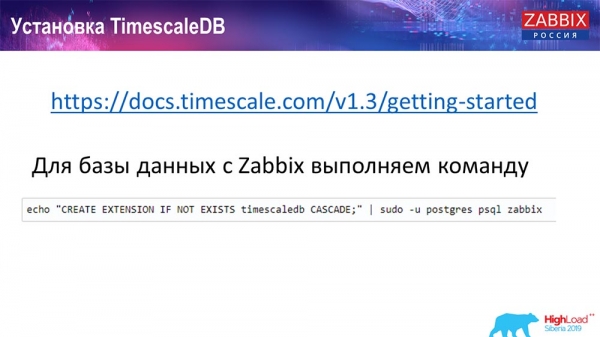
На Zabbix просто активираме Extention. Мисля, че тези, които са ползвали Extention в PostgreSQL… Просто активирате Extention, създавате го за БД Zabbix, която използвате.
И последната стъпка…
TimescaleDB. Миграция на таблици с история
Трябва да създадете hypertable. За това има специална функция – Create hypertable. В нея първият параметър указва таблицата, която е необходима в тази БД (за която да се създаде хипертаблицата).
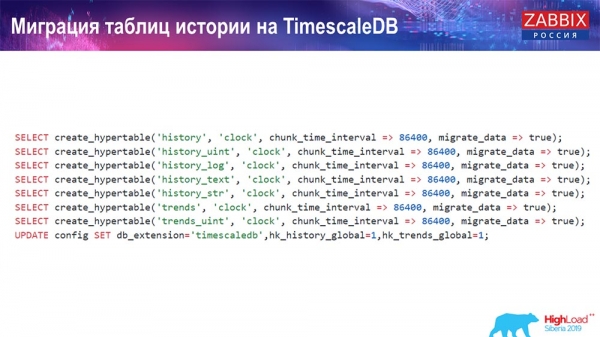
Полето, по което трябва да се създаде, и chunk_time_interval (това е интервалът на чанк-овете (партициите, които трябва да се използват). 86 400 – това е един ден.
Параметър migrate_data: ако зададете true, то пренася всички текущи данни в предварително създадените чанкове.
Аз самият използвах migrate_data – отнема значително време, в зависимост от размера на вашата БД. Имах над един терабайт – създаването отне повече от час. В някои случаи при тестването изтривах исторически данни за текст (history_text) и стринг (history_str), за да не ги пренасям – всъщност те не ме интересуваха.
И последният ъпдейт правим в нашия db_extension: поставяме timescaledb, за да може базата данни и по-специално нашият "Забикс" да разбере, че съществува db_extension. Той го активира и използва правилния синтаксис и заявки към базата данни, прилагайки вече тези "функции", които са необходими за TimescaleDB.
Конфигурация на сървъра
Използвах два сървъра. Първият сървър е виртуална машина, доста малка, с 20 процесора и 16 гигабайта оперативна памет. Настроих на нея "Постгрес" 10.8:
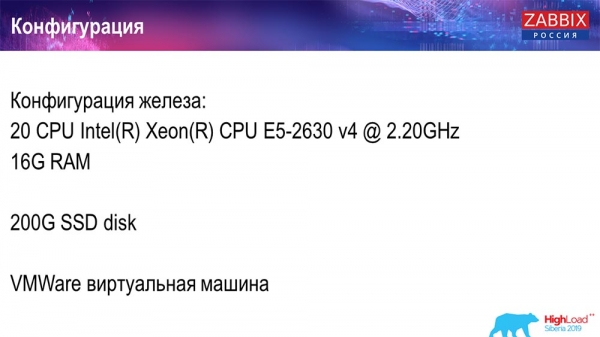
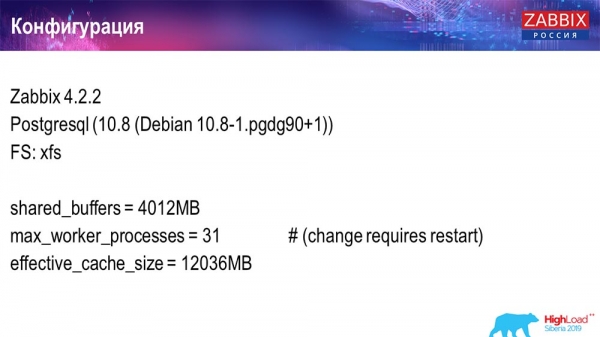
Операционната система беше Debian, файловата система – xfs. Направих минимални настройки, за да използвам именно тази база данни, без да включвам самия "Забикс". На същата машина беше инсталиран "Забикс"-сървърът, PostgreSQL и натоварващите агенти.
Използвах 50 активни агенти, които използват LoadableModule, за да генерират бързо различни резултати. Те генерираха редове, числа и така нататък. Задълбочих базата данни с голямо количество данни. Първоначалната конфигурация съдържаше 5000 елемента данни на всеки хост, и около всеки елемент данни имаше тригер – за да бъде това реална настройка. Понякога дори е необходимо да се използват повече от един тригер.
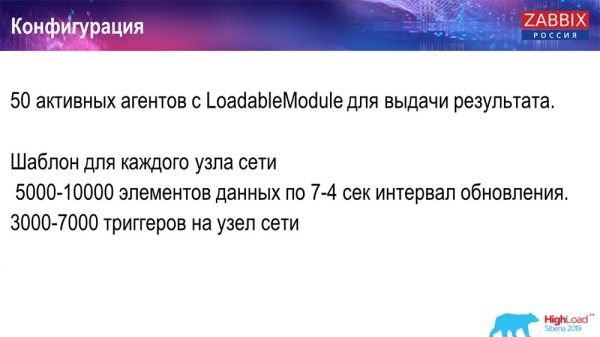
Регулирах интервала на актуализация, натоварването, като не само 50 агента използвах (добавях още), но и чрез динамични елементи данни и намалих интервала за актуализация до 4 секунди.
Тест за производителност. PostgreSQL: 36 хиляди NVPs
Първото стартиране, първата настройка беше на чист PostreSQL 10 на това оборудване (35 хиляди стойности в секунда). Както виждате на екранa, вмъкването на данни отнема части от секунди – всичко е добре и бързо, SSD дискове (200 гигабайта). Единственото, което 20 ГБ се запълват доста бързо.
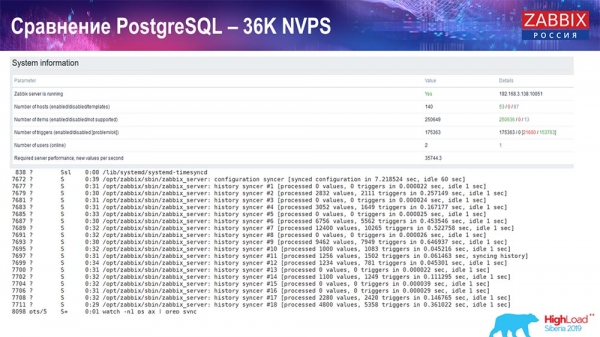
Ще има доста такива графики. Това е стандартният dashboard за производителност на "Забикс"-сървъра.
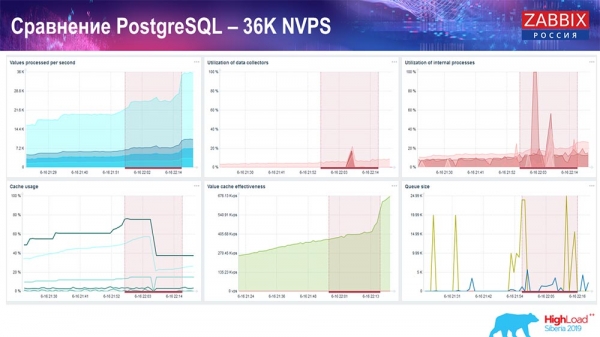
Първата графика – количество стойности в секунда (синя, горе вляво), 35 хиляди стойности в този случай. Това (горе в центъра) е натоварването на процесите на събиране, а това (горе вдясно) – натоварването именно на вътрешните процеси: history syncers и housekeeper, който тук (вдолу в центъра) е работил доста време.
Тази графика (в долния център) показва използването на ValueCache – колко хита имаше ValueCache за тригери (няколко хиляди стойности в секунда). Друг важен график е четвъртият (в долния ляв ъгъл), който показва използването на HistoryCache, за който говорих, който е буфер преди запис в базата данни.
Тест на производителността. PostgreSQL: 50 хиляди NVPs
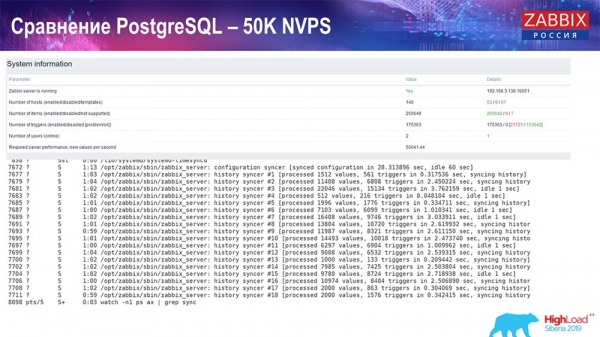
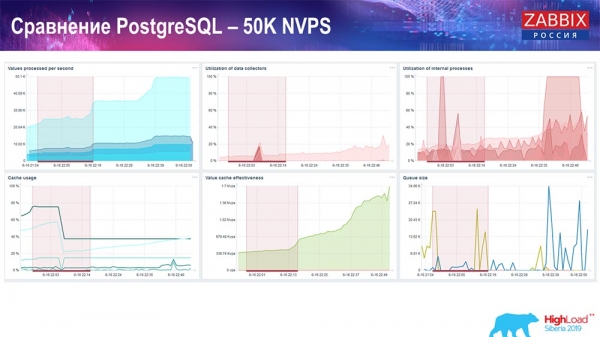
След това увеличих натоварването до 50 хиляди стойности в секунда на същото оборудване. При натоварване с „Хаускипер“ 10 хиляди стойности се записваха за 2-3 секунди с изчисление. Това, всъщност, е показано на следващия екранен снимка:
„Хаускипер“ започва да пречи на работата, но въпреки това натоварването на хистори-синкерите все още е на ниво от 60 % (третият график, в горния десен ъгъл). HistoryCache започва активно да се запълва дори по време на работата на „Хаускипера“ (в долния ляв ъгъл). Той беше около половин гигабайт, запълвайки се на 20%.
Тест на производителността. PostgreSQL: 80 хиляди NVPs
След това увеличих до 80 хиляди стойности в секунда:
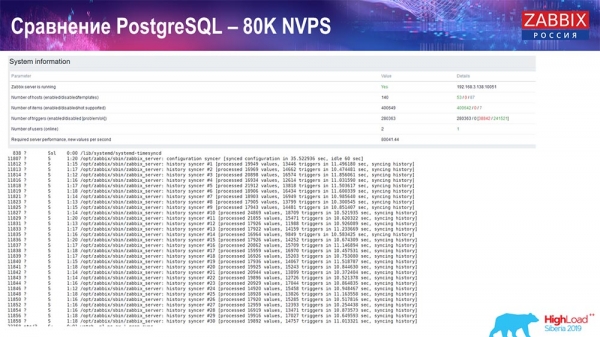
Това беше около 400 хиляди елемента данни, 280 хиляди тригери. Както виждате, натоварването на хистори-синкерите (имаше 30 броя) вече беше доста високо. След това увеличавах различни параметри: хистори-синкери, кеш... На това оборудване натоварването на хистори-синкерите започна да се покачва до максимума, практически „в полка“ – съответно, HistoryCache тръгна в много високо натоварване:
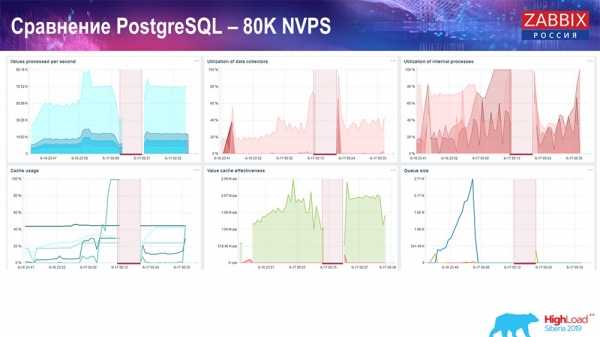
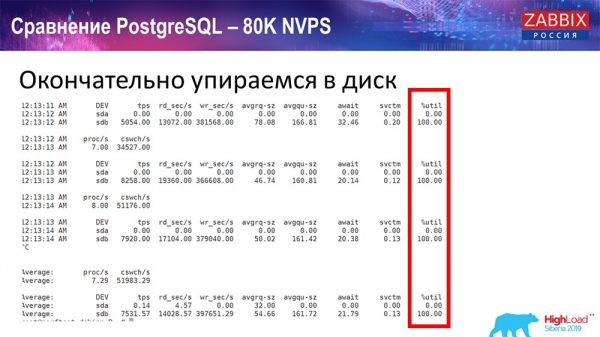
През цялото това време наблюдавах всички параметри на системата (как се използва процесорът, оперативната памет) и установих, че използването на дисковете беше максимално – постигнах максималната допустима стойност на този диск на това оборудване, на тази виртуална машина. „Постгрес“ започна при такава интензивност активно да изхвърля данни, и дискът вече не успяваше да записва, четене...
Взех друг сървър, който вече имаше 48 процесора и 128 гигабайта оперативна памет:
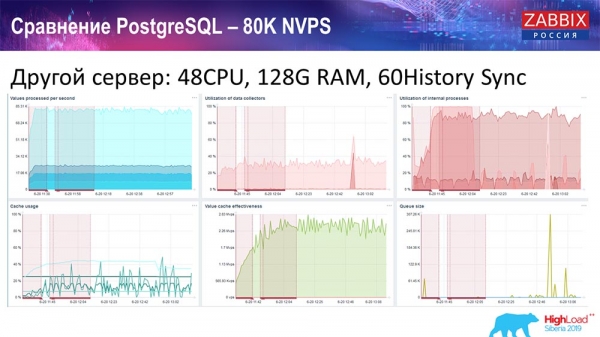
Също така го „оправих“ – инсталирах History syncer (60 броя) и постигнах приемливо представяне. Всъщност ние не сме „в полка“, но това вече е, може би, предел на производителността, където вече е необходимо да се предприемат действия.
Тест на производителността. TimescaleDB: 80 хиляди NVPs
Главната ми задача беше – да използвам TimescaleDB. На всеки график е видимо пропадане:
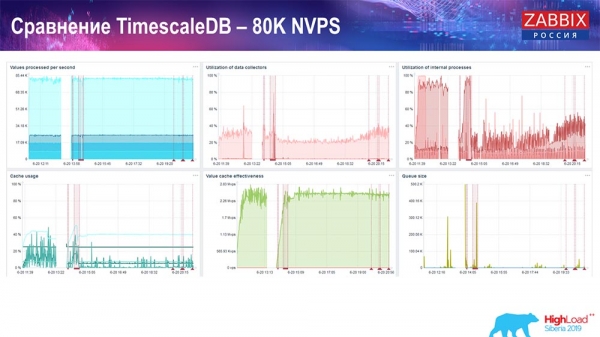
Тези провали са именно миграцията на данни. След това в сървъра на "Забикс" профилът на зареждане на хистори-сиinker-ите, както виждате, се е променил много. Той практически е три пъти по-бърз при вмъкването на данни и използва по-малко HistoryCache – съответно, данните ще пристигат навреме. Отново, 80 хиляди стойности в секунда – това е достатъчно висок рейт (разбира се, не за "Яндекс"). Като цяло, това е доста голям сетъп с един сървър.
Тест за производителността на PostgreSQL: 120 хиляди NVPs
След това увеличих стойността на елементите на данните до половин милион и получих изчислено значение от 125 хиляди в секунда:
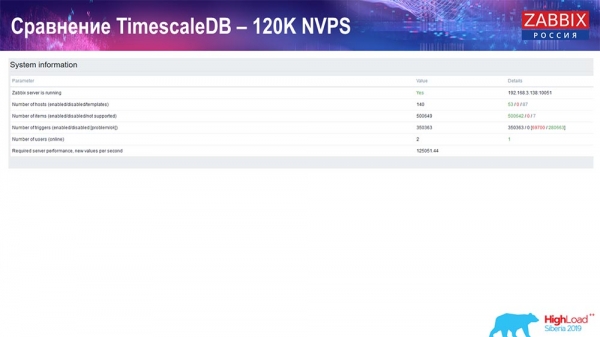
И получих такива графици:
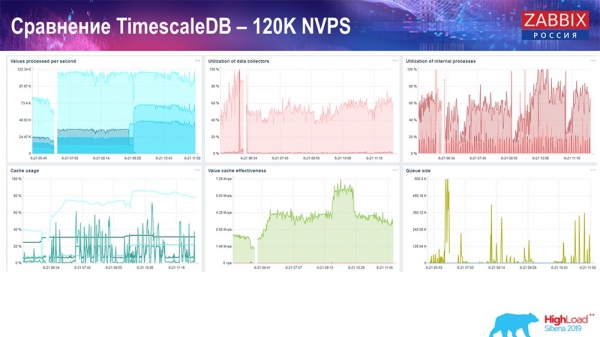
В принципе, това е работещ сетъп, който може да работи доста дълго време. Но тъй като имам диск само от 1,5 терабайта, го изразходвах за няколко дни. Най-важното е, че по това време се създаваха нови партиции на TimescaleDB, и за производителността това премина напълно незабелязано, за разлика от MySQL.
Обикновено партициите се създават през нощта, тъй като това блокира вмъкването и работата с таблиците, което може да доведе до деградация на услугата. В този случай това не е така! Основната задача беше да се провери възможностите на TimescaleDB. Получи се следната цифра: 120 хиляди стойности в секунда.
Има примери в "комньюнити":
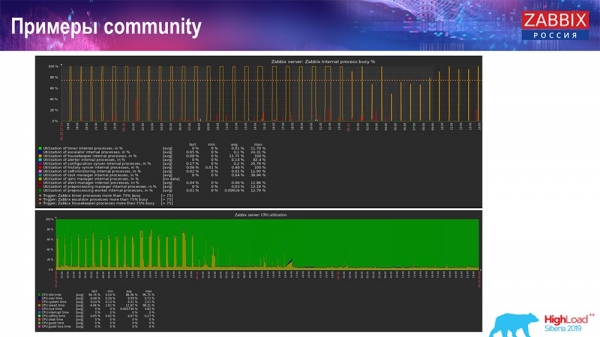
Човек също е включил TimescaleDB и натоварването по използване на io.weight спадна на процесора; и използването на елементи от вътрешните процеси също намаля поради активирането на TimescaleDB. И това са обикновени хард дискове, тоест обикновена виртуалка на обикновени дискове (не SSD)!
За някакви малки сетъпи, които се сблъскват с производителността на диска, TimescaleDB, според мен, е много добро решение. То ще позволи да продължат да работят преди да мигрират на по-бързо оборудване за базата данни.
Каня всички вас на нашите събития: Конференция – в Москва, Самит – в Рига. Ползвайте нашите канали – "Телеграм", форум, IRC. Ако имате някакви въпроси – елате при нас на щанда, можем да говорим за всичко.
Въпроси от аудиторията
Въпрос от публиката (нататък – П): – Ако TimescaleDB е толкова лесен за настройка и дава толкова голямо увеличение на производителността, може би е умно да го използваме като най-добра практика за настройка на 'Zabbix' с 'Postgres'? Има ли някакви подводни камъни и недостатъци на това решение, или все пак, ако реша да инсталирам 'Zabbix', мога спокойно да взема 'Postgres', да инсталирам 'Timescale' веднага, да го използвам и да не се притеснявам за никакви проблеми?
АГ: – Да, бих казал, че това е добра препоръка: да използвате 'Postgres' веднага с разширението TimescaleDB. Както вече споменах, много добри отзиви, въпреки че тази 'функция' е експериментална. Но всъщност тестовете показват, че това е отлично решение (с TimescaleDB) и мисля, че ще се развива! Наблюдаваме как това разширение напредва и ще коригираме всичко необходимо.
Дори по време на разработката се опирахме на една от техните известни 'функции': там можеше да се работи по малко по-различен начин с чанките. Но после те го премахнаха в следващото издание и трябваше да не се опираме на този код. Бих препоръчал да използвате това решение в много настройки. Ако използвате MySQL… за средни настройки всяко решение работи добре.
А: – На последните графики, предоставени от обществото, имаше графика с 'Housekeeper':
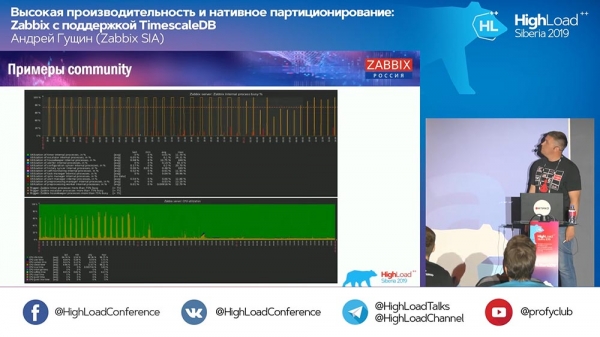
Той продължи да работи. Какво прави 'Housekeeper' в случай на TimescaleDB?
АГ: – Сега не мога да кажа точно – ще погледна кода и ще предоставя допълнителна информация. Той използва заявки именно на TimescaleDB не за премахване на чанкове, а по-скоро агрегира. Все още не съм готов да отговоря на този технически въпрос. На стенда ще уточним днес или утре.
А: – Имам подобен въпрос – за производителността при операция на изтриване в 'Timescale'.
П (отговор от публиката): – Когато изтривате данни от таблица, ако го правите чрез delete, трябва да преминете през таблицата – да изтриете, да почистите, да маркирате всичко за бъдеща вакуумизация. В 'Timescale', тъй като имате чанкове, можете да ги изтривате. Грубо казано, просто казвате на файла, който е в big data: 'Изтрий!'
„TimeScale“ просто разбира се, че такъв чанк вече няма. А тъй като той се интегрира в планиращия на заявките, той на хуковете улова вашите условия в select или в други операции и веднага разбира, че този чанк вече не съществува – „Аз няма да отида там повече!“ (данните са отсъстващи). И това е всичко! Тоест, сканът на таблицата се заменя с изтриването на бинарния файл, така че това е бързо.
А: – Вече обсъдихме темата за NoSQL. Доколкото разбирам, на „Zabbix“ не му е нужно прекалено много модифициране на данните, а всичко това е нещо като лог. Може ли да се използват специализирани бази данни, които не могат да променят своите данни, но в същото време запазват, акумулират и предоставят значително по-бързо – Clickhouse, например, нещо подобно на Kafka?.. Kafka – също е лог! Може ли да се интегрира по някакъв начин?
АГ: – Извеждане може да се направи. Имаме определена „функция“ от версия 3.4: можете да записвате всички исторически файлове, събития, всичко останало в файлове; и след това с някакъв обработчик да изпращате в друга база данни. Всъщност много хора променят и пишат директно в база данни. На лето хистори-синкери всичко това пишат в файлове, ротират тези файлове и така нататък, и можете да ги прехвърляте в „Clickhouse“. Не мога да говоря за плановете, но възможно е бъдещата поддръжка на NoSQL решения (като „Clickhouse“) да продължи.
А: – Излиза, че може да се отървем напълно от Postgres?
АГ: – Разбира се, най-трудната част в „Zabbix“ са историческите таблици, които създават най-много проблеми, и събитията. В този случай, ако не съхранявате събития дълго време и съхранявате история с трендове в някакво друго бързо хранилище, то като цяло не би трябвало да имате никакви проблеми.
А: – Можете ли да оцените колко по-бързо ще работи всичко, ако преминем на „Clickhouse“, например?
АГ: – Не съм тествал. Мисля, че най-малкото същите цифри могат да се постигнат доста лесно, предвид, че „Clickhouse“ има свой интерфейс, но не мога да кажа със сигурност. Най-добре е да се направят тестове. Всичко зависи от конфигурацията: колко хостове имате и така нататък. Вмъкването – това е едно, но трябва и да вземате тези данни – Grafana или нещо друго.
А: – Тоест, става дума за равна конкуренция, а не за голямо предимство на тези бързи бази данни?
АГ: – Мисля, че когато интегрираме, ще имаме по-точни тестове.
А: – Къде отиде старият добър RRD? Какво накара да преминем на SQL бази данни? Първоначално всички метрики се събираха на RRD.
АГ: – В „Zabbix“ RRD, може би, е бил в много стара версия. Винаги е имало SQL бази – класическият подход. Класическият подход е MySQL, PostgreSQL (вече съществуват от доста време). Имаме общ интерфейс за SQL бази данни, а RRD практически никога не сме използвали.

Малко реклама 🙂
Благодаря, че оставате с нас. Харесвате ли нашите статии? Искате ли да видите повече интересни материали? Подкрепете ни, като направите поръчка или я препоръчате на познати, , уникален аналог на entry-level сървъри, създаден от нас за Вас: (налични опции с RAID1 и RAID10, до 24 ядра и до 40GB DDR4).
Dell R730xd два пъти по-евтин в дата-центъра Equinix Tier IV в Амстердам? Само при нас в Нидерландия! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — от $99! Четете за това
Източник: habr.com
