

Продължаваме серията от статии, посветени на изследването на малко известни методи за подобряване на производителността на „изглежда прости“ запитвания в PostgreSQL:
Не си мислете, че така не обичам JOIN… 🙂
Но често без него запитването е значително по-ефективно, отколкото с него. Затова днес ще опитаме изобщо да се отървем от ресурсоемкия JOIN — с помощта на речник.
Започвайки от PostgreSQL 12, част от описаните по-долу ситуации може да се възпроизвеждат малко по-различно заради . Тази функционалност може да бъде възстановена с указване на ключ
MATERIALIZED.
Много „факти“ по ограничен речник
Нека вземем напълно реална практически задача — трябва да извлечем списък или активни задачи с податели:
25.01 | Иванов И.И. | Подгответе описание на нов алгоритъм.
22.01 | Иванов И.И. | Напишете статия за Хабр: живот без JOIN.
20.01 | Петров П.П. | Помогнете да оптимизирате запитването.
18.01 | Иванов И.И. | Напишете статия за Хабр: JOIN с оглед разпределението на данните.
16.01 | Петров П.П. | Помогнете да оптимизирате запитването.
В абстрактния свят авторите на задачите трябва да са разпределени равномерно между всички служители на нашата организация, но в реалността задачите идват, като правило, от сравнително ограничен брой хора — „от началството“ нагоре по иерархията или „от съседите“ от съседни отдели (аналитици, дизайнери, маркетинг и др.).
Нека приемем, че в нашата организация от 1000 човека само 20 автори (обикновено дори по-малко) поставят задачи на всеки конкретен изпълнител и , за да ускорим „традиционното“ запитване.
Скрипт-генератор
-- служители
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- задачи с указанным распределением
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Ще покажем последните 100 задачи за конкретен изпълнител:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 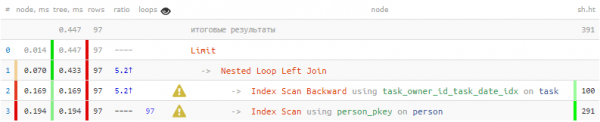
Следователно 1/3 от общото време и 3/4 от четенията страници данни бяха направени само за да се търси автора 100 пъти — за всяка изведена задача. Но знаем, че сред тази стотица има само 20 различни — не можем ли да използваме тази информация?
hstore-словарь
Ще се възползваме от за генериране на „словаря“ ключ-стойност:
CREATE EXTENSION hstoreВ словаря ни е достатъчно да сложим ID на автора и името му, за да можем по-късно да извлечем по този ключ:
-- формираме целевата извадка
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- формираме речника за уникални стойности
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- получаваме свързаните стойности на речника
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> ключ
FROM
T; 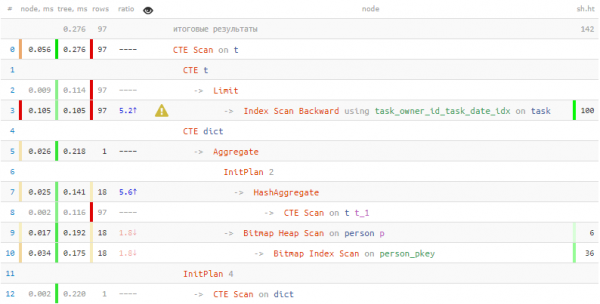
За получаване на информация за персоните е изразходвано в 2 пъти по-малко време и в 7 пъти по-малко данни! Освен „речниковането“, тези резултати ни помогнаха да постигнем и масово извлечение на записи от таблицата за един единствен проход с помощта на = ANY(ARRAY(...)).
Записи на таблицата: сериализация и десериализация
Но какво да правим, ако трябва да запазим в речника не едно текстово поле, а цяла записка? В такъв случай ни помага способността на PostgreSQL да работи с запис на таблицата като с единно значение:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- магия #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- магия #2
FROM
  T;
Нека разберем какво се случи тук:
- Взехме p като алиас за цялата записка на таблицата person и събрахме от тях масив.
- Този масив от записи беше прекастиран в масив от текстови низове (person[]::text[]), за да го поставим в hstore-дума като масив от стойности.
- При получаване на свързана записа, ние го извлякохме от думата по ключа като текстов низ.
- Текстът трябва да превърнем в стойност от тип таблица person (за всяка таблица автоматично се създава съответстващ тип).
- „Развихме“ типизираната записа в колони с помощта на
(...).*.
json-дума
Но такъв трик, какъвто приложихме по-горе, няма да сработи, ако няма съответстващ табличен тип, за да направим „раскастовка“. Същата ситуация ще възникне и ако като източник на данни за сериализация се опитаме да използваме CTE низ, а не „истинска“ таблица..
В този случай ни помагат :
, p AS ( -- това вече е CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- сега това вече е json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- и вътре json за всеки ред
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- извлякохме от думата като json
      ) AS j(name text, birth_date date) -- попълнихме нужната структура
  ) j;
Трябва да отбележим, че при описанието на целевата структура можем да изброим не всички полета на изходния низ, а само тези, които наистина ни трябват. Ако обаче имаме „родна“ таблица, по-добре е да използваме функцията json_populate_record.
Достъпът до думата все още е еднократен, но разходите за json-[де]сериализация са доста големи, затова такъв начин е разумно да се използва само в някои случаи, когато „честният“ CTE Scan показва по-лоши резултати.
Тестуваме производителността
И така, получихме два начина за сериализация на данни в дума — hstore / json_object. Освен това самите масиви от ключове и стойности могат да бъдат генерирани също по два начина, с вътрешно или външно преобразуване в текст: array_agg(i::text) / array_agg(i)::text[].
Нека проверим ефективността на различните видове сериализация на чисто синтетичен пример — сериализираме различен брой ключове:
С СЪДЕРЖАНИЕ dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Оценъчен скрипт: сериализация
С C T AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 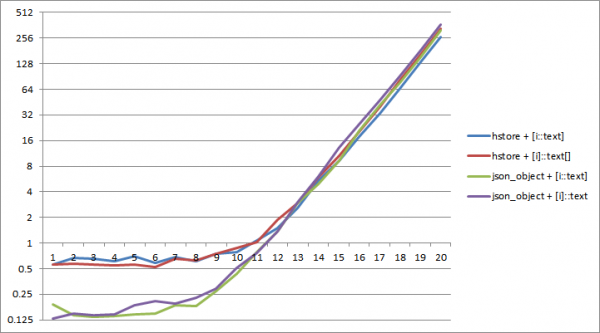
На PostgreSQL 11 примерно до размера словаря в 2^12 ключей сериализация в json требует меньше времени. При этом наиболее эффективной является комбинация json_object и «внутреннего» преобразования типов array_agg(i::text).
Теперь давайте попробуем прочитать значение каждого ключа по 8 раз — ведь если к словарю не обращаться, то зачем он нужен?
Оценочный скрипт : чтение из словаря
С C T AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::text
              FROM
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 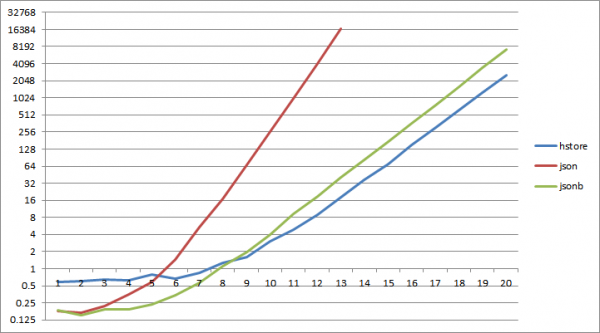
И… уже примерно при 2^6 ключей чтение из json-словаря начинает кратно проигрывать чтению из hstore, для jsonb то же самое происходит при 2^9.
Итоговые выводы:
- если надо сделать JOIN с многократно повторяющимися записями — лучше использовать «ословаривание» таблицы
- если ваш словарь ожидаемо маленький и читать вы из него будете немного — можно использовать json[b]
- во всех остальных случаях hstore + array_agg(i::text) будет эффективнее
Източник: habr.com
