

Периодично се появява нуждата от намирането на свързани данни по набор от ключове, докато не съберем необходимо общо количество записи.
Най-„живият“ пример — да изведем 20-те най-стари задачи, които са в списъка на служителите (например, в рамките на едно подразделение). За различни управленски „дъски“ с кратки резюмета по области на работа подобна тема е необходима доста често.
В статията ще разгледаме реализацията на PostgreSQL на „наивния“ вариант за решаване на такава задача, „по-умния“ и съвсем сложния алгоритъм „цикъл“ на SQL с условие за изход от намерените данни, който може да бъде полезен както за общо развитие, така и за прилагане в други подобни случаи.
Да вземем тестов набор от данни от . За да не „скачат“ извежданите записи от път до път при съвпадение на сортираните стойности, ще разширим предметния индекс, добавяйки първичен ключ. В допълнение, това веднага ще му придаде уникалност и ще ни гарантира недвусмисленост на реда на сортиране:
CREATE INDEX ON task(owner_id, task_date, id);
-- а стария - ще изтрием
DROP INDEX task_owner_id_task_date_idx;
Както се чува, така и се пише
Първо, да начертаем най-простия вариант на заявка, предавайки ID на изпълнителите :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 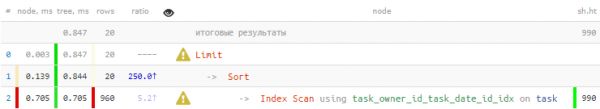
Малко тъжно — поръчахме само 20 записи, а Index Scan ни върна 960 реда, които след това още трябваше да сортираме... А нека да опитаме да четем по-малко.
unnest + ARRAY
Първата идея, която ще ни помогне — ако ни трябват само 20 сортирани записи, достатъчно е да четем не повече от 20 сортирани в същия ред по всеки ключ. За щастие, имаме подходящ индекс (owner_id, task_date, id).
Ще използваме същия механизъм за извличане и „разгъване в колони“ на цялостната таблица, какъвто е и в . И също така ще приложим свиването в масив с помощта на функцията ARRAY():
WITH T AS (
  SELECT
    unnest(ARRAY(
      SELECT
        t
      FROM
        task t
      WHERE
        owner_id = unnest
      ORDER BY
        task_date, id
      LIMIT 20 -- ограничаваме тук...
    )) r
  FROM
    unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
)
SELECT
  (r).*
FROM
  T
ORDER BY
  (r).task_date, (r).id
LIMIT 20; -- ... и тук - също 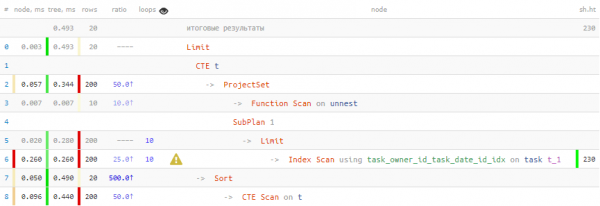
О, вече е много по-добре! С 40% по-бързо, и 4.5 пъти по-малко данни се наложи да четем.
Материализация на записи от таблици чрез CTEЩе обърна внимание, че в някои случаи Опитът да се работи веднага с полетата на записа след търсенето му в подзапрос, без "обвиването" в CTE, може да доведе до "умножаване" на InitPlan пропорционално на броя на тези полета:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Резултат (разходи=4.77..4.78 редове=1 ширина=16) (действително време=0.063..0.063 редове=1 цикли=1)
Буфери: споделени хити=16
InitPlan 1 (върща $0)
-> Ограничение (разходи=0.42..1.19 редове=1 ширина=48) (действително време=0.031..0.032 редове=1 цикли=1)
Буфери: споделени хити=4
-> Индексно сканиране с използване на task_owner_id_task_date_id_idx върху task t (разходи=0.42..387.57 редове=500 ширина=48) (действително време=0.030..0.030 редове=1 цикли=1)
Индексна условие: (owner_id = 1)
Буфери: споделени хити=4
InitPlan 2 (върща $1)
-> Ограничение (разходи=0.42..1.19 редове=1 ширина=48) (действително време=0.008..0.009 редове=1 цикли=1)
Буфери: споделени хити=4
-> Индексно сканиране с използване на task_owner_id_task_date_id_idx върху task t_1 (разходи=0.42..387.57 редове=500 ширина=48) (действително време=0.008..0.008 редове=1 цикли=1)
Индексна условие: (owner_id = 1)
Буфери: споделени хити=4
InitPlan 3 (върща $2)
-> Ограничение (разходи=0.42..1.19 редове=1 ширина=48) (действително време=0.008..0.008 редове=1 цикли=1)
Буфери: споделени хити=4
-> Индексно сканиране с използване на task_owner_id_task_date_id_idx върху task t_2 (разходи=0.42..387.57 редове=500 ширина=48) (действително време=0.008..0.008 редове=1 цикли=1)
Индексна условие: (owner_id = 1)
Буфери: споделени хити=4
InitPlan 4 (върща $3)
-> Ограничение (разходи=0.42..1.19 редове=1 ширина=48) (действително време=0.009..0.009 редове=1 цикли=1)
Буфери: споделени хити=4
-> Индексно сканиране с използване на task_owner_id_task_date_id_idx върху task t_3 (разходи=0.42..387.57 редове=500 ширина=48) (действително време=0.009..0.009 редове=1 цикли=1)
Индексна условие: (owner_id = 1)
Буфери: споделени хити=4
Една и съща запис „потърсена“ 4 пъти... До PostgreSQL 11 това поведение се среща редовно, а решението е "обвиването" в CTE, което е безусловна граница за оптимизатора в тези версии.
Рекурсивен акумулатор
В предишната версия общо прочетохме 200 реда за нужните 20. Вече не 960, но все пак по-малко — възможно ли е?
Нека опитаме да използваме знанието, че ни трябват общо 20 записи. Тоест ще итерираме четенето на данни само до достигането на необходимото количество.
Стъпка 1: началният списък
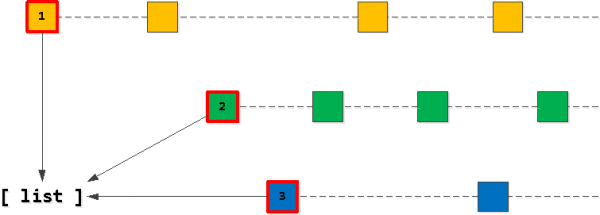
Очевидно е, че нашият "целеви" списък от 20 записа трябва да започне с "първоначалните" записи според един от нашите ключове owner_id. Затова първо да намерим такива "най-първите" за всеки от ключовете и да ги запишем в списък, сортирайки го в реда, който искаме — (task_date, id).
Стъпка 2: намираме "следващите" записи
Сега, ако вземем първата записка от нашия списък и започнем "да напредваме" по индекса с запазване на ключа owner_id, то всички намерени записи — точно следващите в резултатната селекция. Разбира се, само докато не пресечем приложен ключ втората запис в списъка.
Ако се е получило така, че сме "пресекли" втората запис, то последната прочетена запис трябва да бъде добавена в списъка вместо първата (с същия owner_id), след което списъка отново се сортира.
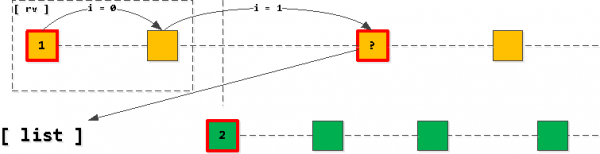
Тоест, винаги имаме, че в списъка има не повече от една запис по всеки от ключовете (ако записите свършат, а ние не сме "пресекли", то от списъка просто ще изчезне първата запис и нищо няма да се добави), като те винаги са сортирани в реда на нарастващия приложен ключ (task_date, id).
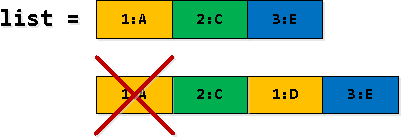
Стъпка 3: филтрираме и "разгъваме" записите
В част от редовете на нашия рекурсивен избор, някои записи rv се дублират — първо намираме такива, които "пресичат границата на 2-рия запис в списъка", а след това подменяме като 1-ва от списъка. Така първото появяване трябва да се филтрира.
Страшен финален запит
С РЕКУРСИВНА T AS (
  -- #1 : добавяме в списъка "първоначалните" записи за всеки от ключовете на набора
  С.wrap AS ( -- "материализираме" записите, за да не се умножават InitPlan/SubPlan при достъпа до полетата
    С T AS (
      ИЗБЕРИ
        (
          ИЗБЕРИ
            r
          ОТ
            task r
          КЪДЕ
            owner_id = unnest
          РЕД ПО
            task_date, id
          ОГРАНИЧИ 1
        ) r
      ИЗОБРАЖЕНИЕ
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    ИЗБЕРЕТЕ
      array_agg(r РЕД ПО (r).task_date, (r).id) списък -- сортираме списъка в необходимия ред
    ОТ
      T
  )
  ИЗБЕРЕТЕ
    списък
  , списък[1] rv
  , ЛЪЖА not_cross
  , 0 размер
  ОТ
    wrap
СЪЮЗ ВСИЧКИ
  -- #2 : четем записите на 1-я по ред ключ, докато не преминем на записа на 2-я
  ИЗБЕРЕТЕ
    СЛУЧАЙ
      -- ако не е намерено нищо за ключа на 1-я запис
      КОГАТО X._r НЕ Е РАЗЛИЧНО ОТ NULL ТОГАВА
        T.списък[2:] -- премахваме я от списъка
      -- ако НЕ сме пресекли приложния ключ на 2-я запис
      КОГАТО X.not_cross ТОГАВА
        T.списък -- просто продължаваме със същия списък без модификации
      -- ако в списъка вече няма 2-я запис
      КОГАТО T.списък[2] Е NULL ТОГАВА
        -- просто връщаме празен списък
        '{}'
      -- пренареждаме речника, премахвайки 1-я запис и добавяйки последния от намерените
      ИНАЧЕ (
        ИЗБЕРЕТЕ
          coalesce(T.списък[2] || array_agg(r РЕД ПО (r).task_date, (r).id), '{}')
        ОТ
          unnest(T.списък[3:] || X._r) r
      )
    КРАЙ
  , X._r
  , X.not_cross
  , T.размер + X.not_cross::integer
  ОТ
    T
  , LATERAL(
      С.wrap AS ( -- "материализираме" запис
        ИЗБЕРИ
          СЛУЧАЙ
            -- ако наистина "преминем" през 2-я запис
            КОГАТО НЕ T.not_cross
              -- то необходимият запис е първият от списъка
              ТОГАВА T.списък[1]
            ИНАЧЕ ( -- ако не сме пресекли, ключът остана същият като в предишния запис - разчитаме на него
              ИЗБЕРЕТЕ
                _r
              ОТ
                task _r
              КЪДЕ
                owner_id = (rv).owner_id И
                (task_date, id) > ((rv).task_date, (rv).id)
              РЕД ПО
                task_date, id
              ОГРАНИЧИ 1
            )
          КРАЙ _r
      )
      ИЗБЕРЕТЕ
        _r
      , СЛУЧАЙ
          -- ако 2-я запис вече го няма в списъка, но сме намерили нещо
          КОГАТО list[2] Е NULL И _r НЕ Е РАЗЛИЧНО ОТ NULL ТОГАВА
            ИСТИНА
          ИНАЧЕ -- не сме намерили нищо или "преминали сме"
            coalesce(((_r).task_date, (_r).id) < ((list[2]).task_date, (list[2]).id), ЛЪЖА)
        КРАЙ not_cross
      ОТ
        wrap
    ) X
  КЪДЕ
    T.размер < 20 И -- ограничаваме тук количеството
    T.списък НЕ Е РАЗЛИЧНО ОТ '{}' -- или докато списъкът не свърши
)
-- #3 : "развиваме" записите - редът е гарантиран по построение
ИЗБЕРЕТЕ
  (rv).*
ОТ
  T
КЪДЕ
not_cross; -- взимаме само "непресичащите" записи 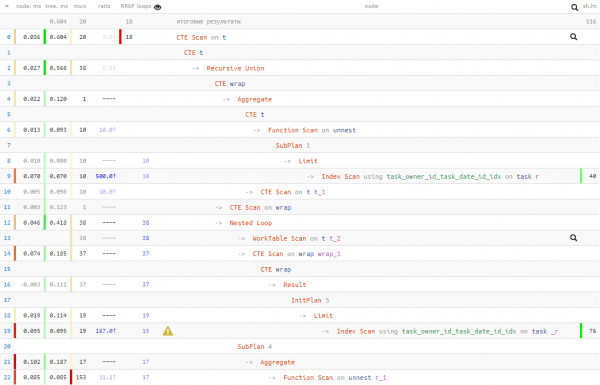
По този начин ние разменихме 50% от четенето на данни за 20% от времето за изпълнение. Тоест, ако имате причини да смятате, че четенето може да отнеме време (например, данните рядко са в кеша и трябва да се търсят на диска), то по този начин можете да разчитате по-малко на четенето.
Във всеки случай, времето за изпълнение е по-добро от «наивния» първи вариант. Но кой от тези 3 варианта да използвате — решавате вие.
Източник: habr.com
