

Здравей, Хабр.
Наскоро споделих опит Съвременните приложения работят в много сложна среда. Бизнес логиката, обгърната в съвременния технологичен стек, работи в Docker образ, който се управлява от оркестратор като Kubernetes или OpenShift и комуникира с други приложения или корпоративни решения чрез верига от физически и виртуални маршрутизатори. В такава среда винаги нещо може да се повреди, поради което повторната обработка на събития в случай на недостъпност на една от външните системи е важна част от нашите бизнес процеси.
Как бе до Kafka
Ранее в проекте мы использовали IBM MQ за асинхронно доставяне на съобщения. При възникване на някаква грешка в процеса на работа на услугата полученото съобщение можеше да бъде поместено в dead-letter-queue (DLQ) за последващ ръчен анализ. DLQ се създаваше до входящата опашка, а прехвърлянето на съобщението ставаше в рамките на IBM MQ.
Ако грешката беше временно явление и ние можехме да го определим (например ResourceAccessException при HTTP повикване или MongoTimeoutException при заявка в MongoDb), тогава в сила влиза стратегия за повторни извиквания. Независимо от разклоненията в логиката на приложението, първоначалното съобщение се прехвърляше или в системна опашка за отложено изпращане, или в отделно приложение, което веднъж бе направено за повторно изпращане на съобщения. При това в заглавието на съобщението се записва номер на повторно изпращане, който е свързан с интервала на забавяне или с края на стратегията на приложението. Ако достигнем края на стратегията, но външната система все пак е недостъпна, съобщението ще бъде поставено в DLQ за ръчен анализ.
Търсене на решение
След като потърсите в интернет
. Накратко, предлага се да се заведе по топик за всеки интервал на забавяне и да се реализират от страната на приложението Consumer’и, които ще четат съобщения с необходимото забавяне. .
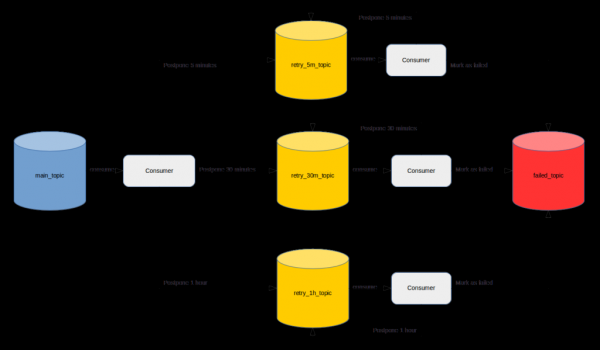
Въпреки многобройните положителни отзиви, то ми се струва не съвсем удачно. На първо място, защото разработчикът, освен реализацията на бизнес изискванията, ще трябва да отдели много време за реализиране на описания механизъм.
Освен това, ако в Kafka клъстера е включено управление на достъпа, ще трябва да отделите известно време за създаване на теми и осигуряване на необходимите достъпи до тях. В допълнение към това ще трябва да подберете правилния параметър retention.ms за всяка от ретрай темите, за да могат съобщенията да бъдат повторно изпратени и да не изчезват от тях. Реализацията и заявката за достъп ще трябва да се повтарят за всеки съществуващ или нов сервиз.
Нека сега да разгледаме какви механизми за повторна обработка на съобщенията ни предоставя spring като цяло и spring-kafka в частност. Spring-kafka има транзитивна зависимост от spring-retry, който предлага абстракции за управление на различни BackOffPolicy. Това е доста гъвкав инструмент, но значителният му недостатък е, че съобщенията за повторно изпращане се съхраняват в паметта на приложението. Това означава, че рестартирането на приложението поради ъпдейт или грешка по време на експлоатация ще доведе до загуба на всички съобщения, които чакат повторна обработка. Тъй като този момент е критичен за нашата система, не разгледахме допълнително.
Самата spring-kafka предоставя няколко реализации на ContainerAwareErrorHandler, например , с който можете да обработите съобщението по-късно, без да преместите offset в случай на грешка. От версия 2.3 на spring-kafka е налична възможността за задаване на BackOffPolicy.
Този подход позволява на повторно обработваните съобщения да преживеят рестарт на приложението, но механизмът DLQ все още липсва. Именно този вариант избрахме в началото на 2019 година, оптимистично смятайки, че DLQ няма да бъде необходим (имахме късмет и той наистина не се оказа необходим през няколко месеца експлоатация на приложението с такава система за повторна обработка). Временните грешки водеха до сработване на SeekToCurrentErrorHandler. Останалите грешки се печатаха в лога, водеха до преместяне на offset и обработката продължаваше с следващото съобщение.
Решението
Реализация, базирана на SeekToCurrentErrorHandler, ни подтикна да разработим собственен механизъм за повторно изпращане на съобщения.
Преди всичко искахме да използваме вече съществуващия опит и да го разширим в зависимост от логиката на приложението. За приложение с линейна логика оптимално би било да спрем четенето на нови съобщения за кратък интервал от време, зададен в рамките на стратегията за повторно повикване. За останалите приложения искахме да имаме една точка, която да осигурява изпълнението на стратегията за повторни повиквания. В допълнение, тази единна точка трябва да притежава функционалността на DLQ за двата подхода.
Самата стратегия за повторни повиквания трябва да се съхранява в приложението, което отговаря за получаване на следващия интервал при възникване на времеви грешки.
Спиране на Consumer за приложение с линейна логика
При работа с spring-kafka кодът за спиране на Consumer може да изглежда по следния начин:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // to DLQ
    }
В примера retryAt е времето, когато трябва отново да стартираме MessageListenerContainer, ако все още работи. Повторното стартиране ще се случи в отделен поток, стартиран в TaskScheduler, чиято реализация също предоставя spring.
Стойността retryAt намираме по следния начин:
- Намира се стойността на счетчика за повторни повиквания.
- Според стойността на счетчика се търси текущият интервал на закъснение в стратегията за повторни повиквания. Стратегията се обявява в самото приложение, за нейното съхранение избрахме формат JSON.
- Намереният в JSON масива интервал съдържа броя секунди, след които ще трябва да повторим обработката. Това количество секунди се прибавя към текущото време, получавайки стойност за retryAt.
- Ако интервалът не бъде намерен, стойността на retryAt е null и съобщението ще бъде изпратено в DLQ за ръчно разглеждане.
Този подход позволява само да се запази броят на повторните извиквания за всяко съобщение, което в момента се обработва, например в паметта на приложението. Запазването на брояча на опити в паметта не е критично за този подход, тъй като приложението с линейна логика не може да извърши обработка като цяло. За разлика от spring-retry, повторното стартиране на приложението не води до загуба на всички съобщения за повторна обработка, а просто до повторно стартиране на стратегията.
Този подход помага да се намали натоварването на външната система, която може да не е налична поради много голямо натоварване. С други думи, в допълнение към повторната обработка, постигнахме реализиране на шаблона .
В нашия случай прага на грешка е само 1, а за да минимизираме простоя на системата поради временно мрежово прекъсване, използваме много грануларна стратегия за повторни извиквания с малки интервали на забавяне. Това може да не е подходящо за всички приложения на групата компании, така че съотношението между прага на грешка и размера на интервала трябва да се подбира в зависимост от особеностите на системата.
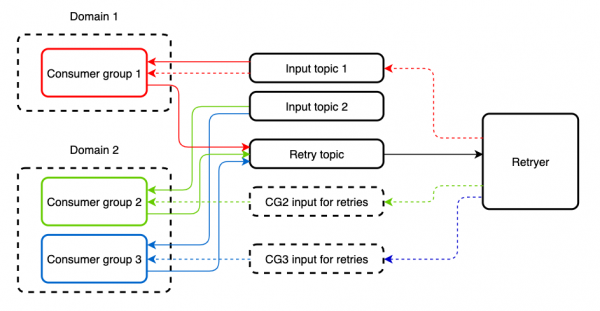
Отделно приложение за обработка на съобщения от приложения с недетерминирана логика
Ето пример на код, който изпраща съобщение в такова приложение (Retryer), което ще изпълни повторно изпращане в темата DESTINATION при достигане на времето RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
От примера е видно, че много информация се предава в хедерите. Стойността RETRY_AT е разположена както за механизма за повторение чрез спиране на Consumer’a. Освен DESTINATION и RETRY_AT, предаваме:
- GROUP_ID, по който групираме съобщения за ръчно анализиране и улесняване на търсенето.
- ORIGINAL_PARTITION, за да се опита да запази същия Consumer за повторна обработка. Този параметър може да бъде null, в този случай новата партиция ще бъде получена по ключа record.key() на оригиналното съобщение.
- Актуализирана стойност на COUNTER, за да следва стратегията за повторни повиквания.
- SEND_TO — константа, която показва дали да се изпрати съобщението за повторна обработка при достигане на RETRY_AT или да се постави в DLQ.
- REASON — причината, поради която обработката на съобщението е прекратена.
Retryer запазва съобщения за повторна изпращане и ръчно разглеждане в PostgreSQL. По таймер се задейства задача, която намира съобщения с настъпило RETRY_AT и ги изпраща обратно в партицията ORIGINAL_PARTITION на темата DESTINATION с ключа record.key().
След изпращането на съобщението те се изтриват от PostgreSQL. Ръчното разглеждане на съобщенията става в прост UI, който взаимодейства с Retryer чрез REST API. Основните му характеристики са повторно изпращане или изтриване на съобщения от DLQ, преглед на информация за грешки и търсене на съобщения, например по името на грешката.
Тъй като в нашите клъстери е активирано управлението на достъпа, е необходимо допълнително да се искат права към темата, която слуша Retryer, и да се разреши на Retryer да записва в темата DESTINATION. Това е неприятно, но, за разлика от подхода с темата на интервал, имаме пълноценна DLQ и UI за управление на нея.
Съществуват случаи, когато входящата тема се чете от няколко различни consumer-групи, приложенията на които реализират различна логика. Повторната обработка на съобщение чрез Retryer за едно от тези приложения ще доведе до дубликат в друго. За да се предпазим от това, създаваме отделна тема за повторна обработка. Входящата и retry-темата може да бъде четена от един и същ Consumer без никакви ограничения.
По подразбиране този подход не предоставя възможности за circuit breaker, но може да бъде добавен в приложението с помощта на или новия , обвивайки местата на повиквания към външни услуги в съответните абстракции. Освен това се появява възможност за избор на стратегия за модел, което също може да бъде полезно. Например, в spring-cloud-netflix това може да бъде thread pool или семафор.
Извод
В резултат на това получихме отделно приложение, което позволява повторно обработване на съобщения при временно недостъпна външна система.
Едно от основните предимства на приложението е, че външните системи, работещи на същия Kafka клъстер, могат да го използват без значителни промени от тяхна страна! Такова приложение просто ще трябва да получи достъп до retry-топика, да попълни няколко Kafka заглавия и да изпрати съобщение в Retryer. Не е нужно да се създава допълнителна инфраструктура. За да намалим броя на прехвърлените съобщения между приложението и Retryer, отделихме приложения с линейна логика и направихме повторното им обработване чрез спиране на Consumer.
Източник: habr.com
