

В навечерието на старта на нов поток по курса подготвихме превод на интересен материал.
Преглед
Ще говорим за доста популярния модел, с който приложенията използват множество хранилища от данни, където всяко хранилище се използва за свои цели, например, за съхранение на канонична форма на данните (MySQL и т.н.), осигуряване на разширени възможности за търсене (ElasticSearch и т.н.), кеширане (Memcached и т.н.) и други. Обикновено, при използване на множество хранилища от данни, едно от тях работи като основно хранилище, а другите като производни хранилища. Единствената проблемна точка е как да се синхронизират тези хранилища от данни.
Разгледахме редица различни модели, които се опитват да разрешат проблема със синхронизацията на няколко хранилища, като двойна запис, разпределени транзакции и т.н. Въпреки това, тези подходи имат съществени ограничения относно употребата им в реалния живот, надеждността и техническото обслужване. Освен синхронизация на данните, на някои приложения също им е необходимо да обогатяват данните, извиквайки външни услуги.
За решаването на тези проблеми е разработен Delta. Delta в крайна сметка представлява последователна, управляемата от събития платформа за синхронизация и обогатяване на данните.
Съществуващи решения
Двойна запис
За да синхронизирате две хранилища от данни, можете да използвате двойна запис, която извършва запис в едно хранилище, а след това веднага прави запис в друго. Първият запис може да бъде повторен, а вторият - прекратен, ако първият не успее след изчерпване на броя опити. Въпреки това, двете хранилища от данни могат да престанат да се синхронизират, ако записа във второто хранилище не успее. Обикновено, този проблем се решава чрез създаването на процедура за възстановяване, която може периодично да пренася данните от първото хранилище във второто или да прави това само в случай, че в данните бъдат открити разлики.
Проблеми:
Изпълнението на процедурата по възстановяване е специфична работа, която не може да се повтори. Освен това, данните между хранилищата остават несинхронизирани, докато не се извърши процедурата по възстановяване. Решението става по-сложно, ако се използват повече от две хранилища за данни. И накрая, процедурата по възстановяване може да увеличи натоварването на изходния източник на данни.
Таблица с журнали на измененията
Когато в набора от таблици настъпят изменения (например, добавяне, обновяване и изтриване на записи), записите за измененията се добавят в таблицата с журнали, като част от същата транзакция. Друг поток или процес постоянно запитва събития от таблицата с журнали и ги записва в едно или повече хранилища за данни, при необходимост изтривайки събития от таблицата с журнали след потвърждение на записа от всички хранилища.
Проблеми:
Този шаблон следва да бъде реализиран като библиотека и идеално без изменение на кода на приложението, което я използва. В многопроцесорна среда, реализацията на такава библиотека трябва да съществува на всеки необходим език, но осигуряването на последователност в работата на функциите и поведението между езиците е много трудна задача.
Друг проблем се крие в получаването на изменения на схемата в системи, които не поддържат транзакционни изменения на схемата [1][2], като например MySQL. Затова шаблонът за изпълнение на изменение (например, изменение на схемата) и транзакционното му записване в таблицата с журнали на измененията не винаги ще работи.
Разпределени транзакции
Разпределените транзакции могат да се използват, за да разделят транзакцията между няколко хетерогенни хранилища за данни, така че операцията да бъде или фиксирана във всички използвани хранилища, или да не бъде фиксирана в нито едно от тях.
Проблеми:
Разпределените транзакции са много голям проблем за хетерогенните хранилища данни. По своя природа те могат да разчитат само на най-малкия общ знаменател на участващите системи. Например, XA-транзакции блокират изпълнението, ако по време на приложението възникне повреда на етапа на подготовка. Освен това, XA не осигурява откриване на задръствания и не поддържа оптимистични схеми за управление на паралелизма. Освен това, някои системи като ElasticSearch не поддържат XA или всяка друга хетерогенна модел на транзакции. Така че, осигуряването на атомарност на записа в различни технологии за съхранение на данни остава за приложенията доста сложна задача [3].
Delta
Delta беше разработена, за да преодолее ограниченията на съществуващите решения за синхронизация на данни, като също така позволява обогатяване на данни в движение. Нашата цел беше да абстрахираме всичките тези сложни аспекти от разработчиците на приложения, за да могат те напълно да се съсредоточат върху реализирането на бизнес функционалността. По-долу ще опишем „Movie Search“, реален вариант на използване на Delta от Netflix.
В Netflix широко се прилага микросервизна архитектура и всеки микросервиз обикновено обслужва един тип данни. Основната информация за филма е изнесена в микросервиз, който се нарича Movie Service, а свързаните с него данни, като информация за продуценти, актьори, доставчици и т.н., се управляват от няколко други микросервиза (а именно Deal Service, Talent Service и Vendor Service).
Бизнес потребителите в Netflix Studios често имат нужда да търсят филми по различни критерии, именно поради това е много важно за тях да имат възможност да търсят всички данни, свързани с филмите.
До появата на Delta, екипът за търсене на филми трябваше да получава данни от няколко микросервиза, преди да индексира данните за филмите. Освен това, екипът трябваше да разработи система, която периодично да обновява търсачката, запитвайки изменения от другите микросервизи, дори и да няма изменения изобщо. Тази система бързо нарасна в сложност и стана трудна за поддръжка.
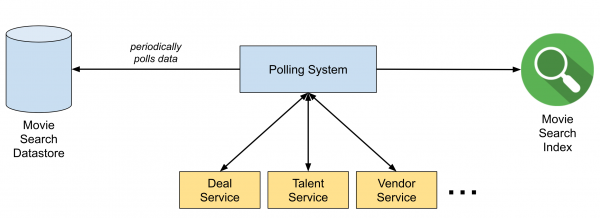
Фигура 1. Системата за polling преди Delta
След като започнете да използвате Delta, системата се опростява до система, управлявана от събития, както е показано на следната графика. Събитията CDC (Change-Data-Capture) се изпращат в теми на Keystone Kafka чрез Delta-Connector. Приложението Delta, изградена с помощта на Delta Stream Processing Framework (базирано на Flink), получава CDC-събития от темата, обогатява ги, като извиква други микросервиси, и накрая предава обогатените данни в търсене на индекс в Elasticsearch. Целият процес протича почти в реално време, а именно, веднага щом промените бъдат регистрирани в хранилището на данни, търсачките се обновяват.
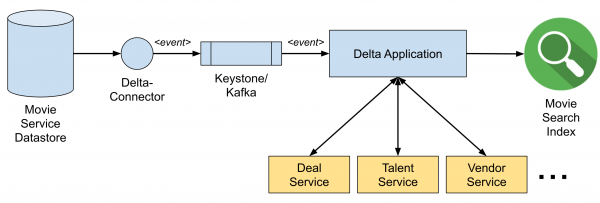
Графика 2. Данен пайплайн при използване на Delta
В следващите раздели ще опишем работата на Delta-Connector, който се свързва с хранилището и публикува CDC-събития на транспортно ниво, което представлява инфраструктура за предаване на данни в реално време, предназначена да насочва CDC-събития в теми на Kafka. А в самия край ще говорим за структурата на обработка на потоци Delta, която разработчиците на приложения могат да използват за логика на обработка и обогатяване на данни.
CDC (Change-Data-Capture)
Разработихме CDC-сервис, наречен Delta-Connector, който може да фиксира записаните промени от хранилището на данни в реално време и да ги записва в поток. Промените в реално време се вземат от журналите на транзакциите и дамповете на хранилището. Дамповете се използват, тъй като журналите на транзакциите обикновено не съ хранят цялата история на промените. Промените обикновено се сериализират като събития Delta, така че получателят не трябва да се притеснява откъде произлиза променението.
Delta-Connector поддържа няколко допълнителни функции, като:
- Възможност за записване в персонализирани изходни данни извън Kafka.
- Възможност за активиране на ръчни дампове по всяко време за всички таблици, за определена таблица или за конкретни първични ключове.
- Дамповете могат да се вземат на парчета, така че няма нужда да започнете отначало в случай на провал.
- Не е необходимо да поставяте блокировки на таблиците, което е много важно, за да трафикът на записи в базата данни никога не бъде блокиран от нашия сервис.
- Висока наличност благодарение на резервните екземпляри в зоните за наличност на AWS.
В момента поддържаме MySQL и Postgres, включително при разгръщане в AWS RDS и Aurora. Също така поддържаме Cassandra (multi-master). Повече подробности относно Delta-Connector можете да намерите в това .
Kafka и транспортен слой
Транспортният слой на събития Delta е построен на съобщителната услуга на платформата .
Исторически публикуването на съобщения в Netflix е било оптимизирано с фокус върху повишаване на достъпността, а не на дълготрайността (вж. ). Компромис представлява потенциалното несъответствие на данните на брокера в различни гранични сценарии. Например, unclean leader election отговаря за това, че получателят потенциално дублира или губи събития.
С Delta искахме да получим по-солидни гаранции за дълготрайност, за да осигурим доставката на CDC-събития в производни хранилища. Затова предложихме специално проектиран кластер Kafka като обект от първостепенно значение. Можете да видите някои настройки на брокера в таблицата по-долу:
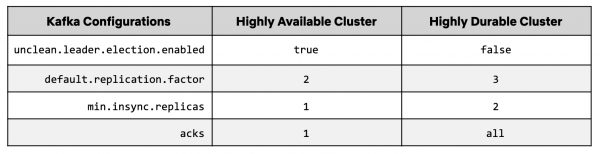
В кластерите Keystone Kafka, unclean leader election обикновено е включен за осигуряване на достъпността на издателя. Това може да доведе до загуба на съобщения в случай, че несинхронизирана реплика бъде избрана за лидер. За новия високо надежден кластер Kafka параметър unclean leader election е изключен, за да се предотврати загубата на съобщения.
Също така увеличихме replication factor от 2 на 3 и minimum insync replicas от 1 на 2. Издателите, които пишат в този клъстер, изискват acks от всички останали, като гарантират, че 2 от 3 реплики ще имат най-актуалните съобщения, изпратени от издателя.
Когато екземплярът на брокера спре, нов екземпляр заменя стария. Въпреки това, новият брокер ще трябва да навакса не синхронизираните реплики, което може да отнеме няколко часа. За да съкратим времето за възстановяване на работата при този сценарий, започнахме да използваме блочно съхранение на данни (Amazon Elastic Block Store) вместо локалните дискове на брокерите. Когато новият екземпляр замести завършилата работа брокер, той присъединява EBS тома, който е бил при завършилия екземпляр, и започва да наваксва новите съобщения. Този процес съкращава времето за ликвидиране на закъсненията от няколко часа до няколко минути, тъй като новият екземпляр вече не трябва да репликира от нулево състояние. В заключение, отделните жизнени цикли на хранилището и брокера значително намаляват влиянието на ефекта от смяната на брокера.
За да увеличим още повече гаранцията за доставка на данни, използвахме за откриване на загуба на съобщения в екстремни условия (например, разсинхронизация на часовниците в лидера на раздела).
Stream Processing Framework
Нивото на обработка в Delta е построено на базата на платформата Netflix SPaaS, която осигурява интеграция на Apache Flink с екосистемата на Netflix. Платформата предлага потребителски интерфейс, който управлява разгръщането на задания Flink и оркестрацията на клъстери Flink върху нашата платформа за управление на контейнери Titus. Интерфейсът също управлява конфигурациите на заданията и позволява на потребителите динамично да правят промени в конфигурацията без необходимост от повторно компилиране на задания Flink.
Delta предоставя фреймворк за потокова обработка (stream processing framework) на данни на база Flink и SPaaS, който използва основан на анотации DSL (Domain Specific Language), за да абстрахира техническите детайли. Например, за да се определи стъпка, с която ще бъдат обогатявани събитията, извиквайки външни услуги, потребителите трябва да напишат следния DSL, а фреймворкът ще създаде върху него модел, който ще бъде изпълнен от Flink.
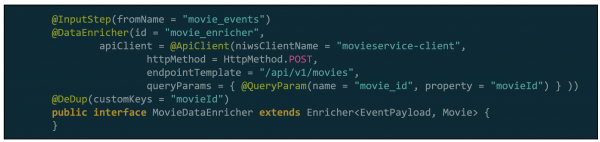
Рис. 3. Пример за обогатяване на DSL в Delta
Фреймворкът за обработка не само че съкращава кривата на обучение, но и осигурява общи функции за обработка на потока, като дедупликация, схематизация, а също така гъвкавост и устойчивост на откази за решаване на общи проблеми в работата.
Delta Stream Processing Framework се състои от два ключови модула - модул DSL & API и модул Runtime. Модулът DSL & API предоставя DSL и UDF (User-Defined-Function) API, за да може потребителят да напише собствена логика за обработка (например, филтриране или преобразуване). Модул Runtime осигурява реализация на парсера DSL, който изгражда вътрешно представяне на стъпките за обработка в DAG модели. Компонентът Execution интерпретира DAG моделите, за да инициализира реалните оператори на Flink и в крайна сметка да стартира приложението Flink. Архитектурата на фреймуърка е илюстрирана на следния рисунък.
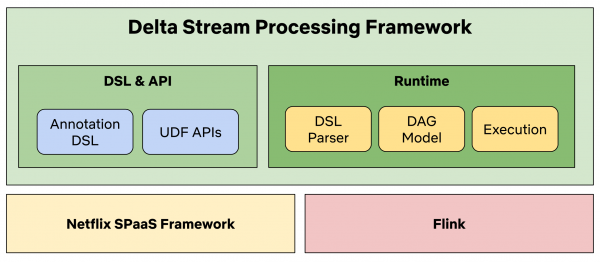
Рисунок 4. Архитектура Delta Stream Processing Framework
Този подход има няколко предимства:
- Потребителите могат да се фокусират върху бизнес логиката си, без да е необходимо да навлизат в спецификата на Flink или структурата на SPaaS.
- Оптимизацията може да се извършва по прозрачен за потребителите начин, а грешките могат да бъдат коригирани без необходимост от промени в кода на потребителя (UDF).
- Работата на приложението Delta е опростена за потребителите, тъй като платформата осигурява гъвкавост и устойчивост от самото начало и събира множество подробни метрики, които могат да се използват за известия.
Използване в продукция
Delta работи в продукция вече повече от година и играе ключова роля в много приложения на Netflix Studio. Тя е помогнала на екипите да реализират случаи на употреба като индексиране на търсене, съхранение на данни и работни потоци, управлявани от събития. По-долу е представен обзор на високопрофилната архитектура на платформата Delta.
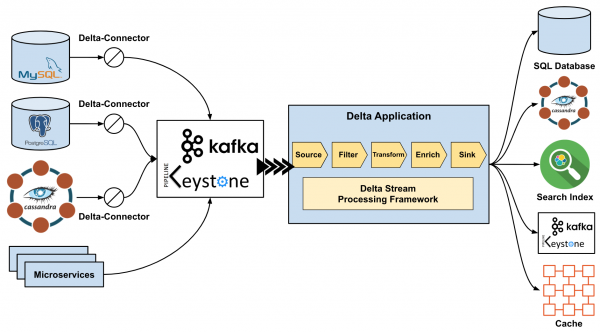
Рисунок 5. Високопрофилна архитектура на Delta.
Благодарности
Искаме да благодарим на следните хора, които участваха в създаването и развитието на Delta в Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang и Zhenzhong Xu.
Източници
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Онлайн обработка на събития. Commun. ACM 62(5): 43–49 (2019). DOI:
: «Data Build Tool за хранилище Amazon Redshift».
Източник: habr.com
