

Здравейте, хабровци. Традиционно продължаваме да споделяме интересен материал в навечерието на новите курсове. Днес специално за вас преведохме статия за Google Cloud Spanner, свързвайки я с старта на курса .
Първоначално публикувано в .
Като компания, която предлага множество облачни решения за търговски точки на продажба за търговци на дребно, ресторантьори и онлайн продавачи по целия свят, Lightspeed използва няколко различни типа бази данни за множество транзакционни, аналитични и търсачески казуси. Всяка от тези платформи за бази данни има своите предимства и недостатъци. Следователно, когато Google представи Cloud Spanner на пазара — обещаващи функции, невиждани в света на релационните бази данни, като практически неограничена хоризонтална мащабируемост и 99,999% споразумение за ниво на услуга (SLA), — не можехме да изпуснем възможността да я получим в ръцете си!
За да предоставим изчерпателен преглед на нашия опит с Cloud Spanner, както и критерии за оценка, които използвахме, ще разгледаме следните теми:
- Нашите критерии за оценка
- Cloud Spanner в две думи
- Нашата оценка
- Нашите заключения
1. Нашите критерии за оценка
Преди да се задълбочим в особеностите на Cloud Spanner, нейните прилики и разлики с другите решения на пазара, нека първо поговорим за основните случаи на употреба, които имахме предвид, когато разглеждахме къде да внедрим Cloud Spanner в нашата инфраструктура:
- Като заместител на (преобладаващото) традиционно решение за SQL база данни
- Като OLTP решение с поддръжка на OLAP
Бележка: За опростяване и удобство на сравнение тази статия сравнява Cloud Spanner с MySQL варианти от семействата GCP Cloud SQL и Amazon AWS RDS.
Използване на Cloud Spanner като заместител на традиционно решение за SQL база данни
В среда на традиционни бази данни, когато времето за отговор на заявки към базата данни приближава или дори надвишава предварително определените прагове на приложението (в основата си заради увеличаването на броя на потребителите и/или заявките), съществуват няколко начина за намаляване на времето за отговор до приемливи нива. Обаче повечето от тези решения изискват ръчно намесване.
Например, първата стъпка, която трябва да предприемете, е да разгледате различните параметри на базата данни, свързани с производителността, и да ги настроите, така че да съответстват на шаблоните на сценарии на приложение. Ако това не е достатъчно, можете да изберете вертикално или хоризонтално мащабиране на базата данни.
Вертикалното мащабиране на приложението означава обновяване на инстанцията на сървъра, обикновено чрез добавяне на повече процесори/ядра, повече RAM, по-бързо хранилище и т.н. Добавянето на повече хардуерни ресурси води до увеличаване на производителността на базата данни, измервана главно в транзакции в секунда и латентност на транзакции за OLTP системи. Системите за релационни бази данни (които използват многопоточен подход), като MySQL, се мащабират добре вертикално.
Този подход има няколко недостатъка, но най-очевидният е максималният размер на сървъра на пазара. След като се достигне пределът на най-голямата инстанция на сървъра, остава само един път: хоризонтално мащабиране.
Хоризонталното мащабиране е подход, при който в кластера се добавят повече сървъри, за да се увеличи производителността в идеалния случай линейно с увеличаване на броя на сървърите. Повечето на традиционни системи за бази данни имат лошо хоризонтално мащабиране или изобщо не се мащабират. Например, MySQL може да се мащабира хоризонтално за операции за четене, добавяйки slave-читатели, но не може да се мащабира хоризонтално за операции за запис.
От друга страна, благодарение на своята природа, Cloud Spanner може лесно да се мащабира хоризонтално с минимална интервенция.
Функционална СУБД като услуга трябва да се оценява от различни ъгли. За основа взехме най-популярната СУБД в облака — за Google, GCP Cloud SQL и за Amazon, AWS RDS. В нашата оценка се фокусираме върху следните категории:
- Сравнение на функции: разширения SQL, DDL, DML; библиотеки за свързване/конектори, поддръжка на транзакции и т.н.
- Поддръжка на разработка: леснота на разработката и тестването.
- Поддръжка на администриране: управление на инстанции - например, мащабиране нагоре/надолу и ъпгрейд на инстанции; SLA, резервно копие и възстановяване; сигурност/контрол на достъпа.
Използване на Cloud Spanner като OLTP решение с поддръжка за OLAP.
Въпреки че Google явно не твърди, че Cloud Spanner е предназначен за аналитична обработка, той споделя някои атрибути с други механизми, като Apache Impala & Kudu и YugaByte, които са предвидени за OLAP натоварвания.
Дори ако съществуваше само малка вероятност Cloud Spanner да включва последователен хибриден транзакционно-аналитичен двигател (HTAP) с (приблизително) работещ набор от функции за OLAP, смятаме, че това би заслужавало нашето внимание.
В светлината на това разгледахме следните категории:
- Зареждане на данни, индекси и поддръжка на партициониране.
- Производителност на запитвания и DML.
2. Cloud Spanner накратко.
Google Spanner е клъстерна система за управление на релационни бази данни (РСУБД), която Google използва за няколко свои собствени услуги. Google я направи публично достъпна за потребителите на Google Cloud Platform в началото на 2017 година.
Ето някои от атрибутите на Cloud Spanner:
- Силно последователно мащабируем клъстер РСУБД: използва хардуерна синхронизация на времето за осигуряване на последователност на данните.
- Поддръжка на междутаблични транзакции: транзакциите могат да обхващат няколко таблици - не е задължително да се ограничават до една таблица (в контекста на Apache HBase или Apache Kudu).
- Таблици на основата на първичен ключ: всички таблици трябва да имат деклариран първичен ключ (ПК), който може да се състои от няколко колони на таблицата. Табличните данни се съхраняват в ред по ПК, което ги прави много ефективни и бързи за търсене по ПК. Както и в другите системи на основата на ПК, реализацията трябва да бъде моделирана с оглед на предварително обмислени случаи на употреба за постигане на .
- Чередуващи се таблици: таблиците могат да имат физически зависимости една от друга. Редовете на дъщерната таблица могат да бъдат свързани с редовете на родителската таблица. Този подход ускорява търсенето на отношения, които могат да бъдат определени на етапа на моделиране на данни, например, при съвместното разположение на клиенти и техните фактури.
- Индекси: Cloud Spanner поддържа вторични индекси. Индексът се състои от индексирани колони и всички колони на основния ключ. При желание индексът може да съдържа и други неиндексирани колони. Индексът може да бъде свързан с родителската таблица, за да ускори заявките. Към индексите се прилагат няколко ограничения, например, максимален брой допълнителни колони, съхранявани в индекса. Освен това заявките чрез индекси могат да не са толкова прости, колкото в други РСУБД.
Cloud Spanner автоматично избира индекса само в редки случаи. По-специално, Cloud Spanner не избира вторичен индекс автоматично, ако заявката поиска каквито и да било колони, които не са запазени в ».
- Споразумение за ниво на обслужване (SLA): разполагане в един регион със SLA от 99,99%; многорегионални разполагания с 99,999% SLA. Въпреки че самото споразумение за ниво на обслужване е просто споразумение, а не някаква гаранция, вярвам, че служителите на Google наистина имат някакви точни данни, за да направят такова сериозно твърдение. (За справка, 99,999% означава 26,3 секунди недостъпност на услугата на месец.)
- Повече:
Бележка: Проект Apache Tephra добавя разширена поддръжка на транзакции в Apache HBase (вече също реализиран в Apache Phoenix като бета версия).
Оценка 3
Така че всички сме чели твърденията на Google за предимствата на Cloud Spanner - практически неограничено хоризонтално мащабиране, запазвайки висока консистентност и много висок SLA. Въпреки че тези изисквания, във всеки случай, са изключително трудни за постигане, нашата цел не беше да ги опровергаваме. Вместо това нека се концентрираме върху други неща, които тревожат повечето потребители на бази данни: точност и удобство за ползване.
Оценихме Cloud Spanner като заместител на Sharded MySQL
Google Cloud SQL и Amazon AWS RDS, две от най-популярните OLTP СУБД на облачния пазар, предлагат многообхватен набор функции. Въпреки това, за да мащабирате тези бази данни извън размера на един възел, е необходимо да извършвате разпределение на приложенията. Такива подходи създават допълнителна сложност както за приложенията, така и за администрирането. Разгледахме как Spanner се вписва в сценария на обединението на множество сегменти в един инстанс и с какви функции (ако въобще има такива) може да се наложи да се примирите.
Поддръжка на SQL, DML и DDL, както и конектор и библиотеки?
На първо място, при работа с всяка база данни е необходимо да се създаде модел на данните. Ако смятате, че можете да свържете JDBC Spanner с любимия си SQL инструмент, ще откриете, че можете да запитате данните си чрез него, но не можете да го използвате за създаване на таблица или извършване на промени (DDL) или всякакви операции по въвеждане/актуализиране/изтриване (DML). Официалният JDBC от Google не поддържа нито едно от тях.
„В момента драйверите не поддържат DML или DDL оператори.“
Документация на Spanner
С конзолата GCP положението не е по-добро — можете да изпращате само SELECT заявки. За щастие, съществува JDBC драйвер с поддръжка на DML и DDL от общността, включително транзакции. . Въпреки че този драйвер е изключително полезен, отсъствието на собствен JDBC драйвер от Google е учудващо. За щастие, Google предлага сравнително обширна поддръжка на клиентски библиотеки (на базата на gRPC): C#, Go, Java, node.js, PHP, Python и Ruby.
Практически задължителната употреба на потребителски API интерфейси на Cloud Spanner (поради липса на DDL и DML в JDBC) води до определени ограничения за свързаните области на кода, като пулове от връзки или фреймуърк за свързване на бази данни (например, Spring MVC). Като правило, при работа с JDBC можете свободно да избирате любимия си пул от връзки (например, HikariCP, DBCP, C3PO и т.н.), който е тестван и работи добре. В случай на потребителски API за Spanner сме принудени да разчитаме на фреймуъркове/пулове за връзки/сесии, които сами сме създали.
Конструкцията, ориентирана към основния ключ (ПК), позволява на Cloud Spanner да бъде много бърз при достъпа до данни чрез ПК, но също така води до някои проблеми с запитванията.
- Не можете да актуализирате стойността на основния ключ; първо трябва да изтриете записа с оригиналния ПК и след това да го вмъкнете отново с нова стойност. (Това е сходно с другите бази данни, ориентирани около ПК / механизми за съхранение.)
- Всички оператори UPDATE и DELETE трябва да указват ПК в WHERE, следователно не може да има пуст оператор DELETE all — винаги трябва да има подзаявка, например: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Липсата на опция за автоинкрементиране или нещо подобно, което задава последователност за полето ПК. За да работи това, съответната стойност трябва да бъде създадена на ниво приложение.
Вторични индекси?
Google Cloud Spanner има вградена поддръжка за вторични индекси. Това е много приятна функция, която не винаги присъства в други технологии. Apache Kudu в момента изобщо не поддържа вторични индекси, а Apache HBase не поддържа индекси директно, но може да ги добави чрез Apache Phoenix.
Индекси в Kudu и HBase могат да бъдат моделирани като отделна таблица с различен състав на основните ключове, но атомарността на операциите, извършвани с родителската таблица и свързаните индекси, трябва да бъде осъществена на ниво приложение и не е тривиална в правилна реализация.
Както бе споменато в прегледа на Cloud Spanner, неговите индекси могат да се различават от индексите на MySQL. Следователно, трябва да подходите с особено внимание при изграждането на заявки и профилиране, за да се осигури използването на подходящия индекс там, където е необходимо.
Представления?
Много популярен и полезен обект в базата данни — представления. Те могат да бъдат полезни за много случаи на употреба; двата ми основни фаворита са логическото абстракционно ниво и нивото на безопасност. За съжаление, Cloud Spanner НЯМА поддръжка за представления. Но това само частично ни ограничава, тъй като няма детайлизиране на разрешенията на ниво колона, където представленията могат да бъдат приемливо решение.
В документацията на Cloud Spanner в раздела, в който подробно описват квоти и ограничения (), има, по-специално, едно, което може да бъде проблематично за някои приложения: Cloud Spanner има ограничение от максимум 100 бази данни на инстанция по подразбиране. Очевидно е, че това може да стане сериозна пречка за база данни, предназначена да мащабира над 100 бази данни. За щастие, след разговор с нашия технически представител от Google разбрахме, че този лимит може да бъде увеличен практически до всяка стойност чрез поддръжката на Google.
Поддръжка на разработка?
Cloud Spanner предлага доста прилична поддръжка на програмни езици за работа с неговото API. Официално поддържаните библиотеки са в областта на C#, Go, Java, node.js, PHP, Python и Ruby. Документацията е достатъчно подробна, но, както и при другите авангардни технологии, общността е сравнително малка в сравнение с най-популярните технологии за бази данни, което може да доведе до увеличаване на времето, необходимо за решаване на по-редки случаи на употреба или проблеми.
Как стоят нещата с поддръжката на локална разработка?
Не намерихме начин да създадем инстанция на Cloud Spanner в локална среда. Най-близкото, което получихме, е Docker-образ. , което по принцип е подобно, но на практика се различава значително. Например, CockroachDB може да използва PostgreSQL JDBC. Тъй като средата за разработка трябва да е възможно най-близка до работната среда, Cloud Spanner не е идеален, тъй като се налага да се разчита на пълна инстанция на Spanner. За да спестите разходи, можете да изберете инстанция за един регион.
Поддръжка на администриране?
Създаването на инстанция на Cloud Spanner е много просто. Просто трябва да изберете между създаването на мултирегионална инстанция или инстанция за един регион, да посочите регион(и) и брой възли. По-малко от минута, инстанцията ще бъде пусната и готова за работа.
Някои елементарни метрики са директно достъпни на страницата Spanner в консолата на Google. По-подробни изгледи са налични чрез Stackdriver, където можете също да зададете прагови стойности за метрики и политики за известяване.
Достъп до ресурсите?
MySQL предлага множество и многообхватни настройки на разрешения/роли на потребителите. Лесно можете да конфигурирате достъпа до определена таблица или дори само до подмножество от нейните колони. Cloud Spanner използва инструмента на Google Identity & Access Management (IAM), който позволява задаване на политики и разрешения само на много високо ниво. Най-дetailed вариант е разрешението на ниво база данни, което не се вписва в повечето производствени случаи. Това ограничение ви принуждава да добавяте допълнителни мерки за сигурност в кода си, инфраструктурата или и двете, за да предотвратите неразрешен достъп до ресурсите на Spanner.
Резервни копия?
Просто казано, резервни копия в Cloud Spanner не съществуват. Въпреки че строгите изисквания на Google SLA могат да гарантират, че няма да загубите данни заради повреди на хардуера или базата данни, човешки грешки, дефекти в приложения и т.н. Всички знаем правилото: високата наличност не замества разумната стратегия за резервно копие. Към момента единственият начин да направите резервно копие на данни е да ги предавате на живо от базата данни в отделна среда за съхранение.
Производителност на запитванията?
За зареждане на данни и тестване на запитвания използвахме Yahoo! Cloud Serving Benchmark. В таблицата по-долу е представена работната натовареност B YCSB с отношение на четене 95% и запис 5%.
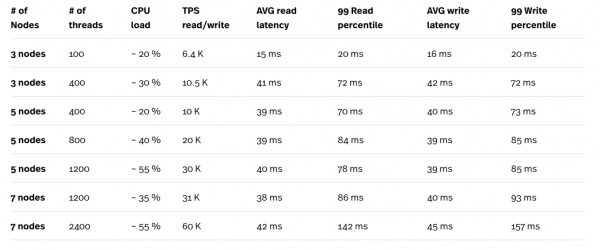
* Нагрузъчният тест е извършен на изчислителен двигател (CE) n1-standard-32 (32 vCPU, 120 GB RAM), а тестовият екземпляр никога не е бил тясно място в тестовете.
** Максималният брой потоци в един екземпляр YCSB е 400. Общо е необходимо да се стартират шест паралелни екземпляра на тестовете YCSB, за да се получат общо 2400 потока.
Гледайки резултатите от тестовете, особено комбинацията от натоварване на процесора и TPS, ясно виждаме, че Cloud Spanner е достатъчно добре мащабируем. Голямото натоварване, създавано от многобройни потоци, се компенсира от многобройните възли в клъстера на Cloud Spanner. Въпреки че забавянето изглежда доста високо, особено при работа с 2400 потока, за получаване на по-точни числа може да е необходимо повторно тестване с 6 по-малки екземпляра на изчислителния двигател. Всеки екземпляр ще изпълнява един тест YCSB вместо един голям инстанс CE с 6 паралелни теста. Така ще бъде по-лесно да се различат забавянията на заявките на Cloud Spanner и забавянията, добавени от мрежовото свързване между Cloud Spanner и инстанса CE, на който се изпълнява теста.
Как Cloud Spanner справя като OLAP?
Партициониране?
Разделянето на данни на физически и/или логически независими сегменти, наречени партиции, е много популярна концепция, свойствена на повечето механизми OLAP. Партициите могат значително да подобрят производителността на заявките и поддръжката на базата данни. По-дълбокото изследване на партиции би изисквало отделна статия (статии), затова нека просто споменем важността на наличието на схема за партициониране и подсистеми за партициониране. Възможността за разделяне на данните на партиции и дори по-нататък на подсистеми е ключът към производителността на аналитичните заявки.
Cloud Spanner не поддържа партиции като такива. Той разделя данните вътре на т.н. split-ове на база диапазони на основния ключ. Разделянето се извършва автоматично за балансиране на натоварването в клъстера на Cloud Spanner. Много удобна функция на Cloud Spanner е разпределянето на основното натоварване на родителската таблица (таблицата, която не се редува с друга). Spanner автоматично определя дали split данните се четат по-често от данните в другите split-и и може да вземе решение за допълнително разделяне. Така в заявката могат да бъдат ангажирани повече възли, което също ефективно увеличава пропускливостта.
Зареждане на данни?
Метод Cloud Spanner за работа с обемни данни е същият като при обикновена зареждане. За да постигнете максимална производителност, трябва да следвате някои препоръки, включително:
- Сортирайте данните си по основния ключ.
- Разделете ги на 10*брой възли отделни секции.
- Създайте набор от работни задачи, които паралелно зареждат данни.
При това зареждане на данни се използват всички възли на Cloud Spanner.
Използвахме работен товар A YCSB за генериране на набор от данни от 10M реда.
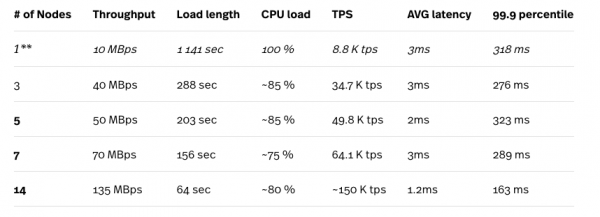
* Тестът за натоварване се извършва на изчислителния двигател n1-standard-32 (32 vCPU, 120 GB памет), и тестовият инстанс никога не е бил ограничение в тестовете.
** Настройката с 1 възел не е препоръчителна за никакво производствено натоварване.
Както споменахме по-горе, Cloud Spanner автоматично обработва разцепванията в зависимост от натоварването им, така че резултатите се подобряват след няколко последователни повторения на теста. Резултатите, представени тук, са най-добрите, които получихме. Гледайки данните по-горе, можем да видим как Cloud Spanner (добре) мащабира с увеличаване на броя на възлите в клъстера. Цифрите, които се открояват, представляват изключително ниски средни закъснения, които контрастират с резултатите от смесени работни натоварвания (95% четене и 5% запис), както е описано в предходния раздел.
Мащабиране?
Увеличаването и намаляването на броя на възлите Cloud Spanner е задача, която може да се изпълни с един клик. Ако искате бързо да заредите данни, можете да обмислите увеличаване на инстанса до максималния капацитет (в нашия случай бяха 25 възли в региона US-EAST), а след това да намалите броя на възлите, които са подходящи за вашето обичайно натоварване, след като всички данни са в базата данни, имайки предвид ограничението от 2 TB/възел.
Напомниха ни за това ограничение дори с много по-малка база данни. След няколко прогонявания на натоварващи тестове, нашата база данни беше с размер около 155 GB, а при намаляване до инстанс с 1 възел получихме следната грешка:
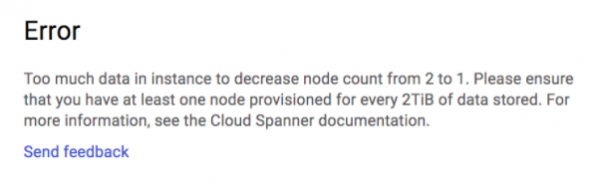
Успяхме да намалим мащаба от 25 до 2 инстанса, но се засякохме на две възли.
Увеличаването и намаляването на броя на възлите в клъстера Cloud Spanner може да бъде автоматизирано с помощта на REST API. Това може да бъде особено полезно за намаляване на високото натоварване на системата в часове на интензивна работа.
Каква е производителността на OLAP запитванията?
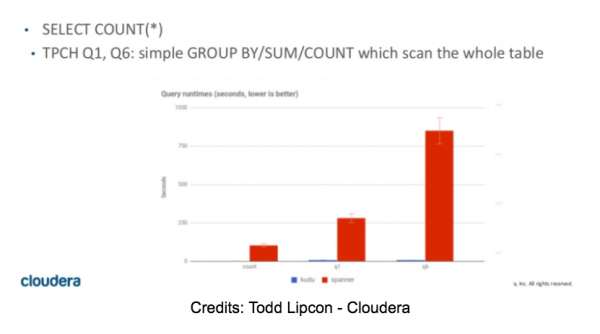
Първоначално планирахме да обърнем значително време на нашата оценка на Spanner в тази част. След няколко SELECT COUNT веднага разбрахме, че тестването ще бъде кратко и че Spanner НЯМА да бъде подходящ за OLAP двигател. Независимо от броя на възлите в клъстера, простият избор на брой редове в таблица с 10M реда отне от 55 до 60 секунди. Освен това, всяко запитване, което изискваше по-голям обем памет за съхранение на междинни резултати, завърши с грешка OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M уникални стойности)-> SpoolingHashAggregateIterator изчерпа паметта по време на нов ред.
Някои цифри за TPC-H запитванията могат да бъдат намерени в статията на Тод Липкон , слайдове 42 и 43. Тези цифри са в съответствие с нашите собствени резултати (за съжаление).
4. Нашите изводи
Въз основа на текущото състояние на функциите на Cloud Spanner, трудно можем да си представим, че той може да бъде проста замяна на съществуващо OLTP решение, особено когато нуждите ви надвият неговите възможности. Би било необходимо да се отдели значително количество време за изграждане на решение с отчитане на недостатъците на Cloud Spanner.
Когато започнахме оценката на Cloud Spanner, очаквахме, че неговите функции за управление ще бъдат на ниво или поне не толкова далеч от другите решения на Google SQL. Но бяхме изненадани от напълно отсъстващите резервни копия и много ограничения в контрола на достъпа до ресурсите. Да не говорим за липсата на изгледи, липсата на локална среда за разработка, неподдържаните последователности, JDBC без поддръжка на DML и DDL и т.н.
И така, къде да отиде човек, който трябва да мащабира транзакционната база данни? Изглежда, че на пазара все още няма единно решение, което да подхожда на всички случаи на употреба. Съществуват множество решения с затворен и отворен код (някои от които се споменават в тази статия), всяко от които има своите силни и слаби страни, но ни едно не предлага SaaS с SLA 99,999% и висока степен на съгласуваност. Ако високото ниво на SLA е вашата основна цел и не планирате да изграждате собствено решение за множество облачни среди, Cloud Spanner може да се окаже решението, което търсите. Но трябва да сте наясно с всички негови ограничения.
За справедливост е редно да се отбележи, че Cloud Spanner бе пусната за общ достъп едва през пролетта на 2017 г., така че е разумно да очакваме, че някои от настоящите му недостатъци могат да изчезнат в крайна сметка (с надеждата) и когато това се случи, може да промени играта. В края на краищата, Cloud Spanner не е просто страничен проект за Google. Google го използва като основа за други свои продукти. А когато Google наскоро замени Megastore в Google Cloud Storage с Cloud Spanner, това позволи на Google Cloud Storage да стане строго съгласуван за списъци с обекти в световен мащаб (което все още не важи за ).
И така, надежда все още има… ние също се надяваме.
С това приключваме. Както и авторът на статията, ние също продължаваме да се надяваме, а какво мислите вие по този въпрос? Пишете в коментарите.
Всички желаещи са поканени да посетят нашия в рамките на който обстойно ще разкажем за курса от OTUS.
Източник: habr.com
