

Процес по актуализиране на вашия Kubernetes клъстер
В определен момент при използване на Kubernetes клъстер се налага актуализиране на активните нодове. То може да включва актуализации на пакети, актуализиране на ядрото или разпространение на нови образи на виртуални машини. В терминотологията на Kubernetes това се нарича .
Тази публикация е част от цикъл от 4 публикации:
- Тази публикация.
- Коректно завършване на pod-овете в Kubernetes клъстера
- Отложено прекратяване на pod при изтриването му
- Как да избегнем престой в работата на Kubernetes клъстера с помощта на PodDisruptionBudgets
(бел. прев. преводите на останалите статии от цикъла ще очаквате скоро)
В тази статия ще опишем всички инструменти, които предоставя Kubernetes за постигане на нулево време на престой на работещите в клъстера нодове.
Определяне на проблема
Първоначално ще използваме наивен подход, за да определяме проблемите и да оценяваме потенциалните рискове от този подход, като натрупваме знания за решаването на всеки от проблемите, с които ще се сблъскаме през целия цикъл. В резултат ще получим конфигурация, в която се използват lifecycle hooks, readiness probes и Pod disruption budgets за постигане на нашето нулево време на престой.
За да започнем нашия път, нека да вземем конкретен пример. Да предположим, че имаме Kubernetes клъстер от две нодове, в който работи приложение с два pod-а, разположени зад Услуга:
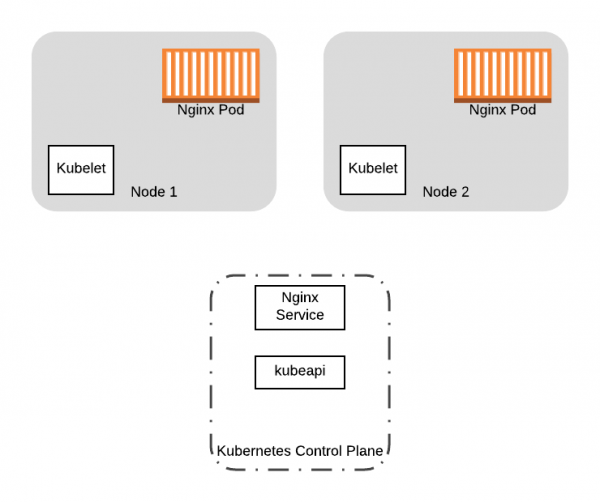
Нека започнем с два pod-а с Nginx и услуга, стартирани на нашите две нодове на Kubernetes клъстера.
Искаме да актуализираме версията на ядрото на двете работещи нодове в нашия клъстер. Как ще го направим? Простото решение би било да заредим нови нодове с актуализирана конфигурация и след това да изключим старите нодове, докато стартираме новите. Макар че това ще сработи, ще има няколко проблема с такъв подход:
- Когато изключите старите нодове, под-овете, работещи на тях, също ще бъдат изключени. Какво ако нужно е да почистите под-овете за коректно изключване? Виртуализиционната система, която използвате, може да не изчака завършването на процеса на почистване.
- Какво ако изключите всички нодове едновременно? Ще получите значителен престой, докато под-овете преминат на новите нодове.
Нужен начин, по който да мигрираме pod'ове от стари нодове, уверявайки се, че нито един от нашите работни процеси не е стартиран, докато правим промени на нода. Или когато правим пълна подмяна на клъстера, какъвто е примерът (тоест заменяме образите на виртуалните машини), ние искаме да преместим работещите приложения от старите нодове на новите. В двата случая искаме да предотвратим планирането на нови pod'ове на старите нодове и след това да изселим всички вече стартирани pod'ове. За да постигнем тези цели, можем да използваме командата kubectl drain.
Преразпределение на всички pod'ове от нода
Операцията drain позволява преразпределението на всички pod'ове от нода. По време на изпълнението на drain, нодът се маркира като unschedulable (флаг NoSchedule). Това предотвратява появата на нови pod'ове на него. След това drain започва да изселва pod'овете от нода, завършвайки работата на контейнерите, които в момента са стартирани на нода, като им изпраща сигнал TERM на контейнерите в pod'а.
Въпреки че kubectl drain чудесно се справя с изселването на pod'овете, има още два фактора, които могат да доведат до провал при изпълнението на операцията drain:
- Вашето приложение трябва правилно да завършва при подаване на
TERMсигнала. Когато pod'овете се изселват, Kubernetes изпраща сигналTERMна контейнерите и изчаква тяхното спиране за зададено количество време, след което, ако те не спрат, ги завършва насилствено. Във всеки случай, ако вашият контейнер не възприеме сигнала правилно, все още можете да потушите pod'овете неправилно, ако те в момента работят (например, ако се изпълнява транзакция в базата данни). - Вие губите всички pod'ове, в които се съдържа вашето приложение. То може да не е достъпно в момента на стартиране на нови контейнери на новите нодове или, ако вашите pod'ове са разположени без контролери, те може изобщо да не се перезапустят.
Избягваме престои
За да минимизираме времето на простои от voluntarily disruption, например от операция drain за нода, Kubernetes предлага следните опции за обработка на неуспехи:
В останалите части на цикъла ще използваме тези функции на Kubernetes за смекчаване на последиците от прехвърлянето на pod'овете. За да е по-лесно да проследим основната идея, ще използваме нашия пример по-горе със следната ресурсна конфигурация:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Тази конфигурация е минимален пример Deployment, който управлява pod-овете nginx в кластера. Освен това, конфигурацията описва ресурс Услуга, който може да се използва за достъп до pod-овете nginx в кластера.
През целия цикъл ще разширяваме итеративно тази конфигурация, за да включим всички възможности, предоставяни от Kubernetes за минимизиране на времето на престой.
За да получите напълно внедрена и тествана версия на актуализациите на кластера Kubernetes за нулево време на престой в AWS и други ресурси, посетете .
Също така прочетете и други статии в нашия блог:
Източник: habr.com
