

Идеи и срещи относно процесите, които могат да бъдат автоматизирани, възникват ежедневно в бизнеси с различен мащаб. Освен че създаването на модел отнема време, е необходимо също да се прецени и провери, че получените резултати не са случайни. След внедряването, всяка моделна система трябва да бъде наблюдавана редовно.
Всички тези етапи са задължителни за всяка компания, независимо от нейните размери. Ако говорим за мащаба на Сбербанк, сложността на настройките нараства многократно. До края на 2019 година в Сбербанк вече са използвани над 2000 модела. Не е достатъчно само да се разработи модел; необходимо е също така интегриране с производствени системи, разработване на витрини с данни за моделирането и осигуряване на контрол върху работата на модела в клъстера.
Нашият екип разработва платформата Sber.DS. Тя позволява решаване на задачи свързани с машинното обучение, ускорява процеса на верификация на хипотези, опростява самия процес на разработване и валидиране на модели, а също така контролира резултатите от работата на модела в ПРОМ.
За да не разочаровам вашите очаквания, искам предварително да уточня, че този пост е вводен и по-долу ще бъде разгледано какво има под капака на платформата Sber.DS. Историята за жизнения цикъл на модела от създаването до внедряването ще разкажем отделно.
Sber.DS се състои от няколко компонента, от които ключовите са библиотека, система за разработка и система за изпълнение на модели.
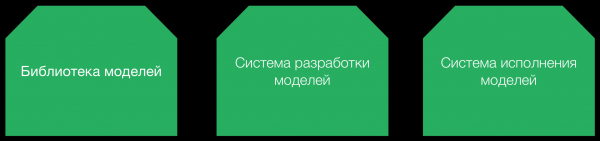
Библиотеката контролира жизнения цикъл на модела от момента на появата на идеята за разработка до внедряването в ПРОМ, наблюдението и изтеглянето от експлоатация. Много от възможностите на библиотеката са продиктувани от правилата на регулатора, например отчетност и съхранение на обучителни и валидиращи набори. По същество, това е регистър на всички наши модели.
Системата за разработка е предназначена за визуално разработване на модели и валидиращи методики. Разработените модели преминават начална валидация и след това се предоставят на системата за изпълнение за изпълнение на своите бизнес функции. Освен това, в системата за изпълнение, моделът може да бъде поставен на монитор за периодично стартиране на валидиращи методики с цел контрол на неговата работа.
В системата има няколко типа възли. Някои са предназначени за свързване с различни източници на данни, други — за трансформация на първоначалните данни и тяхното обогатяване (маркиране). Има множество възли за изграждане на различни модели и възли за тяхната валидация. Разработчикът може да зарежда данни от всякакви източници, да ги преобразува, филтрира, визуализира междинни данни и да ги разделя на части.
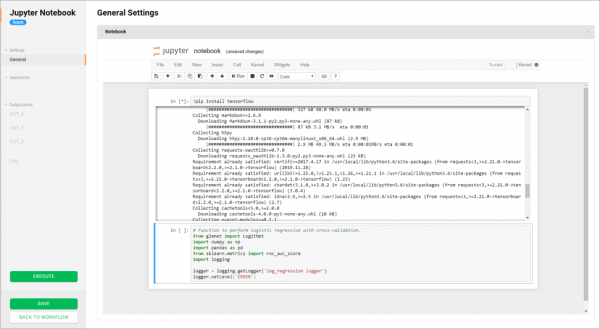
Платформата също така съдържа готови модули, които могат да се плъзгат в работната област. Всички действия се извършват чрез визуален интерфейс. Всъщност можете да решите задачата без нито един ред код.
Ако вградените възможности не са достатъчни, системата предлага възможност за бързо създаване на собствени модули. Ние направихме режим на интегрирано разработване на база за онези, които създават нови модули "от нулата".
Архитектурата на Sber.DS е изградена на микросервизи. Има много мнения относно това какво представляват микросервисите. Някои смятат, че е достатъчно да разделите монолитния код на части, но все пак те се свързват с една и съща база данни. При нас, микросервизът трябва да комуникира с друг микросервиз само чрез REST API. Никакви обходни пътища за достъп до базата данни директно.
Стремим се услугите да не станат твърде големи и неефективни: един екземпляр не трябва да потребява повече от 4-8 гигабайта оперативна памет и е задължително да осигури възможност за хоризонтално мащабиране на запитванията чрез стартиране на нови екземпляри. Всеки сервис комуникира с другите само чрез REST API (). Екипът, отговорен за услугата, е задължен да поддържа обратна съвместимост на API до последния клиент, който я използва.
Ядрото на приложението е написано на Java с използване на Spring Framework. Решението първоначално е проектирано за бързо разгръщане в облачна инфраструктура, затова приложението е изградена с използване на система за контейнеризация (). Платформата постоянно се развива, както в частта за разширяване на бизнес функционалността (добавят се нови конектори, AutoML), така и в частта за технологична ефективност.
Една от основните характеристики на нашата платформа е, че можем да стартираме код, разработен в визуален интерфейс, на всяка изпълнителна система на моделите на Сбербанк. В момента те имат две: една на Hadoop и друга – на OpenShift (Docker). Не спираме дотук и създаваме интеграционни модули за стартиране на кода на всяка инфраструктура, включително on-premise и в облака. По отношение на възможностите за ефективно вграждане в екосистемата на Сбербанк, планираме да поддържаме работа с наличните изпълнителни среди. В перспектива – решението може да бъде гъвкаво вградено „из кутията“ в любая ландшафт на която и да е организация.
Тези, които някога са опитвали да поддържат решение, стартиращо Python на Hadoop в ПРОМ, знаят, че е недостатъчно просто да подготвите и доставите потребителската среда на Python до всяка дата нода. Огромно количество C/C++ библиотеки за машинно обучение, които използват Python модули, не дават спокойствие. Трябва да се помни, че пакетите трябва да се обновяват при добавяне на нови библиотеки или сървъри, запазвайки обратна съвместимост с вече внедрения код на моделите.
Съществуват няколко подхода за това как да го направите. Например, предварително да подготвите няколко често използвани библиотеки и да ги внедрите в ПРОМ. В дистрибутива на Hadoop от Cloudera за това обикновено се използва . Освен това в момента в Hadoop се появява възможността за стартиране на -контейнери. В някои прости случаи можете да доставите кода заедно с пакета .
Банката подхожда много сериозно към безопасността на стартирането на страничен код, затова максимално използваме новите възможности на ядрото на Linux, където процесът, стартиран в изолационна среда , може да бъде ограничен, например, по отношение на достъпа до мрежата и локалния диск, което значително намалява възможностите на злонамерен код. Областите на данни на всеки департамент са защитени и достъпни само за притежателите на тези данни. Платформата гарантира, че данните от една област могат да преминат в друга област само чрез процес на публикуване на данни с контрол на всички етапи от достъпа до източниците до кацането на данните в целевия витрина.
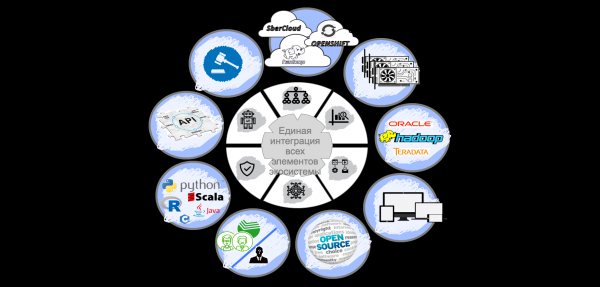
Тази година планираме да завършим MVP за пускането на модели, написани на Python/R/Java в Hadoop. Поставили сме си амбициозната задача да научим как да стартираме всяка потребителска среда на Hadoop, за да не ограничаваме потребителите на нашата платформа.
Освен това, както се оказа, много DS специалисти отлично познават математиката и статистиката, създават страхотни модели, но не разбират добре трансформациите на големи данни и им е необходима помощта на нашите data инженери за подготовка на обучителни набори. Решихме да помогнем на колегите и да създадем удобни модули за стандартна трансформация и подготовка на черти за модели на Spark движка. Това ще позволи да се отдели повече време за разработка на модели и да не се чака, докато дата инженерите подготвят нов набор от данни.
При нас работят хора с познания в различни области: Linux и DevOps, Hadoop и Spark, Java и Spring, Scala и Akka, OpenShift и Kubernetes. В следващия път ще разкажем за библиотеката с модели, за това как моделът преминава през жизнения цикъл вътре в компанията, как протича валидизацията и внедряването.
Източник: habr.com
