

Преводът на статията е подготвен специално за студентите в курса .
През последните няколко седмици добавихме към бинарния потоков формат, допълвайки съществуващия формат на файловете с произволен достъп/IPC. Имаме реализации на Java и C++ и свързващи модули за Python. В тази статия ще обясня как работи форматът и как можем да постигнем много висока пропускна способност на данни за DataFrame pandas.
Потоково предаване на колоночни данни
Често задаван въпрос, който получавам от потребителите на Arrow, е относно високата цена за прехвърляне на големи набори от таблични данни от формат, ориентиран към редове или записи, в колоночен формат. За многогигабайтни набори от данни, транспонирането в паметта или на диска може да се окаже непосилна задача.
За потоково предаване на данни, независимо дали изходните данни са стринг или колоночни, една от опциите остава изпращането на малки пакети от редове, всеки от които съдържа компоновка по колони.
В Apache Arrow колекция от колоночни масиви в паметта, представляваща чанк от таблица, се нарича пакет от записи (record batch). За да се представи единна структура на данни за логическа таблица, могат да се съберат няколко пакета от записи.
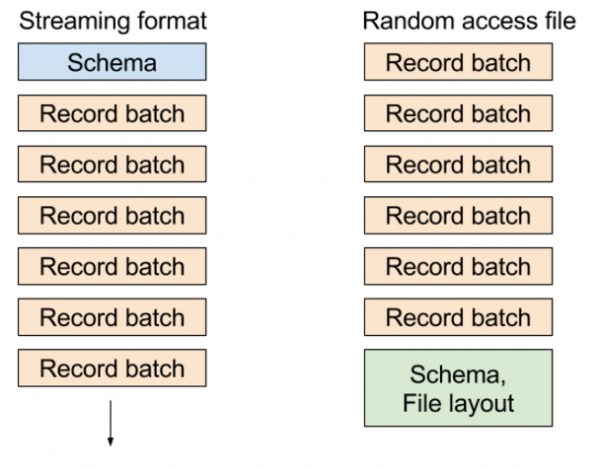
В съществуващия формат на файлове с произволен достъп записваме метаданни, съдържащи схемата на таблицата и местоположението на блоковете в края на файла, което ви позволява изключително евтино да избирате всеки пакет от записи или всяка колона от набор от данни. В потоковия формат изпращаме поредица от съобщения: схемата, след което един или повече пакета от записи.
Различните формати изглеждат приблизително така, както е показано на тази рисунка:
Потоково предаване на данни в PyArrow: приложение
За да ви покажа как работи това, ще създам примерен набор от данни, представляващ един потоков чанк:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Сега, да предположим, че искаме да запишем 1 Гб данни, състоящи се от чанкове с размер 1 Мб всеки, общо 1024 чанка. Първо, нека създадем първия DataFrame с размер 1 Мб и 16 колони:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
След това ще ги конвертирам в pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Сега ще създам поток за изход, който ще записва в оперативната памет и ще създам StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
След това ще запишем 1024 части, които в крайна сметка ще съставят 1Гб набор от данни:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Тъй като записвахме в ОЗУ, целият поток можем да получим в един буфер:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Тъй като тези данни са в паметта, четенето на пакети с записи Arrow е операция с нулево копие. Отварям StreamReader, чета данните в pyarrow.Table, а след това ги конвертирам в DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Всичко това, разбира се, е много добре, но може да имате въпроси. Колко бързо става това? Как размерът на частта влияе на производителността при получаване на DataFrame pandas?
Производителност на потоковото предаване на данни
С намаляване на размера на частта при потоковото предаване, разходите за реконструкция на непрекъснат кадър DataFrame в pandas нарастват поради неефективни схеми за достъп до кеша. Съществуват също така и известни разходи от работата с C++ структури данни и масиви и техните паметни буфери.
За 1 Мб, както е посочено по-горе, на моя лаптоп (Quad-core Xeon E3-1505M) се получава:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
По този начин ефективната пропускателна способност е 7.75 Гб/с за възстановяване на DataFrame с размер 1Гб от 1024 части по 1Мб. Какво се случва, ако използваме по-големи или по-малки части? Ето какви резултати биха се получили:
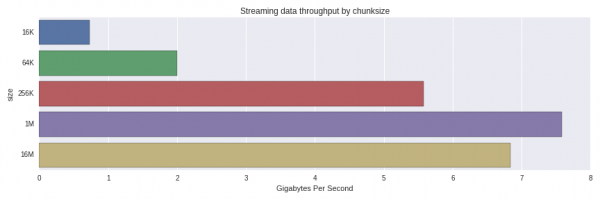
Производителността значително намалява от 256K до 64K части. Учудващо е, че частите с размер 1 Мб се обработват по-бързо, отколкото 16 Мб. Струва си да се направи по-подробно проучване и да се разбере, дали това е нормално разпределение или нещо друго оказва влияние.
В текущата реализация на формата, данните не се компресират изобщо, затова размерът в паметта и „в проводите“ е приблизително един и същ. В бъдеще компресията може да стане допълнителна опция.
Резюме
Потоковото предаване на колонкови данни може да се окаже ефективен начин за предаване на големи набори от данни към колонкови аналитични инструменти, например към pandas, с помощта на малки парчета. Услуги за данни, които използват хранилище, ориентирано към редове, могат да предават и транспонират малки парчета данни, които са по-удобни за кеша L2 и L3 на вашия процесор.
Пълен код
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Източник: habr.com
