

Здравей, Хабр!
Напомняме, че излезе нашата последна изключително интересна и полезна за моделите в Kubernetes. Всичко започна с "" на Брендан Бърнс и, впрочем, работата в тази област при нас . Днес ви предлагаме да прочетете статия от блога на MinIO, която кратко обобщава тенденциите и спецификите на моделите за съхранение на данни в Kubernetes.
Kubernetes коренно промени традиционните модели на разработка и разгръщане на приложения. Сега на екипа може да му отнеме само няколко дни за разработка, тестване и разгръщане на приложение – в различни среди и всичко това в рамките на клъстери Kubernetes. Работата с технологии от предишни поколения обикновено отнемаше цели седмици, ако не и месеци.
Това ускорение стана възможно благодарение на абстракцията, която предоставя Kubernetes – тоест, благодарение на факта, че Kubernetes сам осъществява взаимодействието с низкоуровневите детайли на физическите или виртуалните машини, позволявайки на потребителите да обявяват сред другите параметри необходимия процесор, необходимото количество памет, брой екземпляри на контейнери. Тъй като поддръжката на Kubernetes е ангажирана от огромна общност и обхватът на приложенията на Kubernetes постоянно се разширява, той уверено заема водещо място сред всички платформи за оркестрация на контейнери.
С разширяването на употребата на Kubernetes расте и объркването относно използваните в него модели за съхранение на данни..
При общата конкуренция за парче от баницата Kubernetes (тоест, за хранилище на данни), когато стане въпрос за съхранение на данни, сигналът тук потъва в силен шум.
Kubernetes олицетворява съвременния модел на разработка и разгръщане на приложения, а также тяхното управление. Този съвременен модел открепя съхранението на данни от изчисленията. За да разберем напълно такова открепяне в контекста на Kubernetes, е необходимо също да разберем какво представляват приложенията, работещи с запазване на състояние и без запазване на състояние, както и как съхранението на данни се комбинира с това. Именно тук подходът REST API, приложен в S3, има ясни предимства пред подхода POSIX/CSI, характерен за други решения.
В тази статия ще обсъдим шаблоните за съхранение на данни в Kubernetes и специално ще се спрем на дискусията около приложенията, работещи с персистентност и без персистентност, за да разберем добре каква е разликата помежду им и защо е важна. В текста ще бъдат разгледани приложенията и използваните в тях шаблони за съхранение на данни в светлината на добрите практики за работа с контейнери и Kubernetes.
Контейнери без персистентност
Контейнерите по природа са леки и ефимерни. Те могат лесно да бъдат спирани, изтривани или разгръщани на друг възел – всичко това отнема само секунди. В голямата система за оркестрация на контейнери, тези операции се извършват постоянно, а потребителите дори не забелязват промените. Въпреки това, преместването е възможно само ако контейнерът няма зависимости от възела, на който се намира. Такива контейнери се наричат, че работят без персистентност.
Контейнери с персистентност
Ако контейнерът съхранява данни на локално свързани устройства (или на блочно устройство), то хранилището на данни, на което е разположен, ще трябва да бъде преместено на нов възел заедно с контейнера – в случай на повреда. Това е важно, тъй като в противен случай приложението, стартирано в контейнера, няма да функционира правилно, тъй като трябва да има достъп до данните, съхранявани на локалните носители. Такива контейнери се наричат, че работят с персистентност.
Чисто технически, контейнерите с персистентност също могат да бъдат премествани на други възли. Обикновено това се осигурява чрез разпределени файлови системи или мрежови блочни хранилища, прикрепени към всички възли, на които работят контейнерите. По този начин контейнерите имат достъп до томове за персистентно съхранение на данни и информацията се съхранява на дискове, разположени в цялата мрежа. Този метод ще нарека "контейнерен подход с персистентност", и през останалата част от статията ще го наричам така за единство.
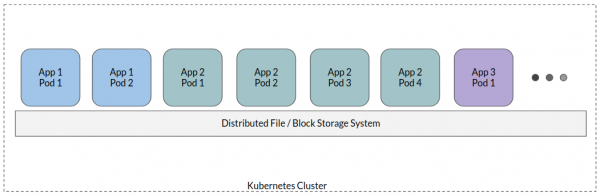
При типичния контейнерен подход с поддържане на състоянието всички подове на приложенията се прикрепят към една разпределена файлова система – получава се нещо като споделено хранилище, където се намират всички данни на приложенията. Въпреки че са възможни някои вариации, това е високостепенен подход.
Сега нека разгледаме защо контейнерният подход с поддържане на състояние в облачно-ориентирания свят е антипатерн.
Облачно-ориентирано проектиране на приложения
Традиционно, приложенията са използвали бази данни за структурирано съхранение на информация и локални дискове или разпределени файлова системи, където се записваха всички неструктурирани или дори полуструктурирани данни. С нарастващия обем на неструктурираните данни, разработчиците осъзнаха, че POSIX е прекалено "балаклив", свързан е със значителни разходи и в крайна сметка пречи на работата на приложението при преминаване към наистина големи мащаби.
Това основно спомогна за появата на нов стандарт за съхранение на данни, т.е. облачно-ориентирани хранилища, които работят основно на базата на REST API и освобождават приложението от тежестта на обслужването на локално хранилище на данни. В такъв случай приложението фактически преминава в режим на работа без поддържане на състояние (тъй като състоянието се намира в отдалечено хранилище). Съвременните приложения се изграждат от нулата, като се взима предвид този фактор. Обикновено всяко съвременно приложение, обработващо данни от един или друг вид (логове, метаданни, блоби и т.н.), е построено според облачно-ориентираната парадигма, където състоянието се пренася в специално предназначена софтуерна система за неговото съхранение.
Контейнерният подход с поддържане на състояние принуждава цялата тази парадигма да се върне точно към това, с което е започнала!
При използване на POSIX интерфейси за съхранение на данни, приложенията функционират по същия начин, както ако запазват състоянието си, и поради това отстъпват от най-важните постулати на облачния дизайн, т.е. възможността да се променят размерите на работните потоци на приложението в зависимост от входящото натоварване, да се прехвърлят на нов възел, веднага щом текущият възел се провали и така нататък.
Когато по-внимателно се вгледаме в тази ситуация, откриваме, че при избора на хранилище за данни отново и отново се сблъскваме с дилемата „POSIX срещу REST API“, НО с допълнително усложнение на проблемите с POSIX, породени от разпределената природа на средите Kubernetes. В частност,
- POSIX многословен: семантиката на POSIX изисква асоцииране на всяка операция с метаданни и файлови дескриптори, които помагат за поддържането на състоянието на операцията. Това води до значителни разходи, които нямат реална стойност. API за обектно съхранение, в частност S3 API, се избавиха от тези изисквания, позволявайки на приложението да изпълни операцията и след това да „забрави“ за извикването. Отговорът на системата за съхранение на данни показва дали операцията е била успешно изпълнена или не. В случай на неуспех приложението може да направи повторен опит.
- Мрежови ограничения: В разпределена система се подразбира, че може да съществуват множество приложения, опитващи да записват данни на един и същ прикрепен носител. Следователно, не само че приложенията ще се конкурират помежду си за ленти на предаване (за да изпратят данни на носителя), самата система за съхранение на данни ще се състезава за тази лента, разпределяйки данни на физически дискове. Поради многословността на POSIX, броят на мрежовите извиквания нараства многократно. От друга страна, S3 API осигурява ясно разделение на мрежовите извиквания между тези, които идват от клиента на сървъра, и тези, които се случват в рамките на сървъра.
- Сигурност: Моделът за сигурност POSIX е проектиран за активно участие на човека: администраторите конфигурират конкретни нива на достъп за всеки потребител или група. Тази парадигма трудно се адаптира към облачно-ориентирания свят. Съвременните приложения разчитат на модели за сигурност, свързани с API, където достъпът се определя като набор от политики, служебни акаунти, временни удостоверения и т.н.
- Управляемост: Контейнерите с персистентност влекат определени разходи, свързани с управлението. Става въпрос за синхронизация на паралелен достъп до данни, осигуряване на последователност на данните, което изисква внимателно обмисляне на кои модели за достъп до данни да се използват. Необходимо е да се инсталират, контролират и конфигурират допълнителни програми, да не говорим за допълнителните усилия, вложени в разработката.
Контейнерен интерфейс за хранилище на данни
Докато контейнерният интерфейс за хранилище на данни (CSI) значително улесни разпространението на нивото томове в Kubernetes, частично предавайки го на трети страни, той също така случайно помогна за убеждението, че контейнерният подход с персистентност е предпочитаният метод за съхранение на данни в Kubernetes.
CSI е разработен като стандарт за предоставяне на произволните системи за блочно и файлово съхранение на данни на наследствени приложения, работещи с Kubernetes. Както беше показано в тази статия, единствената ситуация, в която контейнерният подход с персистентност (и CSI в сегашната му форма) е целесообразен, е когато самото приложение е наследствена система, в която не е възможно добавяне на поддръжка за API за обектно хранилище на данни.
Важно е да се разбере, че при използване на CSI в неговата настояща форма, т.е. монтиране на томове при работа с модерни приложения, ще се сблъскаме с приблизително същите проблеми, които възникнаха и в системи, където съхранението на данни е организирано в стил POSIX.
По-качествен подход
В този случай е важно да разберем, че повечето приложения по своята същност не са проектирани специално за работа със съхранение на състояние или без него. Такова поведение зависи от общата архитектура на системата и от конкретните опции, избрани по време на проектирането. Нека поговорим малко за приложенията, които съхраняват състояние.
В принципе, всички данни на приложенията могат да бъдат разпределени на няколко обширни типа:
- Данни на дневници
- Данни за времеви марки
- Данни за транзакции
- Метаданни
- Образи на контейнери
- Данни от блобове (големи двоични обекти)
Всички тези типове данни се поддържат много добре на съвременните платформи за съхранение на данни, и съществуват няколко облачно-ориентирани платформи, приспособени за достъп до данни в всеки от тези специфични формати. Например, данните за транзакции и метаданните могат да бъдат в съвременна облачно-ориентирана база данни, като CockroachDB, YugaByte и др. Образите на контейнери или данните от блобове могат да се съхраняват в реестрите на Docker, базирани на MinIO. Данните за времеви марки могат да се съхраняват в база данни за времеви редове, например InfluxDB и др. Няма да се задълбочаваме в детайлите на всеки тип данни и съответните приложения, но основната идея е да се избегне персистентното съхранение на данни, основано на локално монтиране на дискове.
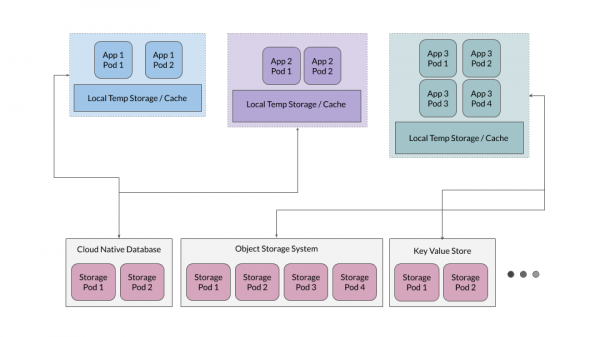
Освен това, често се оказва ефективно да се предостави временно ниво на кеширане, което служи на приложенията като своеобразно хранилище на временни файлове, но приложенията не трябва да зависят от това ниво като източник на истина.
Хранилище за приложения със съхранение на състояние
Докато в повечето случаи е полезно да се държат приложенията без съхранение на състояние, тези приложения, предназначени за съхранение на данни – например, бази данни, обектни хранилища, хранилища на ключ-стойност – трябва да съхраняват състояние. Нека разберем защо тези приложения се разгръщат на Kubernetes. Като пример ще вземем MinIO, но подобни принципи са приложими и за всички други крупни облачно-ориентирани системи за съхранение на данни.
Облачните приложения са проектирани с оглед на максимално ефективно използване на гъвкавостта, характерна за контейнерите. Това означава, че не се правят никакви предположения относно средата, в която ще бъдат разгръщани. Например, в MinIO се използва вътрешен механизъм за излишно кодиране (erasure coding), който осигурява на системата достатъчна устойчивост, за да остане работоспособна дори при отказ на половината от дисковете. Също така, MinIO управлява целостта и сигурността на данните, използвайки собствено хеширане и криптиране на сървъра.
За такива облачно ориентирани приложения, локалните персистентни томове (PV) са най-удобната опция за резервно хранилище. Локален PV предоставя възможност за съхранение на сурови данни, докато приложенията, работещи на тези PV, самостоятелно събират информация, която позволява мащабиране на данните и управление на нарастващите изисквания относно данните.
Този подход е много по-прост и значително по-добре мащабируем в сравнение с PV на базата на CSI, които внасят в системата собствени нива на управление на данните и излишък; проблемът е, че тези нива обикновено влизат в конфликт с приложенията, проектирани на принципа на запазване на състоянието.
Уверено движение към открепване на данните от изчисленията.
В тази статия разгледахме как приложенията се преориентират към работа без запазване на състоянието, иначе казано, съхранението на данните се отделя от изчисленията върху тях. В заключение, нека разгледаме няколко реални примера за тази тенденция.
, известната платформа за анализ на данни, традиционно се използваше със запазване на състоянието и разгръщане в файловата система HDFS. Въпреки това, с преминаването на Spark в облачно ориентирания свят, тази платформа все по-активно се използва без запазване на състоянието с използването на `s3a`. Spark прилага s3a за предаване на състояние в други системи, докато самите контейнери Spark работят напълно без запазване на състоянието. Други големи играчи в областта на аналитиката на големи данни, по-специално, , , също преминават към работа с разделяне на съхранението на данни и изчисленията върху тях.
Сходни модели се наблюдават и при други големи аналитични платформи, сред които Presto, Tensorflow to R, Jupyter. Изнасяйки състоянието в отдалечени облачни системи за съхранение на данни, значително улеснявате управлението на приложението си и неговото мащабиране. Освен това, това спомага за преносимостта на приложението в различни среди.
Източник: habr.com
