

Хиляди мениджъри от офисите за продажби в цялата страна записват в ежедневно десетки хиляди контакта — факти за комуникация с потенциални или вече работещи с нас клиенти. А за да намерим този клиент, първо трябва да го открием, и е добре да стане много бързо. Това най-често става по наименование.
Затова не е изненада, че, разглеждайки отново "тежките" заявки на една от най-натоварените бази — нашия собствен , открих "в топа" заявка за "бързо" търсене по наименование за картотеките на организациите.
Допълнителото разследване разкри интересен пример първо за оптимизация, а след това за деградация на производителността на заявката при последователното й доработване от различни екипи, всеки от които действал единствено от добри намерения.
0: какво искаше потребителят
 [КДПВ ]
Какво обикновено подразбира потребителят, когато говори за "бързо" търсене по наименование? Почти никога не се оказва "честно" търсене по подстрока като ... LIKE '%роза%' — защото тогава в резултата попада не само 'Розалия' и 'Магазин Роза', но и 'Гроза' и дори 'Дом Деда Мороза'.
Потребителят все пак подразбира на обикновено ниво, че трябва да му осигурите търсене по начало на думата в наименованието и да покажете по-релевантно онова, което започва на въведеното. И да го направите практически мигновено — при въвеждане на подстрочен текст.
1: ограничаваме задачата
И още по-малко човек ще въвежда специално 'роз магаз', за да се налага всяка дума да се търси с префикс. Не, на потребителя му е много по-лесно да реагира на бързото предложение за последната дума, отколкото умишлено да "недовежда" предишните — вижте как това работи с всяка търсачка.
Всъщност, правилно формулирането на изискванията към задачата — е повече от половината от решението. Понякога внимателният анализ на use case .
Какво прави абстрактният разработчик?
1.0: външен търсачен двигател
Ой, търсенето е сложно, не ми се занимава с това — да го предадем на devops! Нека те ни развернат външна търсеща система, относително към БД: Sphinx, ElasticSearch,…
Работещ, макар и трудоемък вариант, когато става дума за синхронизация и бързина на промените. Но не в нашия случай, тъй като търсенето се извършва за всеки клиент само в рамките на данните на неговия акаунт. А данните имат достатъчно висока променливост — и ако сега мениджърът е добавил карта 'Магазин Роза', то след 5-10 секунди той вече може да си спомни, че е забравил да посочи имейл и да поиска да я намери и поправи.
Затова — нека търсим "пряко в базата". За щастие, PostgreSQL ни позволява да направим това, и не с един вариант — ще ги разгледаме.
1.1: "честен" подстрок
Хващаме се за словото "подстрок". А всъщност точно за индексно търсене по подстрок (и дори по регулярни изрази!) има отличен ! Само че после трябва правилно да сортираме.
Нека опитаме да вземем за простота такава таблица:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Качваме там 7.8 милиона записи на реални организации и индексираме:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Нека потърсим първите 10 записа за подстрочно търсене:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'роза')
ORDER BY
  lower(name) ~ ('^' || 'роза') DESC -- първо "започващи с"
, lower(name) -- останалото по азбучен ред
LIMIT 10;
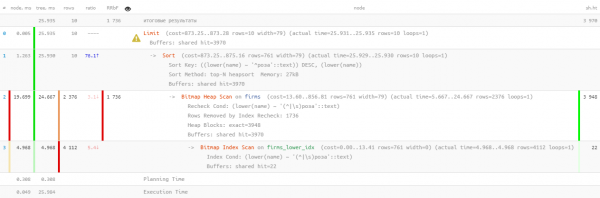
Ами, такова… 26мс, 31MB прочетени данни и над 1.7K филтрирани записи — за 10 търсени. Разходите са твърде големи, не може ли по-ефективно?
1.2: търсене по текст? То е FTS!
Наистина, PostgreSQL предлага много мощен (Full Text Search), включително с възможност за префиксно търсене. Отличен вариант, дори не е нужно да инсталираме разширения! Нека опитаме:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'роза:*')
ORDER BY
lower(name) ~ ('^' || 'роза') DESC
, lower(name)
LIMIT 10; 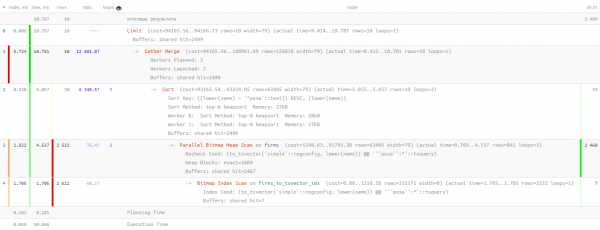
Тук ни помогна малко паралелизацията на изпълнението на заявката, намалявайки времето до 11мс. И прочетеното е с 1.5 пъти по-малко — само 20MB. А тук колкото по-малко — толкова по-добре, тъй като с по-голям обем данни, който четем, шансовете за пропуски в кеша се увеличават, а всяка допълнителна прочетена страница от диска е потенциално "забавяне" за запитването.
1.3: все пак LIKE?
Всички предходни заявки са добри, но ако го извикаме сто хиляди пъти на ден, то ще натрупа 2TB прочетени данни. В най-добрия случай — от паметта, но ако нямаме късмет, и от диска. Нека опитаме да го направим по-малък.
Нека си припомним какво иска да види потребителят първо „които започват с …“. Ами, това е чиста префиксна чрез text_pattern_ops! И само ако не ни достигнат 10 търсени записа, ще трябва да ги прочетем с помощта на FTS-търсене:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('роза' || '%')
LIMIT 10; 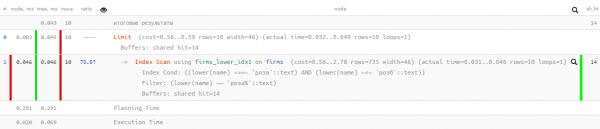
Отлични показатели — едва 0.05мс и малко над 100KB прочетени! Само забравихме сортировката по име, за да не се изгуби потребителят в резултатите:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('роза' || '%')
ORDER BY
  lower(name)
LIMIT 10; 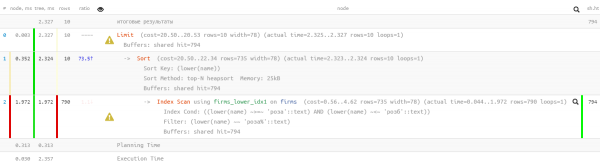
Ох, нещо не изглежда добре — изглежда има индекс, но сортировката остава встрани… Разбира се, вече е много по-ефективно от предишния вариант, но…
1.4: „поправяне с файлник“
Но има индекс, който позволява търсене и по диапазон, и нормална сортировка — обикновен btree!
CREATE INDEX ON firms(lower(name));Обаче заявката за него трябва да се „събере ръчно“:
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'роза' AND
  lower(name) <= ('роза' || chr(65535)) -- за UTF8, за единични байтове - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 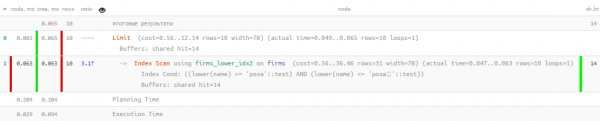
Чудесно — и сортировката работи, и потреблението на ресурси остана „микроскопично“, хиляди пъти по-ефективно от „чисто“ FTS! Остава да съберем в единна заявка:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'роза' AND
    lower(name) <= ('роза' || chr(65535)) -- за UTF8, за единични кодировки - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'роза:*') AND
    lower(name) NOT LIKE ('роза' || '%') -- "започващи с" вече сме ги намерили по-горе
  ORDER BY
    lower(name) ~ ('^' || 'роза') DESC -- използваме същата сортировка, за да НЕ преминем през btree индекса
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Забелязвам, че вторият подзапрос се изпълнява само ако първият е върнал по-малко от очакваното последно LIMIT броя редове. За този метод на оптимизация на заявките вече .
Наистина, сега имаме едновременно btree и gin на таблицата, но статистически се оказва, че по-малко от 10% от заявките достигат до изпълнение на втория блок.. Тоест, при тези известни предварително типични ограничения за задачата успяхме да намалим общото потребление на ресурси на сървъра практически хиляди пъти!
1.5*: ще се справим без файлник
По-горе LIKE пречешествието за неправилно сортиране. Но може да бъде "поставено на правия път" с помощта на оператора USING:
По подразбиране се предполага
ASC. Освен това, можете да зададете името на специфичния оператор за сортиране в изразаUSING. Операторът за сортиране трябва да бъде член на семейство от оператори на B-дерево, "по-малко" или "по-голямо".ASCобикновено е равнозначно наUSING <иDESCобикновено е равнозначно наUSING >.
В нашия случай "по-малко" е ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('роза' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 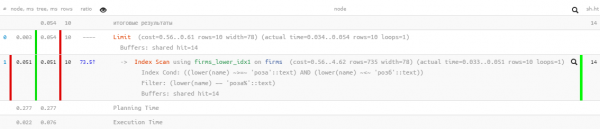
2: как "прокисват" заявките
Сега оставяме нашата заявка да "узрее" половин година-година, и с учудване отново я откриваме "в топа" с показатели за общо ежедневно "прокачване" на паметта (buffers shared hit) в 5.5TB — тоест още повече, отколкото е било първоначално.
Не, разбира се, и бизнесът ни нарасна, и натоварването се увеличи, но не чак толкова! Значи нещо тук не е наред — нека разберем.
2.1: раждане на пейджинга
В някакъв момент на друга екип разработчици им се прииска да направят възможност от бързо подстрочно търсене да "скочат" в регистър с тези същите, но разширени резултати. А какъв регистър без странична навигация? Нека го добавим!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Сега можеше без напрежение за разработчика да се показва регистър на резултатите от търсенето с "тип-пейджинг" зареждане.
Разбира се, всъщност, за всяка следваща страница данните се четат все повече (всички от предишния път, които ще отхвърлим, плюс необходимия "опашка") — тоест това е категоричен антипатерн. А правилно би било — да стартираме търсенето на следващата итерация от запомнения в интерфейса ключ, но за това — друг път.
2.2: искам екзотика
В някакъв момент на разработчика му се прииска да разнообрази резултатната селекция с данни от друга таблица, за което целият предходен заявка беше изпратен в CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- някаква заявка към свързана таблица
FROM
  q
LIMIT 10 OFFSET ;
И дори така — неплохо, тъй като вложената заявка се изчислява само за 10 връщаеми записа, ако не беше...
2.3: DISTINCT безсмислен и безпощаден
Някъде в процеса на еволюцията на втория подзапрос се изгуби NOT LIKE условие. Ясно е, че след това UNION ALL започна да връща некоторые записи дважды — първо намерените по начало на реда, а после пак — по началото на първата дума на този ред. В крайна сметка, всички записи от втория подзапрос биха могли да съвпаднат с записите от първия.
Какво прави разработчикът вместо да търси причината?.. Няма въпрос!
- да увеличим размера двойно първоначални извадки
- да наложим DISTINCT, за да получим само по един екземпляр от всеки ред
С WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Тоест, ясно е, че резултатът в крайна сметка е точно същият, но шансът да "преминем" във втория подзапрос CTE стана много по-висок, а и без това, се чете явно повече.
Но това не е най-лошото. Тъй като разработчикът поиска да се отберем DISTINCT не по конкретни, а директно по всички полета записи, то автоматично на там попадна и полето sub_query — резултатът от подзапроса. Сега, за да се изпълни DISTINCT, базата трябваше да изпълни вече не 10 подзапроса, а всички + 10!
2.4: кооперацията е над всичко!
Така разработчиците живееха — не се оплакваха, защото в регистъра "да нагласиш" до съществени стойности N при хронично забавяне на получаването на всяка следваща "страница" явно нямаше търпение.
Докато не дойдоха разработчици от друг отдел и не пожелаха да се възползват от този удобен метод за итеративно търсене — тоест вземаме от някаква извадка парче, филтрираме по допълнителни условия, рисуваме резултата, после следващото парче (което в нашия случай се постига чрез увеличаване на N), и така, докато не заполним екрана.
В общи линии, в уловения екземпляр N достигна стойности близки до 17K, а за един ден бяха изпълнени "по веригата" не по-малко от 4K такива заявки. Последните от тях спокойно сканираха вече по 1GB памет на всяка итерация…
Общо
Източник: habr.com
