

Един от типичните сценарии в приложенията, които използваме, е търсенето на данни по определени критерии и представянето им в удобен за четене вид. Тук могат да бъдат добавени възможности за сортиране, групиране и странично извеждане. Задачата изглежда проста, но много разработчици правят редица грешки, които влошават производителността. Нека разгледаме различни варианти за разрешаване на тази задача и предложим препоръки за избор на най-ефективна реализация.
Вариант за пейджинг #1
Най-простият вариант, който идва на ум, е постраничното извеждане на резултатите от търсенето в най-класическата му форма.
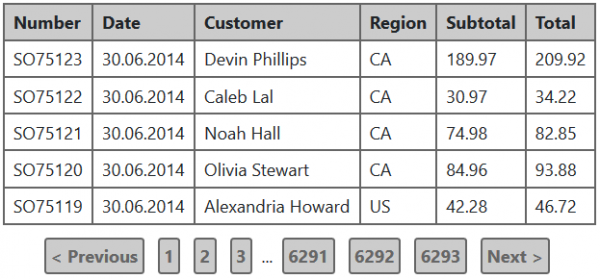
Да предположим, че в приложението се използва релационна база данни. В такъв случай за извеждането на информация в този вид ще трябва да изпълним два SQL записа:
- Да получим редовете за текущата страница.
- Да преброим общия брой редове, отговарящи на критериите за търсене — това е необходимо за показването на страниците.
Нека разгледаме първия запит на примера на тестовата база MS SQL за 2016 година. За целта ще използваме таблицата Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
По-горният запит ще извлече първите 50 поръчки от списъка, сортирани по датата на добавяне в низходящ ред, с други думи — 50-те най-нови поръчки.
Той се изпълнява бързо на тестовата база, но нека погледнем плана за изпълнение и статистиката за вход/изход:
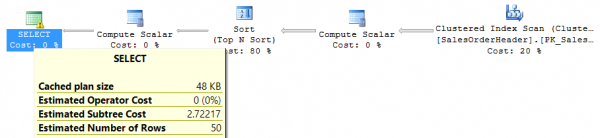
Таблица 'SalesOrderHeader'. Брой сканирания 1, логични прочитания 698, физически прочитания 0, прочитания предварително 0, логични прочитания на LOB 0, физически прочитания на LOB 0, прочитания предварително на LOB 0.Статистиката за вход/изход за всяко запитване може да се получи, изпълнявайки в средата за изпълнение заповеда SET STATISTICS IO ON.
Както може да се види от плана за изпълнение, най-ресурсно интензивно е сортирането на всички редове от основната таблица по дата на добавяне. Проблемът е, че колкото повече редове бъдат добавяни в таблицата, толкова по-тежко ще бъде сортирането. На практика трябва да се избягват такива ситуации, затова добавяме индекс на датата на добавяне и проверяваме дали е променено потреблението на ресурси:
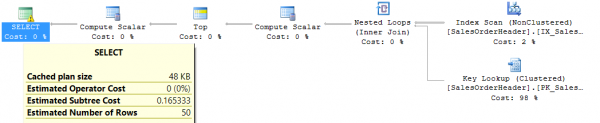
Таблица 'SalesOrderHeader'. Брой сканирания 1, логични прочитания 165, физически прочитания 0, прочитания предварително 5, логични прочитания на LOB 0, физически прочитания на LOB 0, прочитания предварително на LOB 0.
Очевидно, стана много по-добре. Но всички ли проблеми са решени? Нека променим заявката за търсене на поръчки, където общата стойност на стоките надвишава 100 долара:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
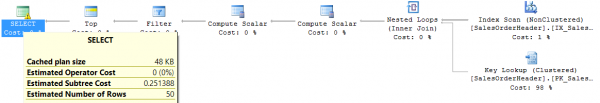
Таблица 'SalesOrderHeader'. Броя на сканиранията 1, логически четения 1081, физически четения 0, предишни четения 0, логически четения на LOB 0, физически четения на LOB 0, предишни четения на LOB 0.Имаме забавна ситуация: планът на заявката не е много по-лош от предишния, но действителното количество логически четения е почти два пъти повече, отколкото при пълното сканиране на таблицата. Има решение — ако направим съществуващия индекс съставен и добавим второто поле с общата цена на стоките, отново ще получим 165 логически четения:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Тази серия примери може да продължи дълго, но две основни мисли, които искам да изразя тук, са:
- Добавянето на всеки нов критерий или ред на сортиране в търсенето може значително да повлияе на скоростта на изпълнение.
- Но ако ни е необходимо да извадим само част от данните, а не всички резултати, отговарящи на условията на търсенето — има много начини да оптимизираме такава заявка.
Сега да преминем към втората заявка, спомената в самото начало — тази, която брои записите, удовлетворяващи критерия за търсене. Нека вземем същия пример — търсене на поръчки, които струват над 100 долара:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
При наличие на съставен индекс, указаният по-горе, получаваме:
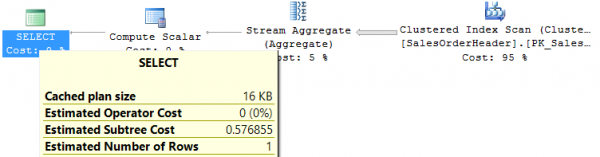
Таблица 'SalesOrderHeader'. Брой сканирания 1, логични прочитания 698, физически прочитания 0, прочитания предварително 0, логични прочитания на LOB 0, физически прочитания на LOB 0, прочитания предварително на LOB 0.Това, че заявката преминава през целия индекс, не е изненада, тъй като полето SubTotal не е на първа позиция, следователно заявката не може да му се възползва. Проблемът се решава с добавянето на още един индекс на полето SubTotal, и в крайна сметка получаваме само 48 логически четения.
Може да се приведат още примери за заявки за броене, но същината остава същата: Получаването на порция данни и броенето на общото количество — това са две принципно различни заявки, и всяка изисква своите мерки за оптимизация. В общия случай не може да се намери комбинация от индекси, която да работи еднакво добре за двете заявки.
Съответно, едно от важните изисквания, които трябва да се уточнят при разработването на подобно търсене - наистина ли е важно на бизнеса да вижда общия брой намерени обекти. Често се случва, че не е. А навигацията по конкретни номера на страници, на моето мнение, е решение с много тясна сфера на приложение, тъй като повечето сценарии с разбивка на страниците изглеждат като "премини на следващата страница".
Опция за странициране #2
Да предположим, на потребителите не им е важно знанието за общия брой намерени обекти. Нека опитаме да опростим страницата за търсене:
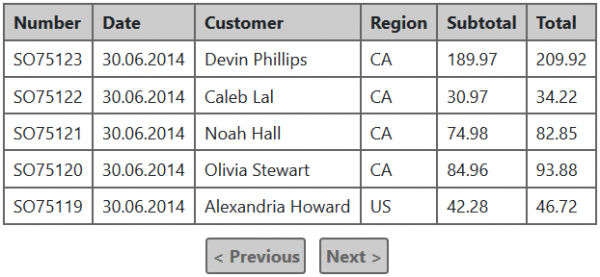
Всъщност се е променило само това, че няма възможност за преминаване през конкретни номера на страници, и сега на тази таблица за показване не й е нужно да знае колко общо може да има. Но възниква въпросът - как таблицата ще разбере дали има данни за следващата страница (за да покаже правилно връзката "Следваща")?
Отговорът е много прост: можем да извлечем от базата с една запис повече, отколкото е нужно за показване, и наличието на този "допълнителен" запис ще показва дали има следваща партида. По този начин, за получаване на една страница данни, е нужно да се направи само едно запитване, което значително подобрява производителността и улеснява поддръжката на такъв функционалност. В моята практика имаше случай, когато отказът от преброяване на общия брой записи ускори резултатите 4-5 пъти.
За този подход съществуват няколко варианта на потребителски интерфейс: команди "назад" и "напред", както в горния пример, бутон "забележи още", който просто добавя нова партида в показаните резултати, "безкрайно превъртане", което работи по принципа "забележи още", но сигналът за получаване на следващата партида е превъртането от потребителя на всички изведени резултати до края. Каквото и да е визуалното решение, принципът на извличане на данни остава същият.
Нюанси на реализиране на страниране
Във всички примери на запити, приведени по-горе, се използва подходът "отсечка + количество", когато в самия запит се посочва от коя по ред линия на резултата и какво количество линии трябва да се върне. Първо ще разгледаме как е най-добре да организираме предаването на параметрите в този случай. На практика съм срещал няколко начина:
- Индекс на исканата страница (pageIndex), размер на страницата (pageSize).
- Индекс на първия запис, който трябва да бъде върнат (startIndex), максимален брой записи в резултата (count).
- Индекс на първия запис, който трябва да бъде върнат (startIndex), индекс на последния запис, който трябва да бъде върнат (endIndex).
На пръв поглед може да изглежда, че това е толкова елементарно, че няма разлика. Но не е така — най-удобният и универсален вариант е вторият (startIndex, count). Има няколко причини за това:
- За подхода с изваждане +1 запис, посочен по-горе, първият вариант с pageIndex и pageSize е крайно неудобен. Например, когато искаме да показваме 50 записи на страница. Според предоставения алгоритъм, трябва да четем с една стойност повече от необходимото. Ако това "+1" не е включено на сървъра, получаваме, че за първата страница трябва да заявяваме записи от 1 до 51, за втората — от 51 до 101 и т.н. Ако зададем размер на страницата 51 и увеличим pageIndex, то втората страница ще върне от 52 до 102 и т.н. Следователно, в първия вариант единственият начин да реализираме нормално бутона за преминаване на следващата страница е да включим на сървъра изваждане на "излишния" ред, което ще бъде много неясен нюанс.
- Третият вариант няма смисъл, тъй като за извършване на заявки в повечето бази данни все пак трябва да бъде предадено количеството, а не индекса на последния запис. Нека изваждането на startIndex от endIndex е елементарна аритметична операция, но тук е излишна.
Сега трябва да опиша недостатъците на реализирането на пейджинг чрез "преместване + количество":
- Получаването на всяка следваща страница ще изисква повече ресурси и ще бъде по-бавно от предишната, защото базата данни все пак трябва да премине през всички записи "отначало" според критериите за търсене и сортировка, след което да спре на нужния фрагмент.
- Не всички СУБД могат да поддържат този подход.
Има алтернативи, но те също не са идеални. Първият от тези подходи се нарича „keyset paging“ или „seek method“ и се състои в следното: след получаване на порция можете да запомните стойностите на полетата в последния запис на страницата, а след това да ги използвате за получаване на следващата порция. Например, направихме такава заявка:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
В последната записка получихме стойността на датата на поръчката ‘2014-06-29’. Тогава за получаване на следващата страница можем да опитаме следното:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Проблемът е, че OrderDate не е уникално поле и условието, посочено по-горе, с голяма вероятност ще пропусне много нужни редове. За да добавим уникалност към този запит, е необходимо да добавим уникалното поле към условието (предположим, че 75074 е последната стойност на първичния ключ от първата партида):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Тази опция ще работи коректно, но в общия случай ще бъде трудно да се оптимизира, тъй като условието съдържа оператор OR. Ако с нарастването на OrderDate нараства стойността на първичния ключ, то условието може да бъде опростено, оставяйки само филтъра по SalesOrderID. Но ако между стойностите на първичния ключ и полето, по което е сортиран резултатът, няма строга корелация — в повечето СУБД избягването на този OR няма да е възможно. Известното ми изключение е PostgreSQL, където напълно се поддържа сравнението на кортежи, и посоченото по-горе условие може да бъде записано като „WHERE (OrderDate, SalesOrderID) < (‘2014-06-29’, 75074)“. При наличие на съставен ключ с тези две полета подобен запит трябва да бъде достатъчно лесен.
Вторият алтернативен подход може да бъде намерен, например, в или — когато запитването, освен данни, връща специален идентификатор, с който може да се получи следващата партида данни. Ако този идентификатор има неограничен срок на живот (както в Cosmos DB), то това е отличен начин за реализиране на пейджинг с последователен преход между страниците (вариант #2, споменат по-горе). Неговите възможни недостатъци: не се поддържа далеч не във всички СУБД; полученото идентификатор на следващата партида може да има ограничен срок на живот, което в общия случай не е подходящо за реализиране на взаимодействие с потребителя (както, например, ElasticSearch scroll API).
Сложна филтрация
Усложняваме проблема още повече. Да предположим, появи се изискване да реализираме т. нар. faceted search, добре познат по интернет магазините. Приведените по-горе примери, базирани на таблицата за поръчки, не са много показателни в този случай, затова ще преминем към таблицата Product от базата AdventureWorks:
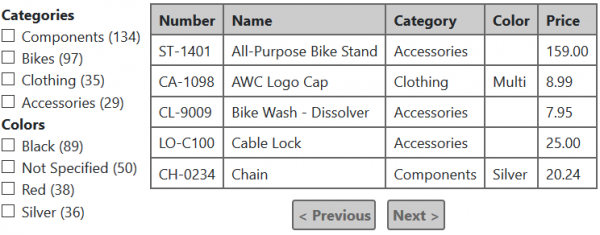
Каква е идеята на faceted search? В това, че за всеки елемент от филтъра се показва броят на записите, съответстващи на този критерий с оглед на филтрите, избрани във всички останали категории.
Например, ако изберем в този пример категория Bikes и цвят Black, таблицата ще показва само черни велосипеди, но при това:
- За всеки критерий от групата „Categories“ ще бъде показан брой на продуктите от тази категория в черен цвят.
- За всеки критерий от групата „Colors“ ще бъде показан брой на велосипедите в този цвят.
Ето пример за изхода на резултата при такива условия:
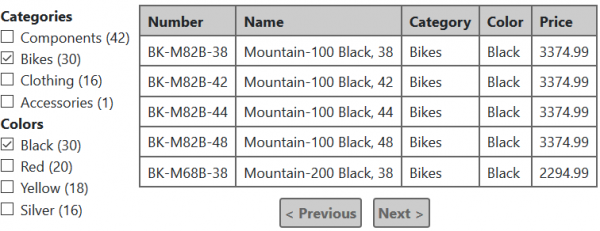
Ако допълнително отбележим категория „Clothing“, таблицата ще покаже и налична черна дреха. Броят на черните продукти в секцията „Color“ също ще бъде препотчитан в съответствие с новите условия, но в секцията „Categories“ нищо няма да се промени… Надявам се тези примери да са достатъчни, за да разбере познатия алгоритъм на работа с faceted search.
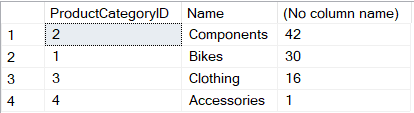
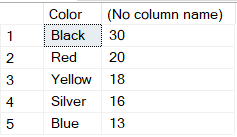
Сега да си представим как може да се реализира това на релационна база. Всяка група критерии, такава като Category и Color, ще изисква отделна заявка:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Какво не е наред с това решение? Много просто - то не се мащабира добре. Всяка секция на филтъра изисква отделна заявка за броене и тези заявки не са най-лесните. В интернет магазините, в някои категории, може да има и няколко десетки секции на филтъра, което може да създаде сериозни проблеми за производителността.
Обикновено след тези твърдения ми предлагат някои решения, а именно:
- Обединете всички бройки в една заявка. Технически е възможно с помощта на ключовата дума UNION, но това не помага особено за производителността — базата данни ще трябва да изпълни „от нула“ всеки от фрагментите.
- Кеширайте броя. Това ми предлагат почти всеки път, когато описвам проблема. Но тук е уловката — в общия случай това е невъзможно. Да предположим, че имаме 10 „фасета“, всяко от които има 5 стойности. Това е много „скромна“ ситуация на фона на това, което можем да видим в интернет магазините. Изборът на един елемент от фасета влияе на броя в останалите 9, с други думи, за всяка комбинация от критерии броят може да бъде различен. В нашия пример има 50 критерия, които потребителят може да избере, следователно възможните комбинации ще бъдат 250. За запълване на такъв масив от данни няма да стигне нито памет, нито време. Може да се възрази и да се каже, че не всички комбинации са реални и потребителят рядко избира повече от 5-10 критерия. Да, може да се направи мърляво зареждане и кеширане на броя само за тези, които някога са били избрани, но колкото повече варианти за избор има, толкова по-малко ефективен ще бъде този кеш и толкова по-забележими ще бъдат проблемите с времето за отговор (особено ако наборът от данни редовно се променя).
Щастливо, подобна задача отдавна има достатъчно ефективни решения, които предсказуемо работят с големи обеми данни. За всяка от тези опции има смисъл да разделите преизчислението на фасетите и получаването на резултатите на две паралелни обаждания до сървъра и да организирате потребителския интерфейс по такъв начин, че зареждането на данни за фасетите „не пречи“ на показването на резултатите от търсенето.
- Избягвайте пълен повторен отчет на фасетите колкото е възможно по-рядко. Например, не преразглеждайте всичко при всяка промяна в критериите за търсене, а вместо това открийте общия брой резултати, които отговарят на текущите условия, и предложете на потребителя да ги покаже — "1425 записа намерени, да покажем?" Потребителят може или да продължи да променя условията за търсене, или да натисне бутона "показване". Само в този втори случай ще се изпълнят всички заявки за получаване на резултати и повторен отчет на количествата на всички фасети. При това, както лесно може да се забележи, ще се наложи да се справите с искането за получаване на общия брой резултати и оптимизацията му. Този метод може да се срещне в много малки интернет-магазини. Очевидно е, че това не е панацея за въпросния проблем, но в простите случаи може да бъде неплох компромис.
- Използвайте търсачки за получаване на резултати и броене на фасетите, като Solr, ElasticSearch, Sphinx и други. Всички те са проектирани за изграждане на фасети и го правят доста ефективно чрез инвертиран индекс. Как работят търсачките, защо в такива случаи са по-ефективни от универсалните бази данни, какви практики има и какви подводни камъни могат да се срещнат — това е тема за отделна статия. В този контекст искам да подчертая, че търсачката не може да замени основното хранилище на данни, а се използва като допълнение: всяка промяна в основната база, която е от значение за търсенето, се синхронизира в търсаческия индекс; механизмът за търсене обикновено взаимодейства само с търсачката и не се връща към основната база. Един от най-важните моменти тук е как да организирате тази синхронизация надеждно. Всичко зависи от изискванията към "времето за отговор". Ако времето между промените в основната база и неговото "проявление" в търсенето не е критично, може да се създаде услуга, която на всеки няколко минути търси наскоро променените записи и ги индексира. Ако изисква минимално възможно време за реакция, може да се реализира нещо като за изпращане на актуализации в търсещата услуга.
Изводи
- Реализация на сървърното пейджинг е сериозно усложнение и има смисъл да се прилага само за бързо растящи или просто големи набори от данни. Как да оценим "голям" или "бързо растящ" — абсолютно точна рецепта няма, но аз бих се придържал към такъв подход:
- Ако получаването на цялата колекция от данни с оглед на времето на сървъра и предаването по мрежата нормално попада в изискванията за производителност — реализирането на пейджинг на сървъра няма смисъл.
- Може да се случи така, че за ближайшето време проблеми с производителността не се предвиждат, тъй като данните са малко, но колекцията от данни постоянно расте. Ако някакъв набор от данни в перспектива може да спре да удовлетворява предходния пункт — по-добре е да се заложи пейджинг веднага.
- Ако от бизнес страна няма стриктно изискване за показване на общия брой резултати или за показване на номера на страниците, и в същото време във вашата система няма търсачка — по-добре е да не реализирате тези моменти и да разгледате вариант #2.
- Ако има ясно изискване за фасетно търсене, имате две опции да не жертвате производителността:
- Да не се преизчисляват всички количества при всяка промяна на критериите на търсенето.
- Да се използват търсачки като Solr, ElasticSearch, Sphinx и други. Но трябва да се разбере, че той не може да замени основната база данни и трябва да се използва като допълнение към основното хранилище за решаване на търсачки задачи.
- Също така в случая на фасетно търсене има смисъл да се раздели получаването на страницата с резултати от търсенето и броенето на количествата на два паралелни запитвания. Броенето на количествата може да отнеме повече време, отколкото получаването на резултатите, докато резултатите са по-важни за потребителя.
- Ако използвате SQL база за търсене, всяка промяна на кода, свързана с тази част, трябва да бъде добре тествана по отношение на производителността за съответния обем данни (превишаващ обема в "живата" база). Желателно е също така да се използва мониторинг на времето за изпълнение на запитванията на всички екземпляри на базата, и особено — на "живата". Дори ако на етапа на разработка с плановете за запитвания всичко е било наред, с нарастващия обем на данните ситуацията може да се промени значително.
Източник: habr.com
