

Съ Elasticsearch се сблъскват много. Но какво се случва, когато искаш да съхраняваш логове на "особено голямо количество"? И то безболезнено да преживееш отказа на един от няколко дата центъра? Какво архитектурно решение да предприемеш и на какви подводни камъни може да се натъкнеш?
В Однокласниках решихме с помощта на Elasticsearch да решим проблема с управлението на логове, а сега споделяме с Хабра опита си: за архитектурата и подводните камъни.
Аз съм Пьотр Зайцев, работя като системен администратор в Однокласниках. Преди това също бях администратор, работих с Manticore Search, Sphinx Search, Elasticsearch. Вероятно, ако се появи още някакво …search, ще работя и с него. Участвам също в редица опенсорс проекти на доброволна основа.
Когато дойдох в Однокласниках, бях безразсъден на интервюто и казах, че умея да работя с Elasticsearch. След като се адаптирах и изпълних някои основни задачи, получих голямо задание за реформиране на системата за управление на логовете, която съществуваше до момента.
Изисквания
Изискванията към системата бяха формулирани по следния начин:
- Като фронтенд трябваше да се използва Graylog. Защото в компанията вече имаше опит с този продукт, програмистите и тестерите го познаваха, той им беше удобен.
- Обем на данните: средно 50-80 хиляди съобщения в секунда, но ако нещо се счупи, трафикът не е ограничен, може да бъде 2-3 милиона реда в секунда.
- След обсъждане на изискванията с клиентите относно скоростта на обработка на търсенията, разбрахме, че типичният вариант на използване на такава система е следният: хората търсят логовете на своето приложение за последните два дни и не искат да чакат резултата на формулираното запитване повече от секунда.
- Администраторите настояваха системата да може лесно да се мащабира при необходимост, без да е нужно дълбочинно да се вниква в начина, по който тя е устроена.
- Единствената задача за поддръжка, която тези системи периодично изискваха, беше да се смени някакво оборудване.
- Освен това, в Однокласниках има прекрасна техническа традиция: всяка услуга, която пускаме, трябва да оцелее след отказ на дата център (неочакван, непланиран и напълно по всяко време).
Последното изискване за реализация на този проект ни коства най-много усилия, за което ще разкажа по-подробно.
Среда
Работим на четири дата центъра, като нодовете на Elasticsearch могат да се намират само в три (поради редица не-технически причини).
В тези четири дата центъра има около 18 хиляди различни източника на логове — устройства, контейнери, виртуални машини.
Важно свойство: стартирането на клъстера се осъществява в контейнери не на физически машини, а на . На контейнерите се гарантират 2 ядра, подобни на 2.0Ghz v4 с възможност за използване на останалите ядра в случай на бездействие.
Иначе казано:
Топология
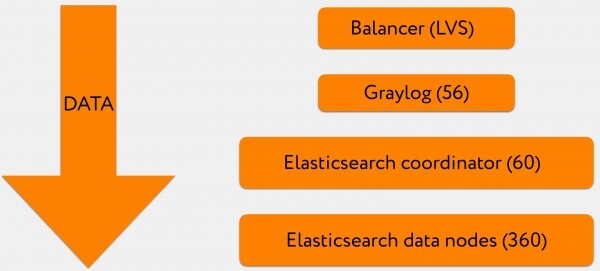
Общият вид на решението ми се струваше следният:
- 3-4 VIP адреси стоят зад А-записа на домейна Graylog, това е адресът, на който се изпращат логовете.
- Всеки VIP представлява балансировщик LVS.
- След това, логовете стигат до батерията Graylog, част от данните идват в формат GELF, част в формат syslog.
- След това всичко това се записва в батерия от координатори на Elasticsearch на големи партиди.
- Те, от своя страна, изпращат заявки за запис и четене към съответните ноди.
Терминология
Възможно е не всички да разбират добре терминологията, затова бих искал да се спра на нея.
В Elasticsearch има няколко типа нодове — master, coordinator, data node. Има и два други типа за различни трансформации на логове и свързване на различни клъстери помежду си, но ние използвахме само изброените.
Master
Пингва всички присъстващи в клъстера нодове, поддържа актуална карта на клъстера и я разпространява между нодовете, обработва събитийната логика, занимава се с всякакъв вид обобщена поддръжка на клъстера.
Координатор
Изпълнява една единствена задача: приема заявки от клиенти за четене или запис и маршрутизира този трафик. В случай, че заявката е за запис, вероятно ще пита master в кой шард на съответния индекс да я положи и ще пренасочи заявката по-нататък.
Данен нод
Съхранява данни, извършва входящи търсения и операции върху разположените на нея шардове.
Graylog
Това е нещо като сплав Kibana с Logstash в ELK стек. Graylog комбинира в себе си и UI, и pipeline за обработка на логове. Под капака на Graylog работят Kafka и Zookeeper, които осигуряват свързаност на Graylog като клъстер. Graylog може да кешира логовете (Kafka) в случай на недостъпност на Elasticsearch и да повтаря неуспешни заявки за четене и запис, да групира и маркира логовете по зададени правила. Като Logstash, Graylog има функционалност за модификация на редовете преди запис в Elasticsearch.
Освен това, в Graylog има вградено service discovery, позволяващо на базата на една налична нода Elasticsearch да получи цялата карта на клъстера и да я филтрира по определен етикет, което дава възможност за насочване на заявки към определени контейнери.
Визуално, това изглежда приблизително така:

Това е скрийншот от конкретен инстанс. Тук по търсене изграждаме хистограма, извеждаме релевантни редове.
Индекси
Връщайки се на архитектурата на системата, бих искал да се спра по-подробно на това как изградихме модела на индексите, за да работи всичко коректно.
На представената по-рано схема, това е най-долното ниво: Elasticsearch data nodes.
Индексът е голяма виртуална същност, състоящa се от шардове на Elasticsearch. Всеки от шардовете не е нищо повече от Lucene индекс. А всеки Lucene индекс, от своя страна, се състои от един или повече сегменти.
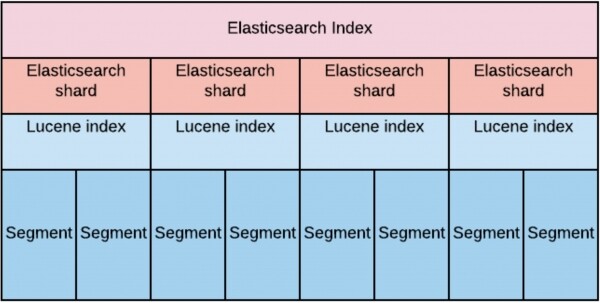
При проектиране, ние предполагахме, че за да осигурим изискванията за скорост на четене на големи обеми данни, трябва да "разпределим" тези данни равномерно по дата-нодовете.
Това доведе до това, че броят на шардовете на индекс (с реплики) трябва да бъде строго равен на броя на дата-нодовете. Първо, за да осигурим replication factor равен на две (т.е. можем да загубим половината от клъстера). А второ, за да можем да обработваме заявки за четене и запис без проблем поне на половината от клъстера.
Периодът на съхранение първоначално определихме на 30 дни.
Разпределението на шардовете може да се представи графично по следния начин:
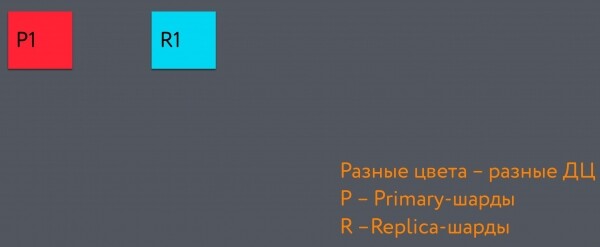
Целият тъмен правоъгълник е индексът. Левият червен квадрат в него е primary shard, първият в индекса. А синият квадрат е replica shard. Те се намират в различни дата центрове.
Когато добавим още един шард, той попада в третия дата център. В крайна сметка получаваме такава структура, която осигурява загуба на дата център без загуба на консистентност на данните:
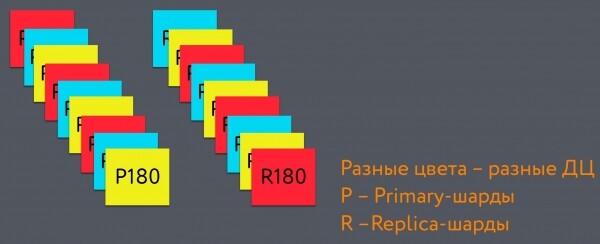
Ротацията на индексите, т.е. създаването на нов индекс и изтриването на най-стария, е зададена на 48 часа (според модела на използване на индекса: последните 48 часа се търсят най-често).
Този интервал за ротация на индексите е свързан със следните причини:
Когато конкретна дата нода получи търсене, от гледна точка на производителността е по-изгодно да се опрашва един шард, ако размерът му е сравним с размера на хипа на нодата. Това позволява да се запази "горещата" част на индекса в хипа и бързо да се получи достъп до нея. Когато "горещите части" станат много, скоростта на търсене по индекса намалява.
Когато нодата започне да изпълнява търсенето на един шард, тя разпределя брой нишки, равен на броя на хипертрединговите ядра на физическата машина. Ако търсенето обхваща голям брой шардове, броят на нишките нараства пропорционално. Това негативно влияе на скоростта на търсене и оказва лошо влияние върху индексирането на нови данни.
За да осигурим необходимата латентност на търсенето, решихме да използваме SSD. За бързата обработка на запитвания машините, на които се намират тези контейнери, трябва да имат поне 56 ядра. Числото 56 е избрано като условно достатъчно, определящо броя на нишките, които Elasticsearch ще генерира в процеса на работа. В Elasticsearch много параметри на thread pool зависят директно от броя на наличните ядра, което от своя страна оказва пряко влияние на необходимия брой нодове в клъстера по принципа "по-малко ядра — повече нодове".
В крайна сметка се получава, че средно един шард тежи около 20 гигабайта и на 1 индекс се падат 360 шардове. Следователно, ако ги ротирахме на всеки 48 часа, имаме 15 от тях. Всеки индекс съдържа данни за 2 дни.
Схеми за запис и четене на данни
Нека разберем как в тази система се записват данни.
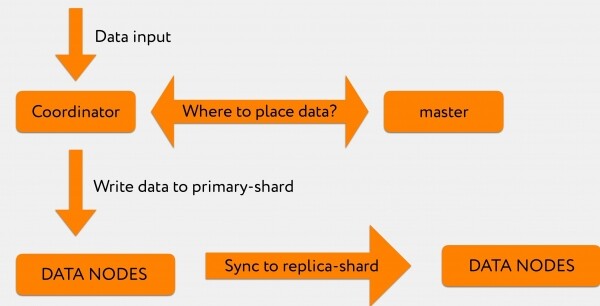
Да предположим, че получаваме искане от Graylog в координатора. Например, искаме да индексираме 2-3 хиляди реда.
Координаторът, получавайки заявка от Graylog, запитва майстор: „В заявката за индексация конкретно беше посочен индекс, но в кой шард да се запише — не е уточнено.”
Майсторът отговаря: „Запиши тази информация в шард номер 71”, след което тя се изпраща направо към съответния дата-нода, където се намира primary-shard номер 71.
След това логът на транзакциите се репликира на replica-shard, който вече се намира в друг дата-център.
От Graylog към координатора пристига търсене. Координаторът го пренасочва по индекса, като Elasticsearch по принципа round-robin разпределя заявките между primary-shard и replica-shard.
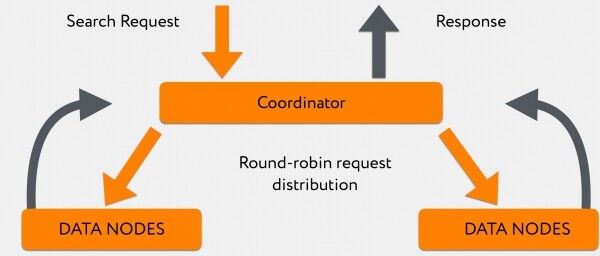
Нодовете, в количество 180, отговарят неравномерно, и докато те отговарят, координаторът натрупва информация, която в него вече са „изплюли” по-бързите дата-ноди. След това, когато или цялата информация е пристигнала, или по заявка е достигнат таймаут, я предоставя директно на клиента.
Цялата тази система средно обработва търсенията по последните 48 часа за 300-400ms, с изключение на тези заявки, които имат leading wildcard.
„Цветята” с Elasticsearch: настройка на Java
За да проработи всичко така, както първоначално искахме, дълго настройвахме разнообразни неща в кластера.
Първата част от откритите проблеми беше свързана с това, как Java е предварително настроена по подразбиране в Elasticsearch.
Проблема първа
Наблюдавахме много съобщения за това, че на нивото на Lucene, когато са стартирани background job-ове, сливането на сегменти Lucene завършва с грешка. В логовете се виждаше, че това е OutOfMemoryError грешка. По телеметрия виждахме, че хипът е свободен и не беше ясно защо тази операция се проваля.
Изясни се, че сливането на Lucene индексите се извършва извън хипа. А контейнерите са доста строго ограничени по потребяваните ресурси. В тези ресурси се включваше само хипът (стойността heap.size беше приблизително равна на RAM), а някои off-heap операции се проваляха с грешка при алокацията на памет, ако по някаква причина не успяваха да се съберат в тези ~500MB, които остават до лимита.
Фиксът беше доста тривиален: увеличихме наличния обем RAM за контейнера, след което забравихме, че изобщо сме имали такива проблеми.
Втората проблема
След около 4-5 дни след стартиране на кластера забелязахме, че дата-нодовете започват периодично да изпадат от кластера и след това се връщат в него след 10-20 секунди.
Когато започнахме да се разследва, установихме, че паметта off-heap в Elasticsearch не се контролира практически по никакъв начин. Когато предоставихме на контейнера повече памет, получихме възможността да запълваме direct buffer pools с различна информация, и тя се освобождаваше само след като се стартираше explicit GC от страна на Elasticsearch.
В някои случаи тази операция отнемаше доста време, и през това време клъстерът успяваше да маркира този възел като вече излязъл. Този проблем е добре описан. .
Решението беше следното: ограничихме на Java възможността да използва основната част от паметта извън хипа за тези операции. Ограничихме я до 16 гигабайта (-XX:MaxDirectMemorySize=16g), постигайки това, че explicit GC се извикваше значително по-често и работеше значително по-бързо, като по този начин не дестабилизираше клъстера.
Трети проблем
Ако мислите, че проблемите с "възли, напускащи клъстера в най-непредвидимия момент" тук свършват, грешите.
Когато конфигурирахме работата с индексите, избрахме mmapfs, за да по свежите шардове с голяма сегментация. Това беше доста груба грешка, защото при използване на mmapfs файлът се мапва в оперативната памет, а след това работим вече с мапнатия файл. Поради това, при опит GC да спре нишките в приложението, ни отнема много време, за да достигнем до safepoint, и по пътя към него приложението спира да отговаря на запитванията на мастера относно това дали е живо. Следователно, мастера счита, че възелът вече не присъства в клъстера. След това, след около 5-10 секунди, garbage collector завършва, възелът се съживява, отново влиза в клъстера и започва инициализация на шардовете. Всичко това много напомняше на "продукцията, която заслужаваме" и не беше подходящо за нещо сериозно.
За да се избавим от такова поведение, първо преминахме на стандартния niofs, а след това, когато се мигрирахме от петите версии на Elastic на шестите, опитахме hybridfs, където този проблем не се възпроизвеждаше. Подробно за типовете сторидж може да се прочете. .
Четвърти проблем
След това имаше още един много интересен проблем, който лечихме изключително дълго. Ловяхме го 2-3 месеца, защото моделът му беше абсолютно неразбираем.
Понякога нашите координатори преминаваха в Full GC, обикновено следобед, и след това не се връщаха. По време на логването на забавянията на GC, това изглеждаше така: всичко вървеше добре, добре, добре, а после - и всичко рязко стана лошо.
Първоначално мислехме, че имаме зъл потребител, който стартира някаква заявка, която извежда координатора от работен режим. Дълго логвахме заявките, опитвайки се да разберем какво се случва.
В крайна сметка се оказа, че когато някой потребител стартира огромна заявка и тя попада на определен координатор Elasticsearch, някои нодове отговарят по-дълго от останалите.
И времето, през което координаторът чака отговор от всички нодове, той трупа резултати, получени от вече отговорили нодове. За GC това означава, че паттернът на използване на хипа много бързо се променя. И този GC, който използвахме, не се справяше с тази задача.
Единственото решение, което намерихме за промяна на поведението на кластера в такава ситуация, е миграция към JDK13 и използване на събирача на боклук Shenandoah. Това реши проблема, координаторите вече не умираха.
С това проблемите с Java приключиха и започнаха проблемите с пропускната способност.
«Ягодките» с Elasticsearch: пропускна способност
Проблемите с пропускната способност означават, че нашият клъстер работи стабилно, но по време на пикове на индексируемите документи и в моментите на маневри производителността е недостатъчна.
Първият забелязан симптом: при някакви «взривове» на продукцията, когато рязко се генерира много голямо количество логове, в Graylog започва да се появява грешка при индексирането es_rejected_execution.
Това се случваше, защото thread_pool.write.queue на една дата-нода преди Elasticsearch да успее да обработи заявката за индексиране и да запише информацията в шард на диск по подразбиране може да кешира само 200 заявки. И в за този параметър се казва много малко. Посочено е само лимитът на нишките и подразбирания размер.
Разбира се, решихме да настроим това значение и установихме следното: конкретно в нашия сетъп доста добре се кешират до 300 заявки, а по-голямо значение е свързано с това, че отново ще преминем в Full GC.
Освен това, тъй като става въпрос за пакети от съобщения, които пристигат в рамките на едно запитване, беше необходимо също така да се настрои Graylog, за да записва не често и на малки пакети, а на огромни пакети или на всеки 3 секунди, ако пакетът все още не е пълен. В такъв случай, информацията, която записваме в Elasticsearch, става достъпна не след две секунди, а след пет (което ни устройва напълно), но намалява броя на повторните опити, които трябва да направим, за да пробутаме голям пакет информация.
Това е особено важно в моментите, когато нещо някъде е паднало и яростно съобщава за това, за да не получаваме напълно спамвания Elastic, а след известно време — неработещи ноди Graylog поради запушени буфери.
Освен това, когато се случваха тези експлозии на продукцията, получавахме жалби от програмисти и тестери: в момента, когато им трябват тези логове, те им се предават много бавно.
Започнахме да се разследваме. От една страна, беше ясно, че и търсещите заявки, и заявките за индексиране реално работят на едни и същи физически машини, и в крайна сметка определени спадове ще настъпят.
Но това частично можеше да бъде заобиколено благодарение на новия алгоритъм в шести версии на Elasticsearch, който позволява разпределяне на запитванията между съответните дата-ноди не на случаен принцип round-robin (контейнерът, който се занимава с индексирането и държи primary-shard, може да бъде много зает и да няма възможност да отговори бързо), а да насочите това запитване към по-малко натоварен контейнер с replica-shard, който ще отговори значително по-бързо. С други думи, стигнахме до use_adaptive_replica_selection: true.
Картина на четенето започва да изглежда така:
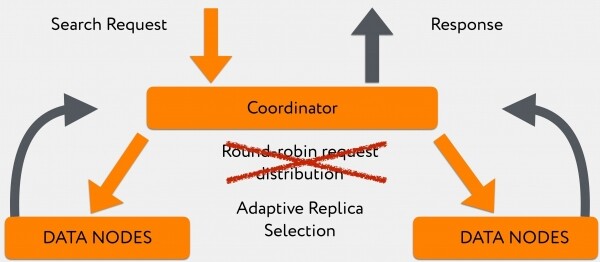
Преходът към този алгоритъм значително подобри времето за запитване в моментите, когато имаше голям поток от логове за запис.
Накрая, основният проблем беше безболезненото изваждане на дата-центъра.
Какво искахме от клъстера веднага след загубата на връзка с един дата-център:
- Ако в изключения дата-център се намира текущият master, той ще бъде преизбран и ще премине като роля на друга нода в друг дата-център.
- Мастърът бързо ще изхвърли от клъстера всички недостъпни ноди.
- На основа на останалите, той ще разбере: в изгубения дата-център сме имали такива primary-шарды, бързо ще промотира комплиментарни replica-шарды в останалите дата-центрове и ще продължим индексацията на данните.
- В резултат на това, ще наблюдаваме плавно намаляване на пропускната способност на клъстера за запис и четене, но в целом всичко ще работи, макар и бавно, но стабилно.
Както се оказа, искахме нещо такова:
А получихме следното:
Как така се случи?
В момента на падането на дата-центъра, на нас ни стана тясно с майстора.
Защо?
Фактът е, че в майстора има TaskBatcher, който отговаря за разпространението в клъстера на определени задачи и събития. Всеки изход на нода, всяко повишаване на шард от replica в primary, всяка задача за създаване на някакъв шард — всичко това попада първо в TaskBatcher, където се обработва последователно и в един поток.
В момента на извеждане на един дата-център, всички дата-ноди в оцелелите дата-центрове смятаха за свой дълг да уведомят майстора 'ние загубихме такива шардове и такива дата-ноди'.
В същото време оцелелите дата-ноди изпращаха цялата тази информация на текущия майстор и се опитваха да изчакат потвърждение, че той я е приел. Те не получиха това потвърждение, тъй като майсторът получаваше задачите по-бързо, отколкото успяваше да отговори. Нодовете повтаряха заявките по таймаут, а майсторът по това време вече дори не се опитваше да отговаря на тях, а бе напълно погълнат от задачата за сортиране на заявките по приоритет.
В терминалния вариант получаваше се, че дата-ноди спамят майстора до такава степен, че той преминаваше в full GC. След това ролята на майстора преминаваше на някакъв следващ нод, с него се случваше абсолютно същото и в крайна сметка клъстърът се разпадаше напълно.
Правихме измервания и до версия 6.4.0, където това беше поправено, ни беше достатъчно да извеждаме едновременно само 10 дата-нода от 360, за да разпаднем напълно клъстъра.
Изглеждаше това приблизително така:
След версия 6.4.0, където поправиха този ужасен баг, дата-нодите спряха да убиват майстора. Но той не стана 'по-умен' от това. А именно: когато извеждаме 2, 3 или 10 (всяко количество, различно от единица) дата-ноди, майсторът получава някакво първо съобщение, което казва, че нода А е излязла и се опитва да разкаже за това на нода B, нода C, нода D.
В момента единственият начин да се справим с това е чрез задаване на таймаут от 20-30 секунди за опити да се разкаже на някого нещо, и по този начин да управляваме скоростта на извеждане на дата центъра от клъстера.
В принципе, това отговаря на изискванията, които първоначално бяха поставени към крайния продукт в рамките на проекта, но от гледна точка на 'чистата наука' това е бъг. Който, между другото, беше успешно поправен от разработчиците в версия 7.2.
Фактически, когато някой дата-нод излезеше, се оказваше, че е по-важно да се разпространи информация за неговото излизане, отколкото да се информира целият клъстер, че на него са се намирали определени primary-shards (за да се промотира replica-shard в друг дата център в primary, и да е възможно записването на информация).
Следователно, когато всичко е 'отшумяло', излезлите дата-нодове не се маркират незабавно като stale. Следователно, ние сме принудени да изчакаме, докато таймаутите на всички пинги до излезлите дата-нодове се изтекат, и едва след това нашият клъстер започва да разказва за това, че тук-там и там-там трябва да продължи записването на информация. Можете да прочетете по-подробно за това .
В крайна сметка операцията по извеждане на дата центъра днес отнема около 5 минути в пиковите часове. За толкова голяма и тромава машина, това е доста добър резултат.
В крайна сметка стигнахме до следното решение:
- Имаме 360 дата-нодове с дискове от 700 гигабайта.
- 60 координатора за маршрутизиране на трафика между тези дата-нодове.
- 40 мастери, които бяха оставени като наследство от предишни версии до 6.4.0 — за да преживеем извеждането на дата центъра, бяхме морално готови да загубим няколко машини, за да гарантираме, че дори при най-лошия сценарий имаме кворум от мастери.
- Любите опити за комбиниране на роли на един контейнер се сблъскваха с факта, че рано или късно нодът се счупваше под натоварване.
- В целия клъстер се използва размер на heap.size, равен на 31 гигабайт: всички опити за намаляване на размера доведоха до това, че при тежки търсения с leading wildcard или умират някои нодове, или circuit breaker в самия Elasticsearch се задействаше.
- Освен това, за осигуряване на производителността на търсенето, се стремяхме да поддържаме минимално количество обекти в клъстера, за да обработваме възможно най-малко събития в най-тясната точка, която стигнахме в мастера.
Накрая, по отношение на мониторинга
За да функционира всичко така, както е предвидено, следим за следното:
- Всяка дата-нода докладва в нашето облако, че съществува и на нея са разположени определени шардове. Когато изключваме нещо, кластерът след 2-3 секунди докладва, че в център А сме изключили нода 2, 3 и 4 — това означава, че в други дата-центрове не можем по никакъв начин да изключваме тези ноди, на които остана по един шард.
- Знаейки характера на поведението на мастера, внимателно следим броя на pending-задачите. Защото дори една зависнала задача, ако не бъде изключена навреме, теоретично в някоя екстремна ситуация може да стане причината, поради която не може да се осъществи, например, промоцията на replica-шарда в primary, което ще спре индексацията.
- Също така много внимателно следим забавянията на garbage collector, тъй като вече сме имали сериозни проблеми с това при оптимизацията.
- Реджектите по тредовете, за да разберем предварително къде се намира 'бутилочното гърло'.
- И стандартните метрики, като heap, RAM и I/O.
При изграждането на мониторинг е задължително да се вземат предвид особеностите на Thread Pool в Elasticsearch. определя възможностите за настройки и подразбиращи се стойности за търсене и индексиране, но напълно премълчава за thread_pool.management. Тези тредове обработват, в частност, заявки от типа _cat/shards и други подобни, които е удобно да се използват при написването на мониторинг. Колкото по-голям е кластерът, толкова повече такива заявки се изпълняват за единица време, а споменатият thread_pool.management, освен че не е представен в официалната документация, е ограничен по подразбиране на 5 треда, което бързо се изчерпва, след което мониторингът спира да функционира правилно.
Скъпи колеги, искам да кажа в заключение: постигнахме го! Успяхме да предоставим на нашите програмисти и разработчици инструмент, който практически във всяка ситуация може бързо и надеждно да предостави информация за това, което се случва в продукцията.
Да, това беше доста сложно, но въпреки това успяхме да обединим нашите желания в вече съществуващи продукти, които не се наложи да модифицираме и преоправяме.
Източник: habr.com
