

Пакет tidyr е част от ядрото на една от най-популярните библиотеки на R — tidyverse.
Основната цел на пакета е да приведете данните в подреден вид.
В Хабър вече има посветена на този пакет, но е датирана от 2015 година. А аз искам да говоря за най-актуалните промени, за които преди няколко дни съобщи неговият автор Хадли Викъм.
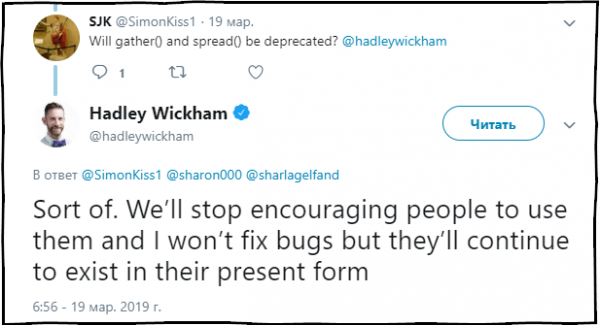
SJK: Функциите gather() и spread() ще бъдат смятани за остарели?
Hadley Wickham: До известна степен. Ще спрем да препоръчваме използването на тези функции и да поправяме грешките в тях, но те ще продължат да присъстват в пакета в текущото си състояние.
Съдържание
Ако се интересувате от анализ на данни, вероятно ще ви бъдат интересни моите и канали. По-голямата част от съдържанието е посветено на R.
Концепция TidyData
Цел tidyr — да ви помогне да приведете данните в т.нар. подреден вид. Подредените данни са данни, където:
- Всяка променлива е в колона.
- Всяко наблюдение е ред.
- Всяка стойност е клетка.
С данните, приведени в tidy data, е значително по-лесно и удобно да се работи при провеждане на анализ.
Основни функции в пакета tidyr
tidyr съдържа набор от функции, предназначени за трансформиране на таблици:
fill()— запълване на пропуснатите стойности в колона с предходните стойности;separate()— разделя едно поле на няколко чрез разделител;unite()— извършва операция по обединяване на няколко полета в едно, действие обратно на функциятаseparate();pivot_longer()— функция, преобразуваща данните от широк формат в дълъг;pivot_wider()— функция, преобразуваща данните от дълъг формат в широк. Операцията е обратна на тази, която извършва функцията.pivot_longer().gather()остаряла — функция, преобразуваща данните от широк формат в дълъг;spread()остаряла — функция, преобразуваща данните от дълъг формат в широк. Операцията е обратна на тази, която извършва функцията.gather().
Нова концепция за преобразуване на данни от широк формат в дълъг и обратно
По-рано за подобен вид трансформации се използваха функции gather() и spread(). През годините, в които съществуваха тези функции, стана очевидно, че за повечето потребители, включително автора на пакета, имената на тези функции и техните аргументи не бяха достатъчно ясни и предизвикваха затруднения при тяхното търсене и разбирането на коя от тези функции трансформира data frame от широк в дълъг формат и обратно.
В тази връзка tidyr бяха добавени две нови, важни функции, които са предназначени за трансформация на data frames.
Нови функции pivot_longer() и pivot_wider() бяха създадени под влияние на някои функции от пакета cdata, създаден от Джон Маунт и Нина Зумел.
Инсталиране на най-актуалната версия на tidyr 0.8.3.9000
За инсталиране на новата, най-актуална версия на пакета tidyr 0.8.3.9000, в която са налични новите функции, използвайте следния код.
devtools::install_github("tidyverse/tidyr")
Към момента на написване на статията тези функции са налични само в dev версията на пакета на GitHub.
Преминаване към новите функции
Всъщност, да се трансформират старите скриптове за работа с новите функции не е трудно, за по-добро разбиране ще взема пример от документацията на старите функции и ще покажа как се извършват същите операции с новите pivot_*() функции.
Преобразуване от широк формат в дълъг.
Пример код от документацията на функцията gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Преобразуване от дълъг формат в широк.
Пример код от документацията на функцията spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Тъй като в приведените по-горе примери работа с pivot_longer() и pivot_wider(), в изходната таблица склади няма колони, изброени в аргументите names_to и values_to техните имена трябва да се посочват в кавички.
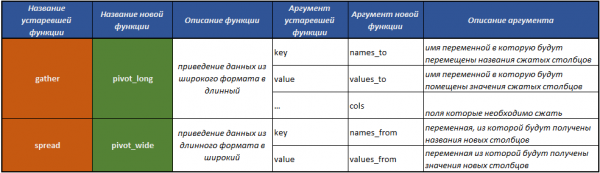
Таблица, с помощта на която ще ви е най-лесно да разберете как да преминете на работа с новата концепция tidyr.
Забележка от автора
Целият представен по-долу текст е адаптивен, бих казал свободен превод от официалния сайт на библиотеката tidyverse.
Просто пример за преобразуване на данни от широк формат в дълъг
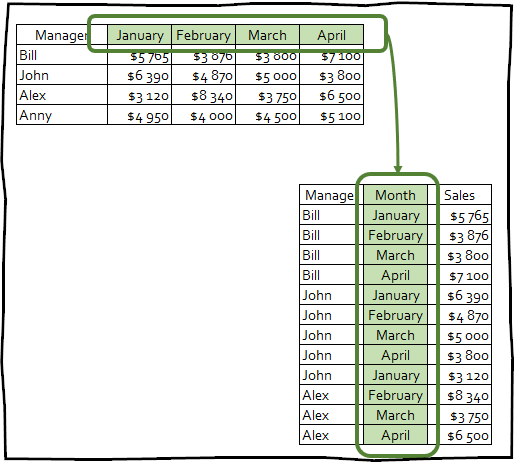
pivot_longer () — прави наборите от данни по-дълги, намалявайки броя на колоните и увеличавайки броя на редовете.
За изпълнение на примерите, представени в статията, първо е необходимо да се заредят нужните пакети:
library(tidyr)
library(dplyr)
library(readr)
Да предположим, че имаме таблица с резултатите от анкета, в която (сред другото) питаха хората за тяхната религия и годишен доход:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Тази таблица съдържа данни за религията на респондентите в редовете, а нивото на дохода е разпределено по имената на колоните. Броят на респондентите от всяка категория е записан в стойностите на клетките на пресечението на религията и нивото на дохода. За да приведете таблицата в спретнат и правилен формат, достатъчно е да използвате pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # A tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostic 2 Agnostic $10-20k 34
#> 3 Agnostic $20-30k 60
#> 4 Agnostic $30-40k 81
#> 5 Agnostic $40-50k 76
#> 6 Agnostic $50-75k 137
#> 7 Agnostic $75-100k 122
#> 8 Agnostic $100-150k 109
#> 9 Agnostic >150k 84
#> 10 Agnostic Don't know/refused 96
#> # … с 170 още редаАргументите на функцията pivot_longer()
- Първият аргумент cols, описва кои колони трябва да бъдат обединени. В този случай всички колони, с изключение на time.
- Аргумент names_to дава името на променливата, която ще бъде създадена от имената на колоните, които сме обединили.
- values_to дава името на променливата, която ще бъде създадена от данните, съдържащи се в стойностите на клетките на обединените колони.
Спецификации
Това е нова функционалност на пакета tidyr, която преди време при работа с остарели функции не беше налична.
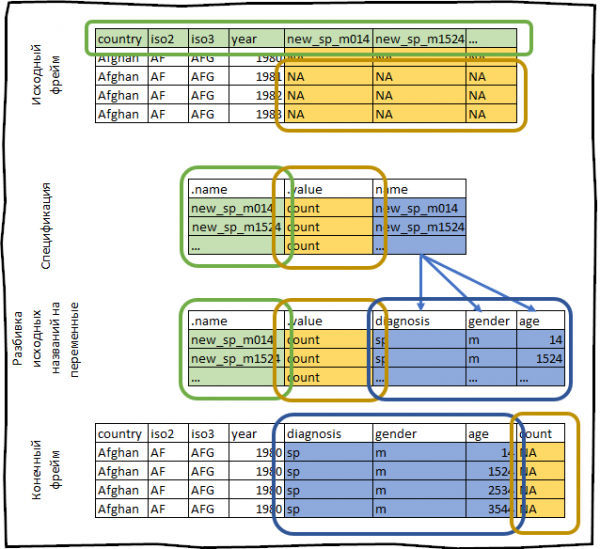
Спецификацията е дата фрейм, всеки ред от който съответства на една колона в новия изходящ дата фрейм, и с две специални колони, които започват с:
- .name съдържа оригиналното наименование на колоната.
- .value съдържа името на колоната, в която ще влизат стойностите на клетките.
Останалите колони на спецификацията отразяват начина, по който в новата колона ще се изведе името на обединените колони от .name.
Спецификацията описва метаданните, съхранявани в името на колоната, с един ред за всяка колона и една колона за всяка променлива, обединена с името на колоната. Сигурно сега това определение изглежда объркващо, но след разглеждане на няколко примера всичко ще стане значително по-ясно.
Смисълът на спецификацията е, че можете да извличате, променяте и задавате нови метаданни на преобразувания датафрейм.
За работа със спецификациите при преобразуване на таблицата от широк формат в дълъг служи функцията pivot_longer_spec().
Как работи тази функция, тя взема произволен датафрейм и формира неговите метаданни по описания по-горе начин.
За пример нека да вземем набора данни who, предоставен с пакета tidyr. Този набор данни съдържа информация, предоставена от международната организация на здравеопазването за заболяването туберкулоза.
who
#># A tibble: 7,240 x 60
#>#    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>#        & &
#>#  1 Afghan… AF    AFG    1980          NA           NA           NA
#>#  2 Afghan… AF    AFG    1981          NA           NA           NA
#>#  3 Afghan… AF    AFG    1982          NA           NA           NA
#>#  4 Afghan… AF    AFG    1983          NA           NA           NA
#>#  5 Afghan… AF    AFG    1984          NA           NA           NA
#>#  6 Afghan… AF    AFG    1985          NA           NA           NA
#>#  7 Afghan… AF    AFG    1986          NA           NA           NA
#>#  8 Afghan… AF    AFG    1987          NA           NA           NA
#>#  9 Afghan… AF    AFG    1988          NA           NA           NA
#># 10 Afghan… AF    AFG    1989          NA           NA           NA
#># # … с още 7,230 реда и 53 допълнителни променливи
Нека изградим спецификацията.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsПолета country, iso2, iso3 вече са променливи. Нашата задача е да обърнем колоните с new_sp_m014 по newrel_f65.
В имената на тези колони се съхранява следната информация:
- Префикс
new_означава, че колоната съдържа данни за нови случаи на заболяване с туберкулоза, настоящият дата фрейм съдържа информация само за нови заболявания, така че този префикс в текущия контекст не носи никкакъв смислов товар. sp/rel/sp/epописва начина на диагностика на заболяването.m/fпол на пациента.014/1524/2535/3544/4554/65възрастов диапазон на пациента.
Можем да разделим тези колони с помощта на функцията extract(), използвайки регулярни изрази.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsОбърнете внимание, колоната .name трябва да остане непроменена, тъй като това е нашият индекс в имената на колоните на оригиналния набор данни.
Полът и възрастта (колоните gender и age) имат фиксирани и известни стойности, затова е препоръчително да преобразуваме тези колони в фактори:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Накрая, за да приложим създадената от нас спецификация към оригиналния дата фрейм who ни е необходимо да използваме аргумента spec в функция pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
Всичко, което току-що направихме, може да бъде визуализирано по следния начин:
Спецификация с използване на няколко стойности (.value)
В приведения по-горе пример колоната на спецификацията .value съдържаше само едно значение, в повечето случаи е така.
Но понякога може да се появи ситуация, когато трябва да съберете данни от колони с различни типове данни. С помощта на остаряла функция spread() щеше да бъде доста трудно да се направи.
Примерът по-долу е заимстван от пакета data.table.
Нека създадем тренировъчен датафрейм.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Създаденият датафрейм в всяка редица съдържа данни за децата на едно семейство. В семействата може да има едно или две деца. За всяко дете се предоставя информация за датата на раждане и пола, като данните за всяко дете са в отделни колони, нашата задача е да приведем тези данни в подходящ формат за анализ.
Обърнете внимание, че имаме две променливи с информация за всяко дете: неговия пол и дата на раждане (колоните с префикс dob съдържат датата на раждане, колоните с префикс gender съдържат пола на детето). В очаквания резултат те трябва да са в отделни колони. Можем да направим това, генерирайки спецификация, в която колоната .value ще има две различни стойности.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
И така, нека разгледаме стъпка по стъпка действията, които се изпълняват от горния код.
pivot_longer_spec(-family)— създаваме спецификация, която сгъва всички налични колони, освен колоната family.separate(col = name, into = c(".value", "child"))— разделяме колоната .name, която съдържа имената на оригиналните полета, по долна черта и записваме получените стойности в колоните .value и child.mutate(child = parse_number(child))— преобразуваме стойностите на полето child от текстов тип в числов тип.
Сега можем да приложим получената спецификация към оригиналния датафрейм и да приведем таблицата в желан вид.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Използваме аргумента na.rm = TRUE, тъй като текущата форма на данните задължава да се създават излишни редове за несъществуващи наблюдения. Тъй като семейството 2 има само едно дете, na.rm = TRUE гарантира, че семейството 2 ще има един ред в изходните данни.
Преобразуване на дата фреймове от дълъг в широк формат
pivot_wider() — е обратна трансформация и обратното увеличава броя на колоните на датафрейма за сметка на намаляване на броя на редовете.
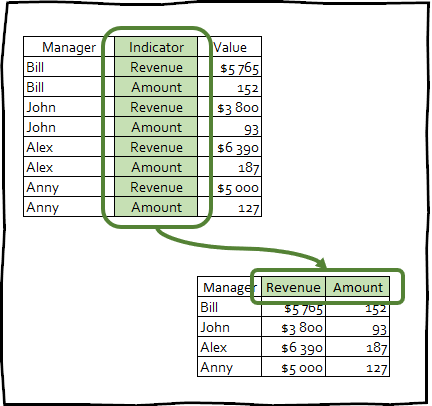
Този вид преобразуване рядко се използва за подреждане на данни, обаче този метод може да бъде полезен за създаване на сводни таблици, които се използват в презентации или за интеграция с други инструменти.
Всъщност функциите pivot_longer() и pivot_wider() са симетрични и извършват обратни действия помежду си, т.е: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) и df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) ще върне оригиналния df.
Най-простият пример за преобразуване на таблица в широк формат
За демонстрация на работата на функцията pivot_wider() ще използваме набор от данни fish_encounters, който съдържа информация за това как различни станции регистрират движението на рибите по реката.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
В повечето случаи тази таблица ще бъде по-информативна и удобна за използване, ако представим информацията за всяка станция в отделна колона.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  # … с още 9 реда и 1 променлива: MAW
Този набор от данни записва информация само в случаите, когато рибата е била открита от станцията, т.е. ако някоя риба не е била регистрирана от дадена станция, няма да има данни в таблицата. Това означава, че изходните данни ще бъдат запълнени с NA.
Обаче в този случай знаем, че отсъствието на запис означава, че рибата не е била забелязана, така че можем да използваме аргумента values_fill в функция pivot_wider() и да запълним тези пропуснати стойности с нули:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Генерация на името на колоната от няколко изходни променливи
Представете си, че имаме таблица, съдържаща комбинация от продукт, страна и година. За генериране на тестов дата фрейм може да се използва следният код:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsНашата задача е да разширим дата фрейма така, че един стълб да съдържа данни за всяка комбинация от продукт и страна. За това е достатъчно да предадем в аргумента names_from вектор, съдържащ имената на комбинираните полета.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsВие също можете да прилагате спецификации към функцията pivot_wider(). Но при подаване в pivot_wider() спецификацията извършва преобразуване, противоположно на pivot_longer(): създават се стълбци, посочени в .name, използвайки стойностите от .value и други стълбци.
За този набор от данни можете да генерирате потребителска спецификация, ако искате всяка възможна комбинация от страна и продукт да има собствен стълб, а не само тези, които присъстват в данните:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Няколко напреднали примера за работа с новата концепция на tidyr
Придаване на данни в подреден вид на примера на набор от данни за данъчни доходи и наем в САЩ
Наборът от данни us_rent_income съдържа информация за средния доход и наем за всеки щат в САЩ за 2017 година (наборът от данни е наличен в пакета tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … с 94 повече реда
В сегашния вид, в който са съхранявани данните в датасета, работата с тях е изключително неудобна, затова бихме искали да създадем набор от данни със стълбове: us_rent_income rent rent_moe, come, income_moe, . Съществуват множество начини за създаване на тази спецификация, но основното е, че трябва да генерираме всяка комбинация от стойности на променливата иestimate/moe , а след това да генерираме името на стълба.spec % expand(variable, .value = c("estimate", "moe")) %>% mutate( .name = paste0(variable, ifelse(.value == "moe", "_moe", "")) )
Предоставянето на тази спецификация#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeдава резултата, който търсим: pivot_wider() us_rent_income %>% pivot_wider(spec = spec)
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Световна банка
Понякога преобразуването на набора от данни в необходимата форма изисква няколко стъпки.
Набор от данни world_bank_pop съдържа данни на световната банка за населението на всяка страна в периода от 2000 до 2018 година.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Нашата цел е да създадем подреден набор от данни, където всяка променлива е в отделна колона. Все още не е ясно кои стъпки са необходими, но ще започнем с най-очевидния проблем: годината е разпределена в няколко колони.
За да коригираме това, е необходимо да използваме функцията pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsСледващата стъпка е да разгледаме променливата indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Където SP.POP.GROW е растежът на населението, SP.POP.TOTL е общото население, а SP.URB. * е същото, но само за градската среда. Нека разделим тези стойности на две променливи: area — местност (обща или градска) и променлива, съдържаща действителните данни (население или растеж):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsСега ни остава само да разделим променливата variable на две колони:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsСписък с контакти
Последният пример, представете си, че имате списък с контакти, който сте копирали и поставили от уебсайт:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Преобразуването на този списък в табличен вид е доста сложно, тъй като няма променлива, която да идентифицира кои данни принадлежат на кой контакт. Можем да го поправим, като забележим, че данните за всеки нов контакт започват с име ("name"), затова можем да създадем уникален идентификатор и да увеличаваме с единица всеки път, когато в колоната field се среща стойността “name”:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Сега, когато имаме уникален идентификатор за всеки контакт, можем да завъртим полето и стойността в колони:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Заключение
Лично моето мнение е, че новата концепция tidyr в действителност е много по-интуитивна и значително превъзхожда старите функции spread() и gather(). Надявам се статията да ви е помогнала да разберете pivot_longer() и pivot_wider().
Източник: habr.com
