

Здравейте на всички, аз съм Александър и съм инженер по качество на данните, който се занимава с проверка на данните за тяхното качество. В тази статия ще говоря за това как стигнах до тук и защо през 2020 година това направление на тестването се оказа на върха.
Глобална тенденция
Днешният свят преживява поредна технологична революция, един от аспектите на която е използването на събраните данни от различни компании за популяризиране на собствените им продажби, печалби и реклама. Изглежда, че наличието на качествени данни, както и на умели специалисти, които могат да ги преобразуват в пари (правилно да ги обработват, визуализират, изграждат модели на машинно обучение и т.н.), стана ключът към успеха за много от тях. Ако преди 15-20 години усилената работа с натрупването на данни и тяхната монетизация беше в основата на големите компании, то днес това е характерно за почти всички разумни играчи.
Във връзка с това преди няколко години всички платформи за търсене на работа по целия свят започнаха да преливат от обяви за позиции за Data Scientists, тъй като всички бяха убедени, че с наемането на такъв специалист може да се построи супермодел на машинно обучение, да се прогнозира бъдещето и да се извърши "квантов скок" за компанията. С времето хората осъзнаха, че този подход не работи почти никъде, тъй като далеч не всички данни, които попада в ръцете на такива специалисти, са подходящи за обучение на модели.
И започнаха запитвания от Data Scientists: «Да купим още данни от тези и онези...», «Липсват ни данни...», «Трябва ни още малко данни и задължително качествени...». На базата на тези запитвания се изградиха многобройни взаимодействия между компаниите, притежаващи определени набори данни. Естествено, това изискваше техническа организация на процеса — свързване с източника на данни, извличане им, проверка, че те са заредени в пълния обем и т.н. Броят на такива процеси започна да нараства, и в днешно време имаме огромна нужда от друг тип специалисти — Data Quality инженери — тези, които следят потока на данни в системата (data pipelines), за качеството на данните на входа и на изхода, правят изводи относно тяхната достатъчност, целостност и други характеристики.
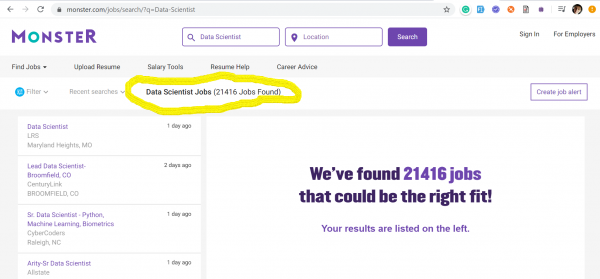
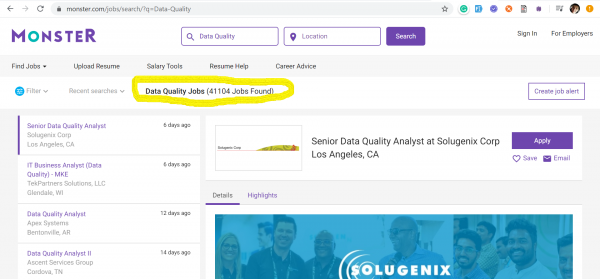
Трендът на Data Quality инженери дойде при нас от САЩ, където в разгара на бушуващата ера на капитализма никой не е готов да загуби битката за данни. По-долу представям скрийншотове от два от най-популярните сайтове за работа в САЩ: и — на които са показани данни към 17 март 2020 година за броя на публикуваните обяви, получени по ключови думи: Data Quality и Data Scientist.
Data Scientists – 21416 обяви
Data Quality – 41104 обяви
Data Scientists – 404 обяви
Data Quality – 2020 обяви
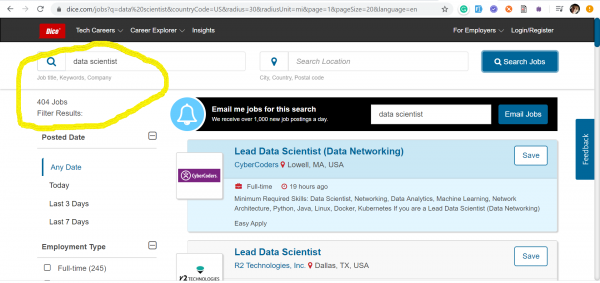
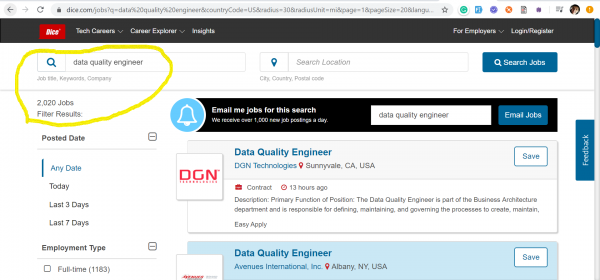
Очевидно е, че тези професии по никакъв начин не си конкурират помежду си. Скрийншотовете просто илюстрират текущата ситуация на пазара на труда в отношение на запитванията за Data Quality инженери, които сега се изискват много повече, отколкото Data Scientists.
През юни 2019 година EPAM, реагирайки на нуждите на съвременния ИТ пазар, извади Data Quality направление в отделна практика. Data Quality инженери в хода на ежедневната си работа управляват данни, проверяват тяхното поведение в нови условия и системи, контролират релевантността на данните, тяхната достатъчност и актуалност. Въпреки всичко, в практическо отношение Data Quality инженери наистина отделят малко време за класическото функционално тестване, НО това силно зависи от проекта (пример ще дам по-късно).
Задълженията на инженера по качество на данните не се ограничават само до рутинни ръчни/автоматизирани проверки за «nulls, count и sums» в таблиците на базата данни, а изискват дълбоко разбиране на бизнес нуждите на клиента и, съответно, способността да трансформират наличните данни в полезна бизнес информация.
Теория на качеството на данните
За да се представим по-пълно ролята на такъв инженер, нека да разберем какво е качеството на данните в теорията.
Качество на данните — един от етапите на управление на данните (цяло поле, което ще оставим за ваше самостоятелно изучаване) и отговаря за анализа на данните по следните критерии:
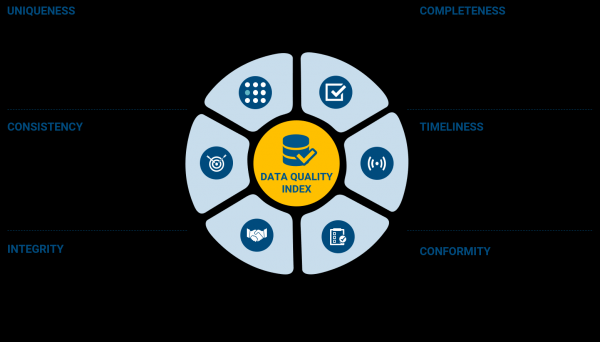
Мисля, че не е необходимо да разглеждаме всеки от пунктовете (в теорията наричани «data dimensions»), те са доста добре описани на изображението. Но самият процес на тестване не предполага строго копиране на тези характеристики в тест-кейсове и тяхната проверка. В качеството на данните, както и в всяка друга форма на тестване, трябва преди всичко да се ръководим от изискванията за качество на данните, съгласувани с участниците в проекта, вземащи бизнес решения.
В зависимост от проекта, инженерът по качество на данните може да изпълнява различни функции: от обикновен автоматизатор на тестове с повърхностна оценка на качеството на данните, до човек, провеждащ дълбоко профилиране по горепосочените характеристики.
Много подробно описание на процесите на управление на данните, качеството на данните и свързаните теми е представено в книгата с название «DAMA-DMBOK: Удостоверение за управление на данните: 2-ро издание». Препоръчвам тази книга като въведение в темата (линкът към нея ще намерите в края на статията).
Моята история
В ИТ индустрията преминах пътя от Junior тестировчик в продуктовите компании до Lead Data Quality Engineer в компанията EPAM. Вече около две години работа като тестировчик имах твърдото убеждение, че правя абсолютно всички видове тестване: регресионно, функционално, стресово, стабилност, сигурност, UI и т.н. — и изпробвах множество инструменти за тестване, работейки на три програмни езика: Java, Scala, Python.
Оглеждайки се назад, разбирам защо наборът на професионалните ми умения се оказа толкова разнообразен – участвах в проекти, свързани с работа с данни, големи и малки. Именно това ме доведе до света на многото инструменти и възможности за растеж.
За да оцените разнообразието от инструменти и възможности за придобиване на нови знания и умения, е достатъчно просто да погледнете изображението по-долу, което показва най-популярните от тях в света на «Data & AI».
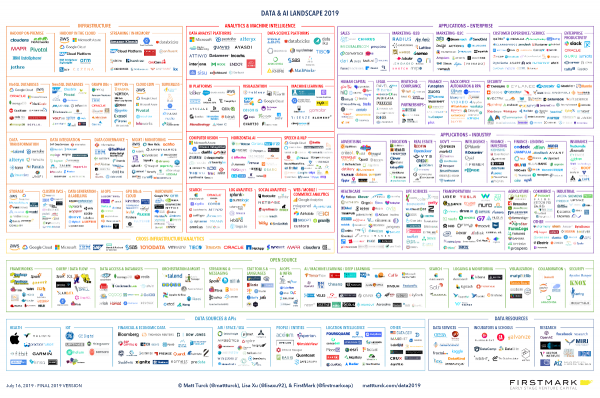
Такъв тип илюстрации ежегодно съставя един от известните венчурни капиталисти Mat Turck, който идва от разработката на софтуер. Ето на неговия блог и , където той работи като партньор.
Особено бързо професионално израствах, когато бях единственият тестер в проекта, или поне в началото на проекта. Именно в такъв момент трябва да отговаряш за целия процес на тестване и нямаш възможност да отстъпиш, само напред. Поначало това ме плаши, но сега ми е очевидно какви са плюсовете на такова предизвикателство:
- Започваш да общуваш с целия екип както никога преди, тъй като няма никакъв прокси за комуникация: нито тест-мениджър, нито колеги тестери.
- Потапянето в проекта става изключително дълбоко и ти владееш информацията за всички компоненти както общо, така и в подробности.
- Разработчиците не те гледат като «онзи момък от тестването, който не е ясно с какво се занимава», а по-скоро като на равен, който носи невероятна полза за екипа със своите автотестове и предвиждането на появата на бъгове в конкретен елемент на продукта.
- В резултат – ти си по-ефективен, по-квалифициран, по-търсен.
С развитием проекта станах наставником для новых тестировщиков, обучая их и делясь знаниями, которые сам приобрёл. В зависимости от проекта, я не всегда получал специалистов по автоматизированному тестированию самого высокого уровня, и было необходимо либо обучать их автоматизации (для желающих), либо создавать инструменты для их повседневной работы (инструменты генерации данных и их загрузки в систему, инструмент для быстрого нагрузочного тестирования и т.п.).
Пример конкретен проект
Увы, из-за обязательств о неразглашении не могу подробно рассказывать о проектах, на которых работал, однако приведу примеры типичных задач Data Quality Engineer на одном из проектов.
Суть проекта заключалась в реализации платформы для подготовки данных для обучения моделей машинного обучения. Заказчиком была крупная фармацевтическая компания из США. Технически это был кластер , который разворачивался на инстансах, с несколькими микросервисами и основанным на Open Source проектом компании EPAM — , адаптированным под нужды конкретного заказчика (в настоящее время проект перерожден в ). ETL-процессы были организованы с помощью и перемещали данные из системы заказчика в Buckets. Далее на платформу деплоился докер образ модели машинного обучения, которая обучалась на свежих данных и по REST API интерфейсу выдавала предсказания, интересующие бизнес и решающие конкретные задачи.
Визуально всё выглядело примерно так:
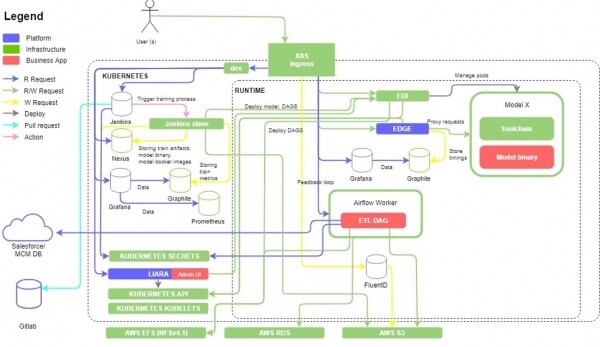
На этом проекте было много функционального тестирования, и учитывая скорость разработки фич и необходимость поддержания темпов релизного цикла (двухнедельные спринты), было важно сразу задумываться об автоматизации тестирования самых критичных узлов системы. Основная часть платформы, основанной на Kubernetes, была покрыта автотестами, реализованными на + Python, но също така беше необходимо да се поддържат и разширяват. Освен това, за удобство на клиента, беше създаден графичен интерфейс за управление на моделите на машинно обучение, разположени на кластера, както и възможност да се укаже откъде и накъде трябва да се преместят данните за обучение на моделите. Това широко допълнение наложи разширение на автоматизираните функционални проверки, които по-голямата част се извършваха чрез REST API извиквания и малко на брой end-2-end UI тестове. Около средата на цялото това движение към нас се присъедини ръчен тестировчик, който отлично се справяше с приемането на версиите на продукта и общуването с клиента относно приемането на следващия релиз. Освен това, благодарение на появата на новия специалист, успяхме да документираме нашата работа и да добавим няколко много важни ръчни проверки, които беше трудно веднага да автоматизираме.
И накрая, след като постигнахме стабилност на платформата и графичния интерфейс над нея, започнахме изграждането на ETL потоци с помощта на Apache Airflow DAGs. Автоматизираната проверка на качеството на данните се осъществяваше чрез написване на специални Airflow DAGs, които проверяваха данните въз основа на резултатите от ETL процеса. В рамките на този проект имахме късмет и клиентът ни предостави достъп до анонимизирани набори от данни, върху които провеждахме тестовете. Проверявахме данните ред по ред за съответствие на типовете, наличие на повредени данни, общия брой записи преди и след, сравнение на преобразованията, извършвани от ETL процеса по агрегация, промяна на имената на колоните и други. Освен това, тези проверки бяха мащабирани за различни източници на данни, например освен SalesForce, също и на MySQL.
Проверки на крайното качество на данните се извършваха вече на ниво S3, където те се съхраняваха и бяха в състояние ready-to-use за обучение на моделите на машинното обучение. За извличане на данните от крайния CSV файл, съхраняван в S3 Bucket и тяхната валидация, беше написан код с помощта на .
Също така имаше изискване от страна на клиента за съхранение на част от данните в един S3 Bucket, а част в друг. За това също беше необходимо да се пишат допълнителни проверки, контролиращи достоверността на такова сортиране.
Обобщен опит от други проекти
Пример на най-общия списък с дейности на инженера по качество на данните:
- Подгответе тестови данни (валидни, невалидни, големи, малки) чрез автоматизиран инструмент.
- Заредете подготвения набор от данни в източника и проверете готовността му за използване.
- Стартирайте ETL процесите за обработка на набора от данни от изходното хранилище в окончателното или междинно с прилагане на определен набор от настройки (в случай, че е възможно задаването на конфигурируеми параметри за ETL задачата).
- Верифицирайте обработените данни от ETL процеса по отношение на тяхното качество и съответствие с бизнес изискванията.
Основният акцент на проверките трябва да бъде не само върху това дали потокът от данни в системата е проработил и е стигнал до края (което е част от функционалното тестване), а най-вече върху проверката и валидацията на данните относно съответствието с очакваните изисквания, откритие на аномалии и др.
Инструменти
Една от техниките за контрол на данните може да бъде организиране на верижни проверки на всяка стъпка от обработката на данните, така нареченият в литературата "data chain" — контрол на данните от източника до крайната точка на използване. Такъв вид проверки най-често се реализират чрез написване на проверяващи SQL заявки. Разбира се, че тези заявки трябва да бъдат максимално леки и да проверяват отделни парчета качество на данните (метаданни на таблици, празни редове, NULL стойности, грешки в синтаксиса — други изисквани проверки на атрибути).
В случай на регресивно тестване, в което се използват вече готови (незначително променящи се) набори от данни, в кода на автотестовете могат да бъдат съхранени готови шаблони за проверка на данни за съответствие с качеството (описания на очакваните метаданни на таблиците; редови изборни обекти, които могат да бъдат случайно избирани по време на теста и др.).
Също така, по време на тестването се налага да пишете тестови ETL процеси, с помощта на такива фреймворкове като Apache Airflow, или напълно black-box облачен инструмент, като , и др. Това обстоятелство принуждава тест-инженера да се запознае с принципите на работа на посочените по-горе инструменти и още по-ефективно както да провежда функционално тестване (например, на съществуващите в проекта ETL процеси), така и да ги използва за проверка на данни. В частност, за Apache Airflow вече съществуват готови оператори за работа с популярни аналитични бази данни, например . Най-базовият пример за неговото използване вече е изложен , затова няма да се повтарям.
Освен готовите решения, никой не забранява да реализирате свои техники и инструменти. Това не само ще е полезно за проекта, но и за самия Data Quality Engineer, който по този начин ще развие техническия си хоризонт и уменията си за програмиране.
Как работи това на реален проект
Добра илюстрация на последните абзаци относно "data chain", ETL и ubiquitous проверки е следният процес от един от реалните проекти:
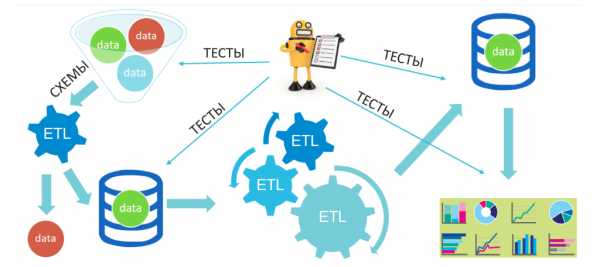
Тук в входната "фunnel" на нашата система постъпват различни данни (естествено, подготвени от нас): валидни, невалидни, смесени и т.н., след което те се филтрират и стигат до междинно хранилище, след това ги очаква редица преобразования и помещаване в окончателно хранилище, от което, от своя страна, ще се извършва аналитика, изграждане на data marts и търсене на бизнес инсайти. В такава система ние, без да проверяваме функционално работата на ETL процесите, се фокусираме върху качеството на данните преди и след преобразованията, както и на изхода в аналитика.
Резюмирайки горното, независимо от местата, където съм работил, навсякъде бях ангажиран в Data проекти, които обединяваха следните черти:
- Само чрез автоматизация можем да проверим определени случаи и да постигнем приемлив за бизнеса релизен цикъл.
- Тестировчикът на такъв проект е един от най-уважаваните членове на екипа, тъй като носи огромна полза на всеки от участниците (ускорение на тестването, добри данни за Data Scientist, откриване на дефекти в ранните етапи).
- Няма значение дали работите на собствено оборудване или в облака — всички ресурси са абстрахирани в клъстер тип Hortonworks, Cloudera, Mesos, Kubernetes и т.н.
- Проектите се изграждат на микросервизен принцип, преобладават разпределени и паралелни изчисления.
Ще подчертая, че при тестиране в областта на качеството на данните, тестовият специалист прехвърля професионалния си фокус върху продукта и използваните инструменти.
Характерни особености на тестировката на качеството на данните
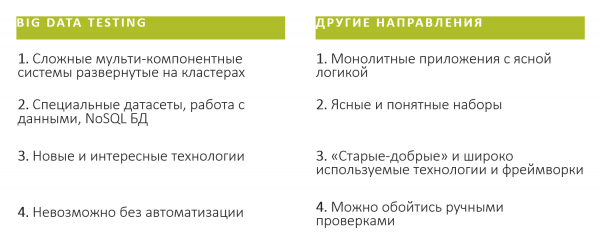
Освен това, за себе си съм изведел следните (веднага ще уточня, СИЛНО обобщени и изцяло субективни) отличителни черти на тестировката в проекти (системи) за данни (големи данни) и други области:
Полезни връзки
- Теория: .
- EPAM
- Препоръчителни материали за начинаещ Data Quality инженер:
- Безплатен курс на Stepik: .
- Курс на LinkedIn Learning: .
- Статии:
- ;
- ;
- ;
- Видео:
- ;
- ;
Заключение
Качество на данните — това е много млада и перспективна област, да бъдеш част от която означава да станеш част от някакъв стартап. Влиза в света на качеството на данните, вие ще се сблъскате с множество съвременни търсени технологии, но най-важното — пред вас ще се отворят огромни възможности за генериране и реализиране на вашите идеи. Ще можете да приложите подхода на постоянно подобрение не само в проекта, но и за себе си, непрекъснато развивайки се като специалист.
Източник: habr.com
