

Извеждането на новото издание на проекта в продукция изисква внимателно спазване на баланса между скоростта на разгръщане и надеждността на решението. В компанията Slack ценят бързите итерации, кратките цикли на обратна връзка и бързата реакция на запитвания от потребители. Освен това в компанията има стотици програмисти, които се стремят към максимална производителност.
Авторите на материала, чийто превод публикуваме днес, твърдят, че компания, която иска да следва подобни ценности и да расте, трябва постоянно да усъвършенства своята система за разгръщане на проекти. Компанията трябва да инвестира усилия в прозрачността и надеждността на работните процеси, за да се увери, че те отговарят на мащабите на проекта. Тук ще говорим за работните процеси, установени в Slack, и за някои решения, които накарали компанията да премине към съществуващата днес система за разгръщане на проекти.
Как работят процесите по разгръщане на проекти днес
Всеки PR (pull request) в Slack трябва задължително да бъде подложен на кодови прегледи и да премине успешно всички тестове. Само след като тези условия са изпълнени, програмистът може да слее кода си с главната клон на проекта. Въпреки това, разгръщането на такъв код се извършва само в работни часове по северноамериканско време. В резултат на това, благодарение на това, че служителите ни са на работните си места, сме напълно готови да реагираме на всякакви неочаквани проблеми.
Всеки ден извършваме около 12 планирани разгръщания. В процеса на всяко разгръщане, програмистът, назначен за отговорник по разгръщането, е отговорен за извеждането на новата версия в продукция. Това е многоетапен процес, който осигурява гладкото извеждане на версията в работен режим. Благодарение на този подход можем да открием грешки, преди да засегнат всички наши потребители. Ако грешките са твърде много, разгръщането може да бъде отменено. Ако пък конкретен проблем бъде открит след издаването, за него лесно може да бъде издадено поправка.
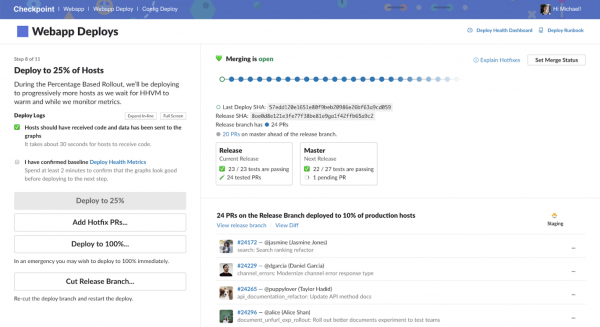
Интерфейсът на системата Checkpoint, която се използва в Slack за разгръщане на проекти
Процесът на разгръщане на ново издание в продукция може да бъде представен в четири стъпки.
▍1. Създаване на релийз клон
Всеки релийз започва с нов клон за релийз, в момента в нашата Git история. Това позволява да се назначават тагове на релийза и предоставя място за бързи корекции на грешки, открити по време на подготовката на релийза за пуск в продукция.
▍2. Разгръщане в тестова среда
Следващата стъпка в работата е разгръщането на сборката на тестовите (staging) сървъри и изпълнението на автоматичен тест за общата работоспособност на проекта (smoke test). Тестовата среда е продукционна среда, в която не навлиза външен трафик. В тази среда провеждаме допълнително ръчно тестване. Това ни дава допълнителна увереност, че измененото приложение работи правилно. Само автоматизирани тестове не са достатъчни за подобна увереност.
▍3. Разгръщане в dogfood и canary среди
Разгръщането в продукция започва с dogfood среда, представена от набор от хостове, които обслужват нашите вътрешни работни пространства в Slack. Тъй като сме много активни потребители на Slack, прилагането на този подход помогна да открием множество грешки на ранни етапи на разгръщане. След като се уверим, че основната функционалност на системата не е нарушена, се извършва разгръщане на сборката в canary среда. Тя представлява системи, на които минава около 2% от продукционния трафик.
▍4. Постепенно извеждане в продукция
Ако мониторинг показателите за новия релийз са стабилни и след разгръщането на проекта в canary среда не получаваме оплаквания, продължаваме с постепенното прехвърляне на продукционните сървъри на новия релийз. Процесът на разгръщане е разделен на следните етапи: 10%, 25%, 50%, 75% и 100%. В резултат можем бавно да предаваме продукционния трафик на новия релийз на системата. В същото време имаме време да проучим ситуацията в случай, че възникнат някакви аномалии.
▍Какво да правим, ако нещо се обърка по време на разгръщането?
Внасянето на модификации в кода винаги е риск. Но ние се справяме с това благодарение на наличието на добре подготвени "главни по разгръщането", които ръководят процеса на пускане на новата версия в продукция, наблюдават показателите за мониторинг и координират работата на програмистите, които пускат кода.
В случай че нещо наистина е тръгнало наопаки, ние се опитваме да открием проблема възможно най-рано. Изследваме проблема, намираме PR, който причинява грешки, откатваме го, внимателно анализираме и създаваме нова версия. Но понякога проблемът остава незабелязан до пускането на проекта в продукция. В такава ситуация най-важното е да възстановим работата на услугата. Затова, преди да започнем изследването на проблема, незабавно откатваме до предишната работеща версия.
Строителните блокове на системата за разгръщане
Нека разгледаме технологиите, които стоят зад нашата система за разгръщане на проекти.
▍Бързи разгръщания
По-горе описаният работен процес може да изглежда, с ретроспекция, като нещо съвсем очевидно. Но нашата система за разгръщане стана такава не веднага.
Когато компанията беше значително по-малка, всичкото наше приложение можеше да работи на 10 инстанса на Amazon EC2. Разгръщането на проект в такава ситуация означаваше използването на rsync за бърза синхронизация на всички сървъри. Преди новият код от продукцията отделяше само една стъпка, представена от междинната среда. Версиите се създаваха и проверяваха в такава среда, а след това веднага влизаха в продукция. Разборът на такава система беше много прост, тя позволяваше на всеки програмист по всяко време да разгръща написания от него код.
Но с нарастващия брой на нашите клиенти, растяха и мащабите на инфраструктурата, необходима за осигуряване на работата на проекта. Скоро, в контекста на постоянното разширяване на системата, нашата модел на разгръщане, основан на изпращането на нов код на сървърите, спря да изпълнява задачата си. Конкретно, добавянето на всеки нов сървър означаваше увеличаване на времето, необходимо за изпълнение на разгръщането. Дори стратегиите, основани на паралелното прилагане на rsync, имат определени ограничения.
В крайна сметка решихме този проблем, преминавайки на изцяло паралелна система за разгръщане, която е устроена по различен начин от старата система. А именно, сега не изпращахме кода към сървърите, използвайки скрипт за синхронизация. Всеки сървър самостоятелно зареждаше новата версия, като научаваше, че това е необходимо, благодарение на наблюдението на промяната на ключа Consul. Сървърите зареждаха кода паралелно. Това ни позволи да поддържаме висока скорост на разгръщане, дори в обстановка на постоянно нарастваща система.
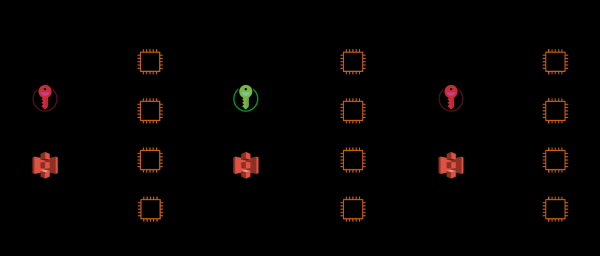
1. Продукционните сървъри наблюдават ключа Consul. 2. Ключът се променя, което уведомява сървърите, че трябва да започнат да зареждат новия код. 3. Сървърите зареждат tarball файлове с код на приложението.
▍Атомарни разгръщания
Още едно решение, което ни помогна да достигнем до многопластова система за разгръщане, стана атомарното разгръщане.
Преди да започнем да използваме атомарни разгръщания, всяко разгръщане можеше да доведе до появата на голямо количество съобщения за грешки. Фактът е, че процесът на копиране на новите файлове към продукционните сървъри не беше атомарен. Това водеше до съществуването на кратък времеви отрязък, когато кодът, в който бяха извикани нови функции, се оказваше достъпен преди самите тези функции да станат достъпни. Когато такъв код беше извикан, това водеше до връщане на вътрешни грешки. Това се проявяваше в неуспешни API заявки и в "разрушени" уеб страници.
Екипът, който се занимаваше с тази задача, я реши, въвеждайки понятието „горещи“ (hot) и „студени“ (cold) директории. Кодът в „горещата“ директория отговаря за обработката на продукционния трафик. А в „студените“ директории кодът по време на работа на системата само се приготвя за използване. По време на разгръщането новият код се копира в неизползваната „студена“ директория. След това, когато на сървъра няма активни процеси, се извършва мигновено превключване между директориите.
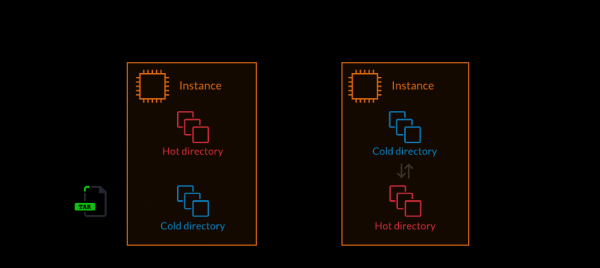
1. Разархивиране на кода на приложението в „студената“ директория. 2. Превключване на системата към „студената“ директория, която става „гореща“ (атомарна операция).
Резюме: преместване на акцента към надеждност.
През 2018 година проектът достигна такива обеми, че бързото внедряване започна да вреди на стабилността на продукта. Разполагахме с доста усъвършенствана система за внедряване, в която вложихме много усилия и време. Необходимо беше само да преорганизираме и усъвършенстваме процесите на внедряване. Станахме достатъчно голяма компания, чийто разработки се използват по целия свят за осигуряване на непрекъсната свързаност и решаване на важни задачи. Затова надеждността стана наш приоритет.
Необходимо беше да направим процеса на внедряване на новите версии на Slack по-сигурен. Тази необходимост ни доведе до усъвършенстването на нашата система за внедряване. Всъщност, по-горе обсъждахме именно тази усъвършенствана система. В дълбините на системата продължаваме да използваме технологии за бързо и атомарно внедряване. Променени са начините, по които се реализира внедряването. Нашата нова система е предназначена за постепенно внедряване на новия код на различни етапи и в различни среди. Сега използваме по-усъвършенствани, отколкото преди, помощни инструменти и средства за мониторинг на системата. Това ни позволява да улавяме и отстраняваме грешки много преди те да имат шанс да достигнат до крайния потребител.
Но не възнамеряваме да спираме дотук. Постоянно подобряваме тази система, използвайки по-усъвършенствани помощни инструменти и средства за автоматизация на работата.
Уважаеми читатели! Какъв е процесът на внедряване на новите версии на проектите там, където работите вие?
Източник: habr.com
