

В навечерието на старта на курса подготвихме за вас превод на още един полезен материал.
Кодирането на Хаффман е алгоритъм за компресия на данни, който формулира основната идея на компресията на файлове. В тази статия ще говорим за кодирането с фиксирана и променлива дължина, уникално декодируемите кодове, префиксните правила и изграждането на дърво Хаффман.
Знаем, че всеки символ се съхранява като последователност от 0 и 1 и заема 8 бита. Това се нарича кодирането с фиксирана дължина, тъй като всеки символ използва еднакво фиксирано количество битове за съхранение.
Да предположим, че имаме текст. Как можем да намалим количеството пространство, необходимо за съхранение на един символ?
Основната идея е в кодирането с променлива дължина. Можем да използваме факта, че някои символи в текста се срещат по-често от други (), за да разработим алгоритъм, който ще представя същата последователност от символи с по-малко битове. При кодирането с променлива дължина присвояваме на символите променливо количество битове в зависимост от честотата на тяхното появяване в дадения текст. В крайна сметка, някои символи могат да заемат само 1 бит, а други 2, 3 или повече. Проблемът с кодирането с променлива дължина е единствено в последващото декодиране на последователността.
Как, знаейки последователността от битове, да я декодираме еднозначно?
Нека разгледаме редицата «aabacdab». В нея има 8 символа и при кодирането с фиксирана дължина за съхранение ще са необходими 64 бита. Забележете, че честотата на символите «a», «b», «c» и «d» е 4, 2, 1, 1 съответно. Нека опитаме да представим «aabacdab» с по-малко битове, използвайки факта, че «a» се среща по-често от «b», а «b» се среща по-често от «c» и «d». Ще започнем с кодирането на «a» с един бит, равен на 0, «b» ние ще присвоим двубитов код 11, а с три бита 100 и 011 ще кодира «c» и «d».
В крайна сметка ще получим:
a
0
b
11
с
100
d
011
Така ще кодираме редицата «aabacdab» , използвайки кодовете, представени по-горе. Основният проблем обаче ще бъде в декодирането. Когато опитаме да декодираме редицата 00110100011011 (0|0|11|0|100|011|0|11), ще получим нееднозначен резултат, тъй като тя може да бъде представена като: 001101000110110|011|0|100|011|0|11 adacdab 0|0|11|0|100|0|11|011 aabacabd 0|011|0|100|0|11|0|11 adacabab
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
и т.н.
За да избегнем тази неяснота, трябва да гарантираме, че нашето кодиране отговаря на понятието правило за префикс, което от своя страна предполагава, че кодовете могат да бъдат декодирани само по един уникален начин. Правило за префикс гарантира, че никой код не е префикс на друг. Под код имаме предвид битовете, използвани за представяне на конкретен символ. В горния пример 0 – е префикс 011, което нарушава правилото за префикс. И така, ако нашите кодове отговарят на правилото за префикс, то декодирането може да се извърши еднозначно (и обратно).
Нека прегледаме горния пример. Този път ще зададем на символите «a», «b», «c» и «d» кодове, отговарящи на правилото за префикс.
a
0
b
10
с
110
d
111
С използване на такова кодиране, низът «aabacdab» ще бъде кодирано като 00100100011010 (0|0|10|0|100|011|0|10). А ето, че 00100100011010 вече можем да декодираме еднозначно и да се върнем към нашия изходен низ «aabacdab».
Кодиране на Хаффман
Сега, когато сме разбрали кодиране с променлива дължина и правило за префикс, нека поговорим за кодиране на Хаффман.
Методът се основава на създаването на двоични дървета. В него възелът може да бъде или крайния, или вътрешния. Първоначално всички възли се считат за листа (крайни), които представляват самия символ и неговото тегло (т.е. честотата на появата). Вътрешните възли съдържат тегло на символа и се отнасят към два наследника. По общо съгласие, битът "0" представлява следването по лявото клонче, а "1" — по дясното. В пълно дърво N листа и N-1 вътрешни възли. Препоръчително е при строенето на дървото на Хаффман да се отстраняват неизползваните символи, за да се получат кодове с оптимална дължина.
Ще използваме опашка с приоритети за построяване на дървото на Хаффман, където на възела с най-ниска честота ще бъде присъден най-висок приоритет. По-долу са описани стъпките за построяване:
- Създайте листов възел за всеки символ и ги добавете в опашката с приоритети.
- Докато в опашката има повече от един лист, правим следното:
- Премахнете два възела с най-висок приоритет (с най-ниска честота) от опашката;
- Създайте нов вътрешен възел, където тези два възела ще бъдат наследници, а честотата на появата ще бъде равна на сумата на честотите на тези два възела.
- Добавете новия възел в опашката с приоритети.
- Последният оставащ възел ще бъде коренов, с това изграждането на дървото приключва.
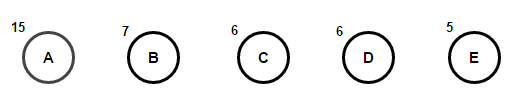
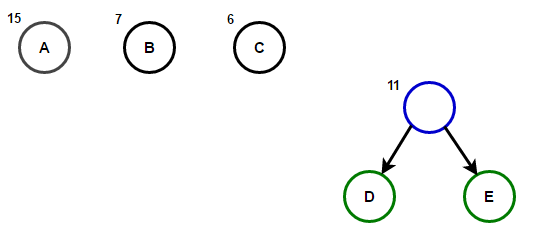
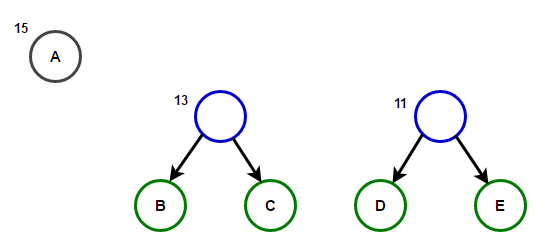
Представете си, че имаме текст, който се състои само от символите «a», «b», «c», «d» и «e», а честотите на тяхното появяване са 15, 7, 6, 6 и 5 съответно. По-долу са илюстрации, които отразяват стъпките на алгоритъма.
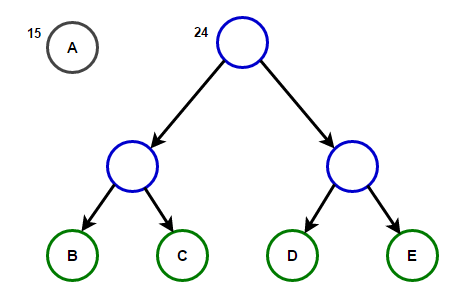
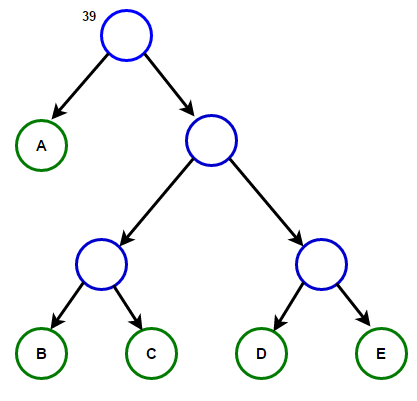
Пътят от корена до всеки крайния възел ще съхранява оптимален префиксен код (известен също като код на Хаффман), съответстващ на символа, свързан с този крайния възел.
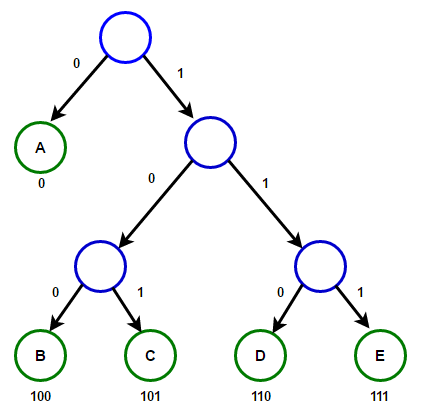
Дървото на Хаффман
По-долу ще намерите реализация на алгоритъма за компресия на Хаффман на езиците C++ и Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Възел на дърво
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// обхождане на дървото на Хафман и съхраняване на кодовете на Хафман
// в карта.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// намерен е листов възел
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// обхождане на дървото на Хафман и декодиране на кодираната низ
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// намерен е листов възел
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Изграждане на дървото на Хафман и код на Хафман и декодиране на подадения текст
public static void buildHuffmanTree(String text)
{
// преброяване на честотата на поява на всеки символ
// и съхраняването му в карта
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Създаване на приоритетна опашка за съхранение на живите възли на дървото на Хафман
// Обърнете внимание, че елементът с най-висок приоритет има най-ниска честота
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Създаване на листов възел за всеки символ и добавянето му
// в приоритетната опашка.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// правете, докато в опашката има повече от един възел
while (pq.size() != 1)
{
// Премахване на двата възела с най-висок приоритет
// (най-ниска честота) от опашката
Node left = pq.poll();
Node right = pq.poll();
// Създаване на нов вътрешен възел с тези два възела като деца
// и с честота, равна на сумата на честотите на двата възела.
// Добавяне на новия възел в приоритетната опашка.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root съхранява указател към корена на дървото на Хафман
Node root = pq.peek();
// обхождане на дървото на Хафман и съхраняване на кодовете на Хафман в карта
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// отпечатване на кодовете на Хафман
System.out.println("Кодовете на Хафман са :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nОригиналният низ беше :\n" + text);
// отпечатване на кодиран низ
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nКодиран с низ е :\n" + sb);
// отново обхождане на дървото на Хафман и този път
// декодиране на кодираната низ
int index = -1;
System.out.println("\nДекодираният низ е: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Кодирането на Хафман е алгоритъм за компресия на данни.";
buildHuffmanTree(text);
}
}Бележка: Паметта, използвана от входната линия, е 47 * 8 = 376 бит, а кодираната линия заема само 194 бита, т.е. данните се компресират с около 48%. В програмата на C++ по-горе използваме класа string за съхраняване на кодираната линия, за да направим програмата четима.
Тъй като ефективните структури от данни за приоритетни опашки изискват O(log(N)) време за вмъкване, а в пълно двоично дърво с N листата има 2N-1 възли, и дървото на Хаффман е пълно двоично дърво, следователно алгоритъмът работи за O(Nlog(N)) време, където N е броят на символите.
Източници:
Източник: habr.com
