

Продължавайки темата за записването на големи потоци от данни, повдигната , тук ще разгледаме начините, по които можем да намалим "физическия" размер на съхраняваното в PostgreSQL и влиянието им върху производителността на сървъра.
Ще говорим за настройките TOAST и подравняването на данни. "Средно" тези методи ще позволят да спестим не твърде много ресурси, но без нужда от модификация на приложния код.
Въпреки това, нашият опит се оказа доста продуктивен в това отношение, тъй като хранилището на почти всеки мониторинг по своята природа е в по-голямата си част append-only от гледна точка на записваните данни. И ако ви интересува как можете да принудите базата да пише на диск при 200MB/s наполовина по-малко – моля, под кат.
Малки тайни на големите данни
По профила на работа , той регулярно получава от логовете текстови пакети.
А тъй като , чийто БД мониторим, е многокомпонентен продукт със сложни структури от данни, то и запитванията за постигане на максимална производителност се оказват наистина Така че и обемът на всяка отделна инстанция на запитването или резултата в постъпващия ни лог е "в средно" достатъчно голям.
Нека да погледнем структурата на една от таблиците, в която записваме "сурови" данни – тоест точно оригиналния текст от записа на лога:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- ключ секция
    date
, data -- най-важното
    text
, PRIMARY KEY(pack, recno)
);
Типична такава таблица (вече секционирана, безусловно, затова това е – шаблон на секцията), където най-важното – текст. Понякога достатъчно обемен.
Не забравяйте, че "физическият" размер на едно запис в PG не може да заема повече от една страница данни, но "логическият" размер – съвсем различна работа. За да запишете обемна стойност в поле (varchar/text/bytea) се използва :
PostgreSQL използва фиксиран размер на страницата (обикновено 8 КБ) и не позволява кортежите да заемат няколко страници. Следователно е невъзможно да се съхраняват много големи стойности на полета директно. За да се преодолее това ограничение, големите стойности на полета се компресират и/или разделят на няколко физически реда. Това става незабележимо за потребителя и оказва незначително влияние върху голяма част от кода на сървъра. Този метод е известен като TOAST …
Всъщност за всяка таблица с „потенциално големи“ полета автоматично на всяко „голямо“ записване на сегменти по 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Тоест ако трябва да запишем ред с „голяма“ стойност data, реалното записване ще се осъществи не само в основната таблица и нейния PK, но и в TOAST и нейния PK.
Намаляване на TOAST влияние
Но повечето записи при нас не са толкова големи, в 8KB трябва да се поберат — как можем да спестим от това?..
Тук на помощ идва атрибутът на колоната в таблицата:
- EXTENDED позволява както компресия, така и отделно съхранение. Това е стандартен вариант за повечето типове данни, съвместими с TOAST. Първо се опитва да се извърши компресия, след това — съхранение извън таблицата, ако редът все още е твърде голям.
- MAIN позволява компресия, но не и отделно съхранение. (Всъщност, отделно съхранение все пак ще се извърши за такива колони, но само като крайна мярка, когато няма друг начин да се намали редът, за да се побере на страницата.)
Всъщност, това е точно това, от което се нуждаем за текст — максимално компресиране, и ако изобщо не може да се побере — прехвърляне в TOAST. Можем да направим това направо „на лето“, с една команда:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Как да оценим ефекта
Тъй като потокът от данни се променя всеки ден, не можем да сравняваме абсолютни цифри, но в относителни термини, колкото по-малка част записахме в TOAST — толкова по-добре. Но тук има опасност — колкото по-голям е „физическият“ обем на всеки отделен запис, толкова „по-широк“ става индексът, тъй като трябва да обхваща по-голямо количество страници с данни.
Секция преди промените:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Секция след промените:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Всъщност, ние съобщаваха в TOAST два пъти по-малко, което облекчи не само диска, но и CPU:
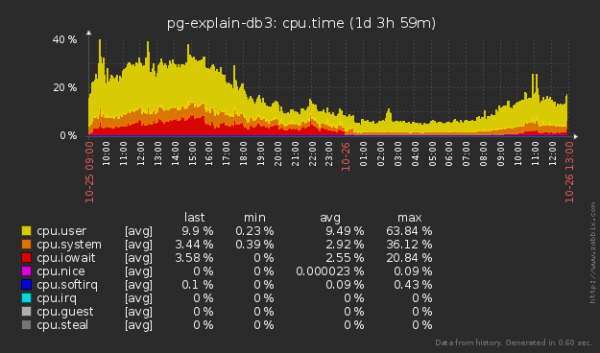
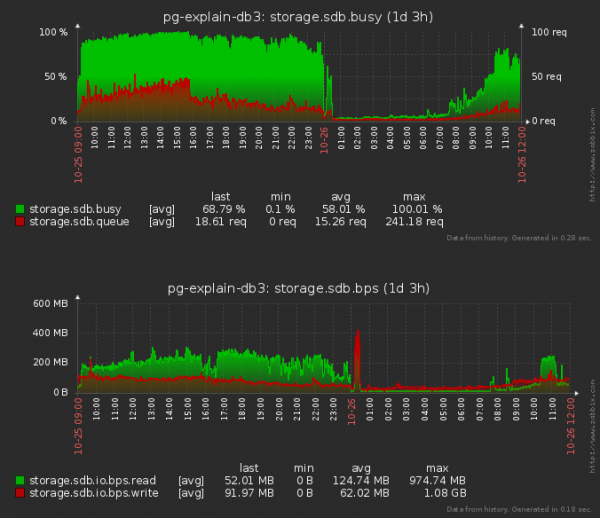
Забелязвам, че започнахме да 'четем' диска по-малко, не само 'пишем' - тъй като при добавяне на записа в определена таблица е необходимо 'да прочетем' и част от дървото на всеки един от индексите, за да определим бъдещата му позиция в тях.
На кого му е хубаво да живее с PostgreSQL 11
След обновлението до PG11 решихме да продължим 'настройката' на TOAST и обърнахме внимание, че от тази версия е наличен за конфигуриране параметър :
Кодът за обработка на TOAST сработва само когато размерът на строката, която трябва да се съхрани в таблицата, е по-голям от TOAST_TUPLE_THRESHOLD байта (обикновено 2 KB). Кодът TOAST ще компресира и/или извежда стойностите на полето извън таблицата, докато размерът на строката не стане по-малък от TOAST_TUPLE_TARGET байта (променлива стойност, също обикновено 2 KB) или намаляването на обема не е възможно.
Решихме, че данните обикновено са или 'съвсем кратки', или веднага 'много дълги', затова решихме да се ограничим до минимално възможната стойност:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Нека видим как новите настройки се отразиха на натоварването на диска след пренастройката:
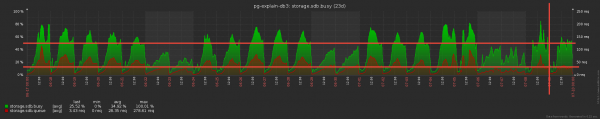
Добре! Средната опашка към диска намаля приблизително 1.5 пъти, а 'заемането' на диска - с около 20%! Но може би това е оказало влияние и на CPU?
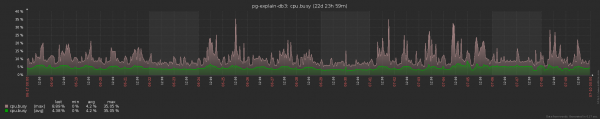
По всяка вероятност, не стана по-зле. Въпреки това, трудно е да се съди, ако дори тези обеми все пак не могат да вдигнат средното натоварване на CPU над 5%.
Смяната на местата на съставките променя сумата...
Както е известно, стотинка пести лев, и при нашите обеми на съхранение около 10TB/месец дори малка оптимизация може да донесе добри печалби. Затова обърнахме внимание на физическата структура на нашите данни - как точно 'са подредени' полетата в записа на всяка от таблиците.
Заради това пряко :
Много архитектури предвиждат подравняване на данните по границите на машинни думи. Например, на 32-битна система x86 целите числа (тип integer, заема 4 байта) ще бъдат подравнени по границата на 4-байтови думи, както и двойно прецизно число (тип double precision, 8 байта). На 64-битна система стойностите double ще бъдат подравнени по границата на 8-байтови думи. Това е още една причина за несъвместимост.
Поради подравняването размерът на табличния ред зависи от реда на разположение на полетата. Обикновено този ефект не е особено забележим, но в някои случаи може да доведе до съществено увеличаване на размера. Например, ако разположите полета от тип char(1) и integer наизменка, между тях обикновено ще изчезват 3 байта без предназначение.
Нека започнем с синтетични модели:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 байта

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 байта
От къде дойде двойката излишни байтове в първия случай? Всичко е просто — 2-байтовият smallint се подравнява по 4-байтовата граница преди следващото поле, а когато е последно — няма какво да се подравнява и няма нужда.
В теорията — всичко е добре и можете да размествате полетата както искате. Нека проверим на реални данни, на примера на една от таблиците, чиято дневна секция заема около 10-15GB.
Началната структура:
CREATE TABLE public.plan_20190220
(
-- Наследена от таблица plan:  pack uuid NOT NULL,
-- Наследена от таблица plan:  recno smallint NOT NULL,
-- Наследена от таблица plan:  host uuid,
-- Наследена от таблица plan:  ts timestamp с времева зона,
-- Наследена от таблица plan:  exectime numeric(32,3),
-- Наследена от таблица plan:  duration numeric(32,3),
-- Наследена от таблица plan:  bufint bigint,
-- Наследена от таблица plan:  bufmem bigint,
-- Наследена от таблица plan:  bufdsk bigint,
-- Наследена от таблица plan:  apn uuid,
-- Наследена от таблица plan:  ptr uuid,
-- Наследена от таблица plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Секция след смяна на реда на колоните — точно същите полета, само редът е различен:
CREATE TABLE public.plan_20190221
(
-- Наследена от таблица plan:  dt date NOT NULL,
-- Наследена от таблица plan:  ts timestamp с времева зона,
-- Наследена от таблица plan:  pack uuid NOT NULL,
-- Наследена от таблица plan:  recno smallint NOT NULL,
-- Наследена от таблица plan:  host uuid,
-- Наследена от таблица plan:  apn uuid,
-- Наследена от таблица plan:  ptr uuid,
-- Наследена от таблица plan:  bufint bigint,
-- Наследена от таблица plan:  bufmem bigint,
-- Наследена от таблица plan:  bufdsk bigint,
-- Наследена от таблица plan:  exectime numeric(32,3),
-- Наследена от таблица plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Общият обем на секцията се определя от количеството "факти" и зависи само от външните процеси, затова ще разделим размера на heap (pg_relation_size) за броя записи в нея — т.е. ще получим среден размер на реално съхранена запис:
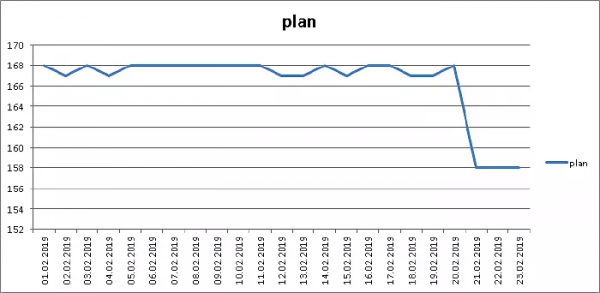
Минус 6% обем, отлично!
Но всичко, разбира се, не е толкова розово — все пак в индексите не можем да променим реда на полетата, поради което „в цялост“ (pg_total_relation_size)…
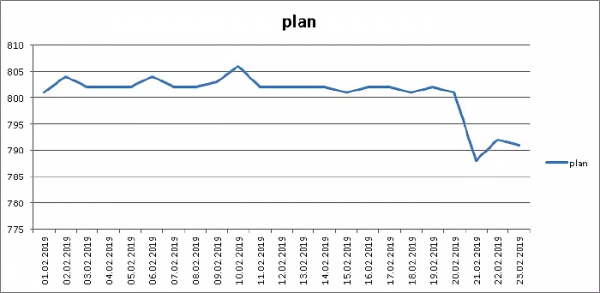
… въпреки това и тук спестихме 1.5%, без да променим и ред код. Наистина!
Забележете, че посоченият по-горе вариант на разположение на полетата — не е факт, че е най-оптимален. Защото някои блокове от полета не бих искал да „разкъсвам“ дори и по естетически съображения — например, двойка (pack, recno), която е PK за тази таблица.
Въобще, определението за „минимално“ подреждане на полета — е достатъчно проста „переборна“ задача. Затова можете да получите резултати дори по-добри от нашите на вашите данни — опитайте!
Източник: habr.com
