

Здравей, Хабр!
В контекста на сегашните събития покрай коронавируса, редица интернет услуги започнаха да получават увеличен товарооборот. Например, , тъй като нямаше достатъчно мощности. И далеко не винаги можете да ускорите сървъра, просто добавяйки по-мощно оборудване, но запитванията на клиентите трябва да се обработват (или те ще отидат при конкурентите).
В тази статия кратко ще ви разкажа за популярните практики, които ще ви позволят да създадете бърза и отказоустойчива услуга. Обаче от възможните схеми за разработка съм избрал само тези, които в момента са лесни за използване. За всяка точка или имате готови библиотеки, или имате възможност да решите задачата с помощта на облачна платформа.
Хоризонтално мащабиране
Най-простият и известен пункт. Условно, най-често срещаните две схеми за разпределение на товара са хоризонтално и вертикално мащабиране. позволявате на услугите да работят паралелно, като по този начин разпределяте натоварването между тях. вие поръчвате по-мощни сървъри или оптимизирате кода.
За пример ще взема абстрактно облачно хранилище за файлове, т.е. някакъв аналог на OwnCloud, OneDrive и така нататък.
Стандартната картинка на подобна схема е по-долу, но тя само демонстрира сложността на системата. В крайна сметка, трябва да синхронизираме услугите. Какво ще се случи, ако потребителят запази файл от таблета си и после иска да го види на телефона?
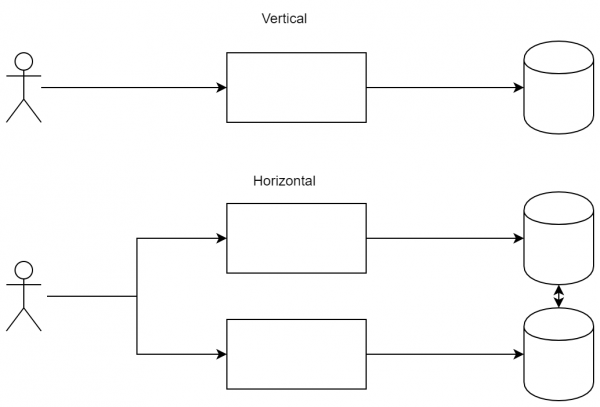
Разликата между подходите: в вертикалното мащабиране сме готови да увеличим мощността на възлите, докато в хоризонталното — добавяме нови възли, за да разпределим натоварването.
CQRS
е доста важен патрон, тъй като позволява на различни клиенти не само да се свързват с различни услуги, но и да получават идентични потоци от събития. Неговите предимства не са толкова очевидни за простото приложение, но той е изключително важен (и прост) за натоварената услуга. Същността му е: входящите и изходящите потоци от данни не трябва да се пресичат. Тоест не можете да изпратите запитване и да очаквате отговор, вместо това изпращате запитване в услуга А, но получавате отговор в услуга Б.
Първият бонус на този подход е възможността за прекъсване на връзката (в широкия смисъл на термина) по време на изпълнението на дълга заявка. За пример нека вземем повече или по-малко стандартна последователност:
- Клиентът изпрати заявление до сървъра.
- Сървърът стартира дълга обработка.
- Сървърът отговори на клиента с резултата.
Да предположим, че в точка 2 е настъпило прекъсване на връзката (или мрежата е преконфигурирана, или потребителят е преминал на друга страница, прекъсвайки свързването). В този случай на сървъра ще му бъде трудно да изпрати отговор на потребителя с информацията какво точно е обработено. Прилагайки CQRS, последователността ще бъде малко по-различна:
- Клиентът се абонира за актуализации.
- Клиентът изпрати заявление до сървъра.
- Сървърът отговори 'заявлението е прието'.
- Сървърът отговори с резултата чрез канала от точка '1'.
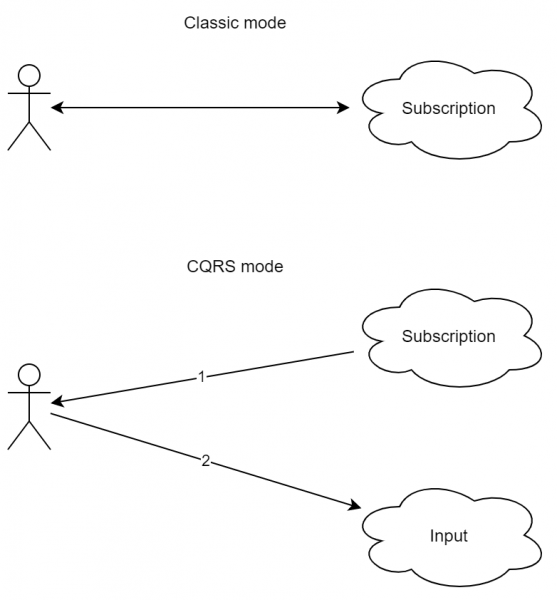
Както се вижда, схемата е малко по-сложна. Освен това интуитивният подход request-response тук липсва. Въпреки това, както се вижда, прекъсването на връзката по време на обработката на заявката няма да доведе до грешка. По-скоро, ако потребителят всъщност е свързан към услугата от няколко устройства (например от мобилен телефон и таблет), може да се организира така, че отговорът да идва и на двете устройства.
Интересното е, че кодът за обработка на входящите съобщения става почти идентичен (не на 100%) както за събитията, повлияни от самия клиент, така и за останалите събития, включително от други клиенти.
Въпреки това, в реалността получаваме допълнителни бонуси, тъй като еднопосочният поток може да бъде обработван по функционален начин (използвайки RX и аналози). И това вече е сериозен плюс, тъй като по същество приложението може да бъде направено напълно реактивно, и то с използването на функционален подход. За големи приложения това може значително да спести ресурси за разработка и поддръжка.
Ако комбинираме този подход с хоризонтално мащабиране, получаваме бонуса, че можем да изпращаме заявки до един сървър, а да получаваме отговори от друг. По този начин клиентът може сам да избира удобната за него услуга, а системата вътрешно все пак ще може коректно да обработи събитията.
съхранение на събития
Както знаете, една от основните характеристики на разпределената система е липсата на общо време и обща критична секция. За един процес можете да направите синхронизация (на същите мютекси), в рамките на която можете да сте сигурни, че никой друг не изпълнява този код. Въпреки това, за разпределената система подобно нещо е опасно, тъй като това ще доведе до разходи, а също така ще убие цялата привлекателност на мащабирането — все пак всички компоненти ще чакат един и същ.
От тук произтича важен факт — бърза разпределена система не може да бъде синхронизирана, тъй като това би намалило производителността. От друга страна, често имаме нужда от определена последователност на компонентите. И за това можем да използваме подход с , където се гарантира, че в отсъствието на промени в данните след определен период от време след последното обновление ("в крайна сметка") всички заявки ще връщат последната обновена стойност.
Важното е да разберем, че за класическите бази данни често се прилага , където всеки възел притежава идентична информация (подобно често се постига, когато транзакцията се счита за извършена само след отговора на втория сървър). Има някои отстъпки поради нивата на изолация, но основната същност остава същата — можете да живеете в напълно съгласуван свят.
Въпреки това, нека се върнем на първоначалната задача. Ако част от системата може да бъде изградена с , тогава може да се построи следната схема.
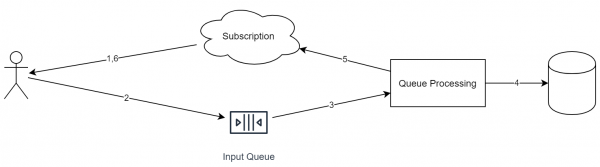
Важно е да отбележим особеностите на този подход:
- Всяка входяща заявка се поставя в една опашка.
- В процеса на обработка на запитването, услугата може също да поставя задачи в други опашки.
- Всяко входящо събитие има идентификатор (който е необходим за дедупликация).
- Опашката работи идеологически по схемата "само добавяне". Не могат да се изтриват елементи или да се пренареждат.
- Опашката работи по схемата FIFO (извинявайте за тавтологията). Ако е необходимо да се извършва паралелно изпълнение, трябва в един от етапите да се прехвърлят обектите в различни опашки.
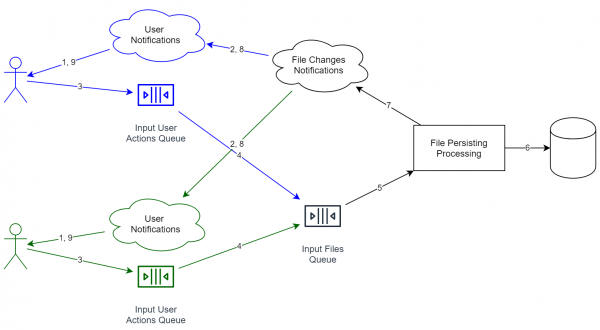
Напомням, че разглеждаме случая на онлайн файлово хранилище. В този случай системата ще изглежда приблизително така:
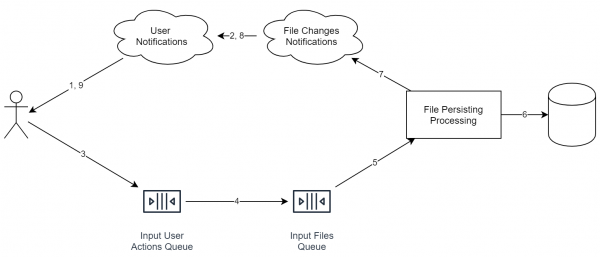
Важно е, че услугите в диаграмата не означават непременно отделен сървър. Дори процесът може да е един и същ. Важно е друго: идеологически тези неща са разделени по такъв начин, че да може лесно да се приложи хоризонтално мащабиране.
А за двама потребители схемата ще изглежда така (услугите, предназначени за различни потребители, са обозначени с различен цвят):
Бонусите от подобна комбинация:
- Услугите за обработка на информация са разделени. Опашките също са разделени. Ако ни е необходимо да увеличим пропускната способност на системата, просто трябва да стартираме повече услуги на повече сървъри.
- Когато получаваме информация от потребителя, не е необходимо да изчакваме пълното съхранение на данните. Обратно, достатъчно е да отговорим с "ок", а после постепенно да започнем работа. Освен това опашката изглажда пиковете, тъй като добавянето на нов обект става бързо, а потребителят не трябва да чака пълния цикъл.
- За пример добавих услуга за дедупликация, която се опитва да комбинира еднакви файлове. Ако тя работи дълго при 1% от случаите, клиентът практически няма да забележи това (вж. по-горе), което е голямо предимство, тъй като не изискваме 100% бързина и надеждност.
Обаче веднага се виждат и минусите:
- Нашата система е загубила стриктната координация. Това означава, че ако, например, се абонирате за различни услуги, теоретично можете да получите различно състояние (тъй като една от услугите може да не успее да приеме авизацията от вътрешната опашка). Като още едно последствие, системата сега няма общо време. Тоест не може, например, да се сортират всички събития просто по времето на получаване, тъй като часовниците между сървърите може да не са синхронизирани (повече от това, същото време на два сървъра е утопия).
- Никаки събития вече не могат просто да бъдат откатени (както можеше да се направи с база данни). Вместо това трябва да добавите ново събитие - , което ще промени последното състояние на необходимото. Като пример от сходна област: без презапис на историята (което е лошо в редица случаи) в git не можете да откатите комит, обаче можете да направите специален , който по същество просто ще върне старата състояние. Въпреки това, в историята ще остане и грешният комит, и rollback.
- Схемата на данните може да се променя от версия на версия, но старите събития сега не могат да бъдат актуализирани към нов стандарт (тъй като събитията по принцип не могат да бъдат променяни).
Както се вижда, Event Sourcing отлично съжителства с CQRS. Освен това, реализирането на система с ефективни и удобни опашки, но без разпределение на потоците от данни, е само по себе си сложно, тъй като ще се наложи да добавяме точки на синхронизация, които ще неутрализират целия положителен ефект от опашките. Прилагането на двата подхода едновременно изисква малки корекции в кода на програмата. В нашия случай, при изпращане на файл на сървъра, в отговора получаваме само „ок“, което означава единствено, че „операцията по добавяне на файла е запазена“. Формално, това не означава, че данните вече са достъпни на другите устройства (например, услугата за дедупликация може да реконструира индекса). Въпреки това, след известно време клиентът ще получи известие в стил „файл Х е запазен“.
В резултат:
- Броят на статусите за изпращане на файлове се увеличава: вместо класическото „файлът е изпратен“ получаваме два: „файлът е добавен в опашката на сървъра“ и „файлът е запазен в хранилището“. Последното означава, че другите устройства вече могат да започнат да получават файла (с поправката, че опашките работят с различна скорост).
- Поради факта, че информацията за изпращането сега идва по различни канали, необходимо е да измислим решения, за да получим статус на обработката на файла. Следствие от това е: в контекста на класическия request-response, клиентът може да бъде рестартиран по време на обработката на файла, но статуса на самата обработка ще бъде правилен. Освен това, тази точка работи почти изцяло от самото начало. В резултат: сега сме по-толерантни към откази.
Sharding
Както вече беше описано по-горе, в системите с event sourcing няма строга последователност. И така, можем да използваме няколко хранилища без никаква синхронизация между тях. Приближавайки се до нашата задача, можем:
- Да разделяме файловете по типове. Например, изображения/видео могат да се декодират и избират с по-ефективен формат.
- Разделете акаунтите по държави. Поради многобройните закони, подобно нещо може да е необходимо; обаче, тази архитектурна схема дава възможност за автоматично изпълнение на подобно.
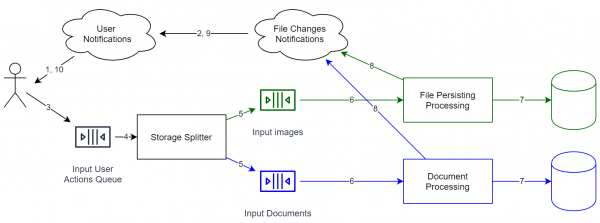
Ако искате да прехвърлите данни от едно хранилище в друго, стандартните инструменти не са достатъчни. За съжаление, в такъв случай е необходимо да спрете опашката, да извършите миграция и след това да я стартирате отново. В общия случай данни не могат да бъдат прехвърлени "в движение", но ако опашката на събитията се съхранява напълно и имате копия на предишните състояния на хранилището, можем да възпроизведем събитията по следния начин:
- В Event Source всяко събитие има свой уникален идентификатор (в идеалния случай — непонижаващ се). Следователно, в хранилището можем да добавим поле — id на последния обработен елемент.
- Дублираме опашката, за да могат всички събития да бъдат обработвани за няколко независими хранилища (първото — това, в което в момента се съхраняват данните, а второто — ново, но все още празно). Втората опашка, разбира се, все още не се обработва.
- Стартираме втората опашка (т.е. започваме възпроизвеждането на събития).
- Когато новата опашка стане относително празна (т.е. средната времева разлика между добавянето на елемент и извличането му е приемлива), може да започнем да прехвърляме четец на новото хранилище.
Както се вижда, в нашата система никога не е имало и все още няма строга съгласуваност. Има само eventual consistency, т.е. гаранция за това, че събитията се обработват в същия ред (въпреки че, възможно е, с различни забавяния). И, използвайки това, можем сравнително лесно да пренесем данните без спиране на системата на другия край на света.
Така че, продължавайки примера ни за онлайн хранилище за файлове, такава архитектура вече предоставя редица предимства:
- Можем да местим обектите по-близо до потребителите, и то динамично. По този начин можем да повишим качеството на услугата.
- Можем да съхраняваме част от данните вътре в компаниите. Например, потребителите на Enterprise често изискват съхранение на техните данни в контролирани датацентрове (за да избегнат изтичане на данни). Чрез sharding можем лесно да поддържаме това. И задачата става още по-лесна, ако клиентът разполага с съвместимо облако (например, ).
- Но най-важното е, че не е нужно да го правим. Всъщност, за начало, един склад за всички акаунти напълно би ни устроил, за да можем по-бързо да започнем работа. Основната характеристика на тази система е, че, въпреки че може да се разширява, в началния етап е достатъчно проста. Просто не трябва веднага да пишем код, който работи с милион отделни независими опашки и т.н. Ако потрябва, това може да бъде направено в бъдеще.
Хостинг на статично съдържание
Тази точка може да изглежда напълно очевидна, но все пак е необходима за едно относително стандартно натоварено приложение. Същността й е проста: всичкото статично съдържание не се предоставя от същия сървър, на който се намира приложението, а от специални, предназначени именно за тази цел. В резултат на това тези операции се извършват по-бързо (условният nginx дава файлове и по-бързо, и по-евтино, отколкото Java-сървър). Плюс архитектурата на CDN () позволява да разполагаме файловете ни по-близо до крайните потребители, което положително влияе на удобството при работа с услугата.
Най-простият и стандартен пример за статично съдържание е набор от скриптове и изображения за сайт. С тях е всичко просто – те са известни предварително, последващо архивиране се качва на CDN сървъри, откъдето се раздават на крайните потребители.
Въпреки това, на практика, за статично съдържание може да се приложи подход, подобен на ламбда архитектурата. Нека се върнем на нашата задача (онлайн хранилище за файлове), в която трябва да раздаваме файлове на потребителите. Най-простото решение е да направим услуга, която за всяка заявка на потребителя прави всичките необходими проверки (авторизация и т.н.) и след това изтегля файла директно от нашето хранилище. Главният недостатък на този подход е, че статичното съдържание (а файл с определена версия, по същество, е статично съдържание) се раздава от същия сървър, който съдържа бизнес логиката. Вместо това, можем да направим следната схема:
- Сървърът предоставя URL за изтегляне. Той може да бъде вида file_id + key, където key представлява мини цифров подпис, който дава право на достъп до ресурса за близките 24 часа.
- Раздаването на файла се осъществява от прост nginx с следните опции:
- Кеширане на съдържанието. Тъй като този сървис може да бъде на отделен сървър, оставихме си резерв за бъдещето с възможността да съхраняваме всички последно изтеглени файлове на диска.
- Проверка на ключа в момента на създаване на връзката.
- По желание: потоково обработване на съдържанието. Например, ако компресираме всички файлове в сървиса, можем да направим разархивиране директно в този модул. В резултат: IO операциите се извършват там, където им е най-мястото. Архиваторът на Java лесно може да консумира много допълнителна памет, но пренаписването на сървиса с бизнес логика на условни Rust/C++ също може да се окаже неефективно. В нашия случай обаче се използват различни процеси (или дори сървиси), поради което можем доста ефективно да разделим бизнес логиката и IO операциите.
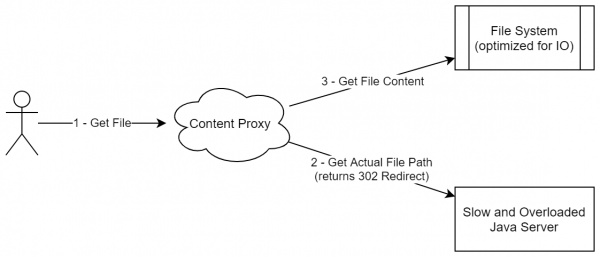
Подобна схема не прилича много на раздаване на статично съдържание (тъй като не изпращаме целия пакет статика никъде), но в действителност такъв подход именно раздава неизменяеми данни. Освен това, тази схема може да се обобщи и за други случаи, когато съдържанието не е просто статично, а може да бъде представено под формата на набор от неизменяеми и неделими блокове (въпреки че те могат да се добавят).
Още един пример (за по-добро разбиране): ако сте работили с Jenkins/TeamCity, знаете, че и двете решения са написани на Java. И двете представляват Java процес, който се занимава както с оркестрацията на компилации, така и с управлението на съдържание. В частност, и двете имат задачи от вида "да предадат файл/папка от сървера". Например: издаване на артефакти, предаване на изходен код (когато агентът не изтегля кода директно от репозитория, а вместо него го прави сървърът), достъп до логовете. Всички тези задачи се отличават по натоварването на IO. Тоест, излиза, че сървърът, отговарящ за сложната бизнес логика, също трябва да може ефективно да пренася големи потоци от данни. И най-интересното е, че подобна операция може да бъде делегирана на същия nginx по абсолютно същата схема (освен ако не добавим ключа за данни в заявката).
Обаче, ако се върнем към нашата система, получаваме подобна схема:
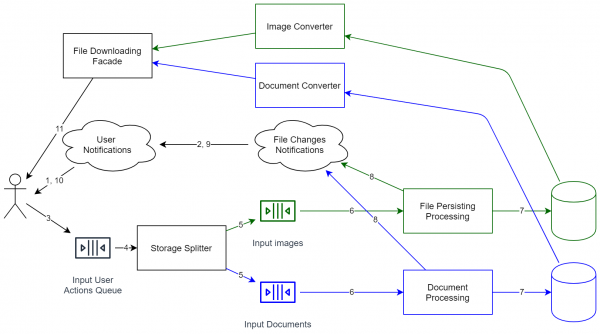
Както може да се види, системата стана радикално по-сложна. Вече не е просто мини-процес, който съхранява файлове локално. Необходима е вече не така проста поддръжка, контрол на версиите на API и т.н. Затова, след като всички диаграми са нарисувани, най-добре е детайлно да се оцени дали разширяемостта на тези разходи е оправдана. Обаче, ако искате да имате възможност за разширяване на системата (включително и за работа с още по-голям брой потребители), ще е необходимо да изберете подобни решения. В резултат системата е готова за увеличаване на натоварването (практически всеки компонент може да се клонира за хоризонтално мащабиране). Системата може да се актуализира без спиране (просто някои операции ще се забавят незначително).
Както вече споменах в самото начало, в момента редица интернет услуги получават увеличено натоварване. И някои от тях просто спират да работят правилно. Всъщност системите отказват точно в момента, когато бизнесът трябва да генерира приходи. Тоест, вместо отложена доставка, вместо да предлагат на клиентите "планирайте доставка за следващите месеци", системата просто казва "отидете при конкурентите". Всъщност, това е цената на ниската производителност: загубите се случват точно когато печалбите биха били най-високи.
Заключение
Всички тези подходи са били известни и преди. Същият VK отдавна използва идеята за Static Content Hosting за предоставяне на изображения. Множество онлайн игри използват схема за Sharding, за да разделят играчите по региони или за разделяне на игровите локации (ако светът е единен). Event Sourcing подходът активно се използва в електронната поща. Повечето приложения за търговци, където данните непрекъснато пристигат, всъщност са построени на подхода CQRS, за да имат възможност да филтрират получаваните данни. Освен това хоризонталното мащабиране се прилага от доста време в много услуги.
Въпреки това, най-важното е, че всички тези шаблони стана много лесно да се прилагат в съвременните приложения (ако са на място, разбира се). Облачните услуги предлагат разпределение на натоварването и хоризонтална мащабируемост веднага, което е много по-лесно, отколкото да поръчвате различни посветени сървъри в различни дата центрове сами. CQRS стана много по-лесен, поне поради развитието на библиотеки като RX. Преди 10 години рядко уебсайт можеше да поддържа нещо такова. Event Sourcing също се настройва невероятно лесно благодарение на готови контейнери с Apache Kafka. Преди 10 години това щеше да е иновация, а сега е рутина. Подобно е и с хостинга на статично съдържание: благодарение на по-удобните технологии (включително защото има подробна документация и голямо количество отговори), подобен подход стана още по-прост.
В крайна сметка, реализацията на редица доста сложни архитектурни шаблони сега стана много по-лесна, а следователно е добре да се вгледате по-рано в тях. Ако в десетгодишно приложение са се отказали от едно от решенията по-горе поради високите разходи за внедряване и експлоатация, то сега, в ново приложение или след рефакториране, може да се създаде услуга, която архитектурно да бъде както разширяема (с оглед на производителността), така и готова за нови изисквания от клиентите (например, за локализация на лични данни).
И най-важното: моля, не използвайте тези подходи, ако имате просто приложение. Да, те са красиви и интересни, но за уебсайт с пикова посещаемост от 100 души обикновено можете да се справите с класически монолит (поне отвън, отвътре всичко може да бъде разделено на модули и т.н.).
Източник: habr.com
