

Прим. прев.: Това е превод на публичен постмортем от инженерния блог на компанията . В него се описва проблем с conntrack в Kubernetes кластера, който доведе до частичен престой на някои производствени услуги.
Тази статия може да бъде полезна за тези, които искат да научат малко повече за постмортемите или да предотвратят потенциални проблеми с DNS в бъдеще.
Това не е DNS
Не може да е, че това е DNS
Беше DNS
Малко за постмортемите и процесите в Preply
В постмортема се описва неизправност в работата или събитие в производството. Постмортемът включва хронология на събитията, описание на въздействието върху потребителя, основната причина, действията и извлечените уроци.
На седмичните срещи с пици, в кръга на техническия екип, споделяме различна информация. Една от най-важните части на тези срещи са постмортемите, които най-често са съпроводени от презентация с слайдове и по-дълбок анализ на инцидента. Въпреки че не „аплодираме“ след постмортемите, се стараем да развиваме култура на „без упреци“ (). Вярваме, че писането и представянето на постмортеми може да ни помогне (и не само) в предотвратяването на подобни инциденти в бъдеще, именно затова ги споделяме.
Лицата, ангажирани в инцидента, трябва да се чувстват, че могат да разкажат подробно за него, без да се страхуват от наказание или отмъщение. Никакво укоряване! Писането на постмортем е възможност за учене за цялата компания.
Проблеми с DNS в Kubernetes. Постмортем
Дата: 28.02.2020
Автори: Амет У., Андрей С., Игор К., Алексей П.
Статус: Завършен
Кратко: Частична недостъпност на DNS (26 мин) за някои услуги в Kubernetes кластера
Влияние: 15000 събития загубени за услуги A, B и C
Основна причина: Kube-proxy не успя правилно да изтрие старата записка от таблицата conntrack, поради което някои услуги все още се опитваха да се свържат с несъществуващи подове.
E0228 20:13:53.795782 1 proxier.go:610] Неуспешно изтриване на kube-system/kube-dns:dns конечни връзки, грешка: грешка при изтриване на записи conntrack за UDP партньор {100.64.0.10, 100.110.33.231}, грешка: командата conntrack върна: ...Триггер: Поради ниско натоварване в Kubernetes клъстера, CoreDNS-autoscaler намали броя на подовете в деплоймента от три на два.
Решение: Новото разгръщане на приложението задейства създаването на нови нодове, CoreDNS-autoscaler добави повече подове за обслужване на кластер, което предизвика презаписване на таблицата conntrack.
Откритие: Мониторингът на Prometheus установи голямо количество 5xx грешки за услугите A, B и C и инициира обаждане до дежурните инженери.
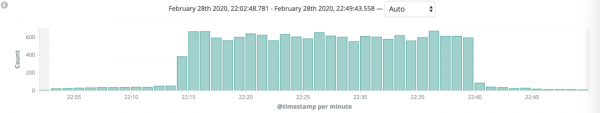
5xx грешки в Kibana.
Действия
Действие.
Тип
Отговорен.
Задача
Изключи автоскалера за CoreDNS.
предотв.
Амет У.
DEVOPS-695.
Настройка на кеширащ DNS-сървър.
намали.
Макс В.
DEVOPS-665.
Настройване на мониторинг на conntrack.
предотв.
Амет У.
DEVOPS-674.
Извлечени уроци
Какво беше добре:
- Мониторингът сработи точно. Реакцията беше бърза и организирана.
- Не се сблъскахме с никакви ограничения на нодовете.
Какво не беше наред:
- Все още неизвестна реална първоначална причина, изглежда като в conntrack.
- Всички действия коригират само последиците, не първоначалната причина (бъг).
- Знаехме, че рано или късно може да имаме проблеми с DNS, но не приоритизирахме задачите.
Къде имахме късмет:
- Новото разгръщане задейства CoreDNS-autoscaler, който презаписа таблицата conntrack.
- Този бъг засегна само част от услугите.
Хронология (EET).
Време
Действие.
22:13
CoreDNS-autoscaler намали броя на подовете от три на два.
22:18
Дежурните инженери започнаха да получават обаждания от системата за мониторинг.
22:21
Дежурните инженери започнаха да изясняват причината за грешките.
22:39
Дежурните инженери започнаха да възстановяват една от последните услуги на предишна версия.
22:40
5xx грешките спряха да се появяват, ситуацията се стабилизира.
- Време до откритие: 4 минути.
- Време до предприемане на действия: 21 минута.
- Време до коригиране: 1 минута.
Допълнителна информация
- Логове на CoreDNS:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Претеглена надолу реплика на coredns-6cbb6646c9 до 2. - Връзки към Kibana (изрязано), Grafana (изрязано).
За минимизиране на използването на процесора, ядрото на Linux използва нещо, наречено conntrack. В кратце, това е утилита, която съдържа списък с NAT-записи, които се съхраняват в специална таблица. Когато следващият пакет пристигне от същия под в същия под, крайният IP адрес няма да бъде изчислен отново, а ще се вземе от таблицата conntrack.
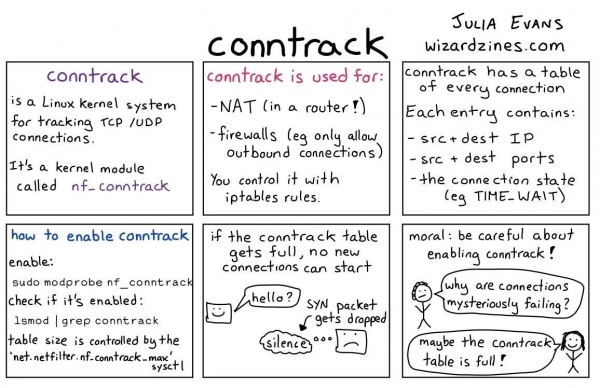
Как работи conntrack.
Итог
Това беше пример за един от нашите постмортеми с някои полезни връзки. Конкретно в тази статия споделяме информация, която може да бъде полезна на други компании. Затова не се страхуваме да правим грешки и затова направихме един от нашите постмортеми публичен. Ето още няколко интересни публични постмортеми:
- GitLab:
- Dropbox:
- Spotify:
- Множество други от и репозиторий
- Също публичен постмортем с SRE Book
Източник: habr.com
