

Здравей, Хабр!
Обичате ли да летите със самолети? Аз обожавам, но по време на самоизолацията започнах да анализирам данни за самолетни билети от един познат ресурс — Aviasales.
Днес ще разгледаме работата на Amazon Kinesis, ще изградим стрийминг система с реално време анализ и ще поставим NoSQL база данни Amazon DynamoDB като основно хранилище на данни, а също така ще настроим известия чрез SMS за интересни билети.
Всички подробности под катом! Да започваме!
Въведение
За примера ни е необходим достъп до . Достъпът до него е безплатен и неограничен, само е необходимо да се регистрирате в секция «Разработчици», за да получите своя API токен за достъп до данните.
Основната цел на тази статия е да даде общо разбиране за използването на потоково предаване на информация в AWS, оставяме настрана факта, че данните, връщани от използвания API, не са строго актуални и се предават от кеша, който се формира на основата на търсенията на потребителите на сайтовете Aviasales.ru и Jetradar.com за последните 48 часа.
Получените чрез API данни за самолетни билети ще бъдат автоматично парснати и предадени в нужния поток чрез Kinesis Data Analytics от Kinesis-агент, инсталиран на машина-генератор. Непреработената версия на този поток ще се записва директно в хранилището. Разширеното хранилище «сурови» данни в DynamoDB ще позволи да се провежда по-дълбок анализ на билетите чрез BI инструменти, например AWS Quick Sight.
Ще разгледаме два варианта за деплой на цялата инфраструктура:
- Ръчен — през AWS Management Console;
- Инфраструктура от кода Terraform — за мързеливите автоматизатори;
Архитектура на разработваната система
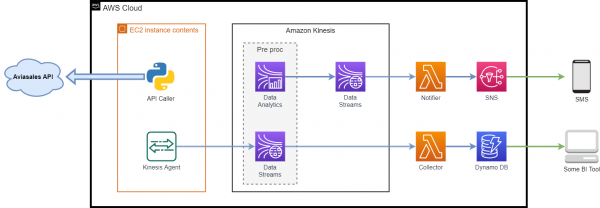
Използвани компоненти:
- — данните, връщани от този API, ще бъдат използвани за цялата следваща работа;
- — обикновена виртуална машина в облака, на която ще се генерира входящ поток от данни:
- — това е Java-приложение, инсталирано локално на машината, което предоставя прост начин за събиране и изпращане на данни в Kinesis (Kinesis Data Streams или Kinesis Firehose). Агентът постоянно следи набор от файлове в определени директории и изпраща нови данни в Kinesis;
- — Python-скрипт, който прави заявки към API и съхранява отговора в папка, която Kinesis Agent следи;
- — услуга за потоково предаване на данни в реално време с широки възможности за мащабиране;
- — безсерверна услуга, опростяваща анализа на поточни данни в реално време. Amazon Kinesis Data Analytics настройва ресурси за работа на приложения и автоматично се мащабира за обработка на каквито и да било обеми входящи данни;
- — услуга, която позволява изпълнение на код без резервиране и настройка на сървъри. Всички компютърни ресурси автоматично се мащабират спрямо всяко повикване;
- — база данни от тип "ключ-стойност" и документи, която осигурява закъснение под 10 милисекунди при работа в който и да е мащаб. При използване на DynamoDB не е необходимо да се разпределят каквито и да било сървъри, да се инсталират на тях актуализации или да се управляват. DynamoDB автоматично мащабира таблиците, коригирайки обема на наличните ресурси и запазвайки висока производителност. Никаки действия по администриране на системата не са необходими;
- — напълно управлявана услуга за изпращане на съобщения по модела "издател — абонат" (Pub/Sub), с помощта на която могат да се изолират микросервизи, разпределени системи и безсървърни приложения. SNS може да се използва за разпращане на информация до крайни потребители чрез мобилни push уведомления, SMS съобщения и имейли.
Начална подготовка
За емулация на поток от данни реших да използвам информация за авиобилети, предоставяна от API Aviasales. В доста обширен списък с различни методи, ще вземем един от тях — "Календар на цените за месец", който връща цените за всеки ден от месеца, групирани по брой на промените. Ако не се подаде месец за търсене в заявката, ще бъде върната информация за месеца, следващ текущия.
Така че, регистрираме се, получаваме своя токен.
Пример за заявка по-долу:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIОписаният по-горе начин на получаване на данни от API с посочен токен в заявката ще работи, но предпочитам да предавам токена за достъп чрез заглавката, затова в скрипта api_caller.py ще ползваме именно този метод.
Примерен отговор:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
В примера за отговор от API по-горе е показан билет от Санкт Петербург до Пхук… Ах, какво мечтание…
Тъй като съм от Казан, а Пукет в момента е "само на сън", нека потърсим билети от Санкт Петербург до Казан.
Предполага се, че вече имате акаунт в AWS. Искам особено да подчертая, че Kinesis и изпращането на уведомления чрез SMS не са включени в годишния . Но дори в такъв случай, като имате предвид няколко долара, напълно е възможно да построите предложената система и да експериментирате с нея. И, разбира се, не забравяйте да изтриете всички ресурси, след като вече не са нужни.
За щастие, DynamoDb и Lambda функции ще бъдат условно безплатни за нас, стига да останем в месечните безплатни лимити. Например, за DynamoDB: 25 GB хранилище, 25 WCU/RCU и 100 млн. заявки. И един милион извиквания на Lambda функции на месец.
Ръчно разгръщане на системата
Настройка на Kinesis Data Streams
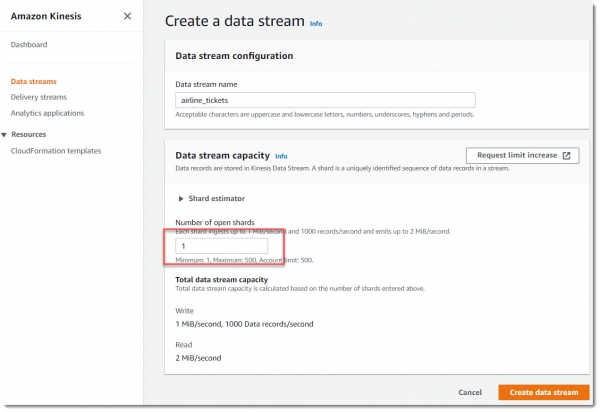
Да преминем към услугата Kinesis Data Streams и да създадем два нови потока с по един шард за всеки.
Какво е шард?
Шардът е основната единица за предаване на данни в Amazon Kinesis. Един сегмент осигурява предаване на входящи данни със скорост 1 MB/s и предаване на изходящи данни със скорост 2 MB/s. Един сегмент поддържа до 1000 заявки PUT в секунда. При създаване на поток от данни е необходимо да се посочи необходимият брой сегменти. Например, можете да създадете поток от данни с два сегмента. Този поток от данни ще осигури предаване на входящи данни със скорост 2 MB/s и предаване на изходящи данни със скорост 4 MB/s с поддръжка до 2000 заявки PUT в секунда.
Колкото повече шардове има в потока ви, толкова по-голяма е пропускателната способност. Всъщност, потоците се мащабират по този начин — чрез добавяне на шардове. Но колкото повече шардове имате, толкова по-висока е и цената. Всеки шард струва 1,5 цента на час и допълнително 1,4 цента за всеки милион операции по добавяне в потока (PUT payload units).
Нека създадем нов поток с име airline_tickets, за него ще бъде достатъчен 1 шард:
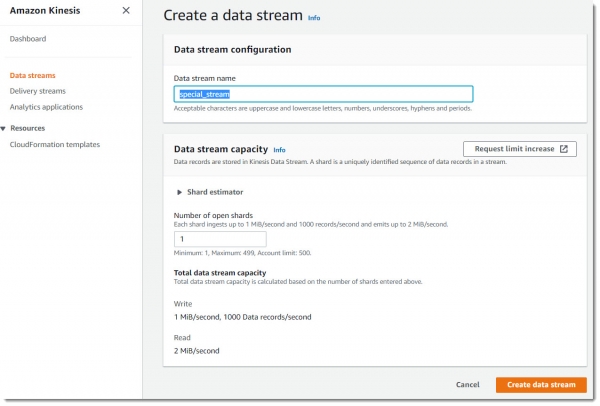
Сега ще създадем още един поток с име special_stream:
Настройка на продуцент
Като продуцент на данни за решаване на задачата, е достатъчно да използвате обикновен EC2 инстанс. Не е нужно да е мощна скъпа виртуална машина, напълно подходящ е спотовият t2.micro.
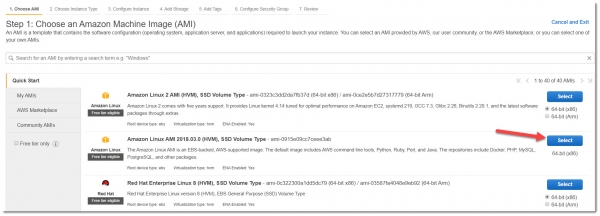
Важно забележка: за примера следва да използвате образа — Amazon Linux AMI 2018.03.0, с него има по-малко настройки за бързо стартиране на Kinesis Agent.
Преминаваме към услугата EC2, създаваме нова виртуална машина, избираме необходимия AMI тип t2.micro, който попада в Free Tier:
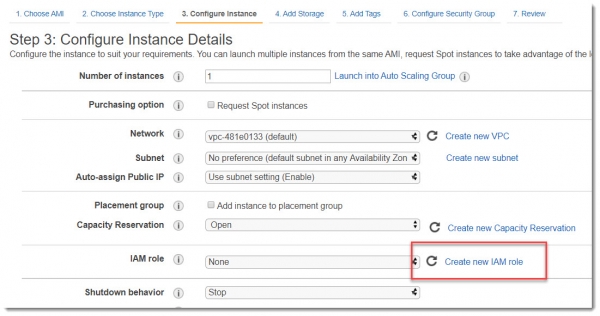
За да може новосъздадената виртуална машина да взаимодейства с услугата Kinesis, е необходимо да ѝ се предоставят права. Най-добрият начин да се направи това е чрез назначаване на IAM роля. Затова, на екрана Step 3: Configure Instance Details, следва да изберете Създайте нова IAM роля:
Създаване на IAM роля за EC2
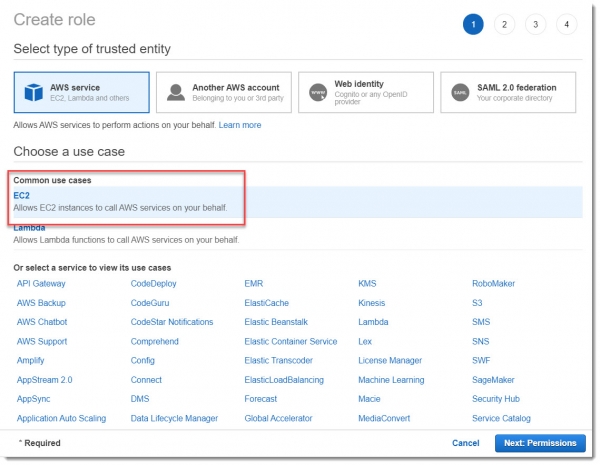
В отвореното прозорче избираме, че новата роля е за EC2 и преминаваме в раздела Permissions:
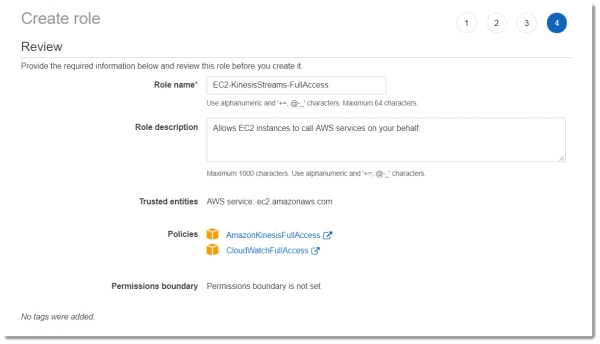
На учебния пример не е необходимо да се задълбочаваме в детайлите на грануларната настройка на правата за ресурси, затова ще изберем предварително настроените от Amazon политики: AmazonKinesisFullAccess и CloudWatchFullAccess.
Ще дадем някакво смислено име за тази роля, например: EC2-KinesisStreams-FullAccess. В резултат, трябва да получите същото като това на изображението по-долу:
След създаването на новата роля, не забравяйте да я прикрепите към създаваната инстанция на виртуалната машина:
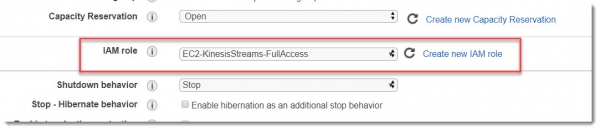
На този екран не променяме нищо друго и преминаваме към следващите прозорци.
Настройките на твърдия диск могат да останат по подразбиране, таговете също (въпреки че добра практика е да се използват тагове, поне да се даде име на инстанцията и да се посочи средата).
Сега сме на раздела Step 6: Configure Security Group, където е необходимо да създадем нова или да посочим съществуващата у вас Security group, позволяваща свързване чрез ssh (порт 22) към инстанцията. Изберете Source -> My IP и можете да стартирате инстанцията.
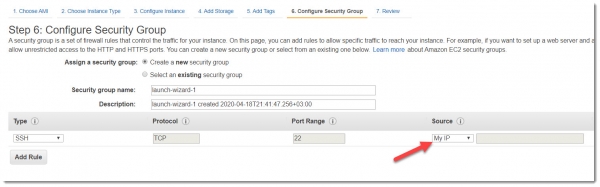
Когато тя премине в статус running, можете да опитате да се свържете с нея чрез ssh.
За да получите възможност за работа с Kinesis Agent, след успешната свързаност с машината, необходимо е да въведете следните команди в терминала:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Създайте папка за запазване на отговорите от API:
sudo mkdir /var/log/airline_ticketsПреди стартиране на агента е необходимо да настроите неговия конфиг:
sudo vim /etc/aws-kinesis/agent.jsonСъдържанието на файла agent.json трябва да има следния вид:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Както е видно от конфигурационния файл, агентът ще наблюдава директорията /var/log/airline_tickets/ за файлове с разширение .log, ще ги обработва и ще ги предава в потока airline_tickets.
Рестартираме услугата и се уверяваме, че е стартирала и работи:
sudo service aws-kinesis-agent restartСега ще изтеглим Python скрипта, който ще запитва данни от API:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
Скриптът api_caller.py запитва данни от Aviasales и записва получените отговори в директорията, която сканира Kinesis агентът. Реализацията на този скрипт е доста стандартна, има клас TicketsApi, който позволява асинхронно извикване на API. В този клас предаваме заглавката с токена и параметрите на запитването:
class TicketsApi:
    """Клас за извикване на API."""

    def __init__(self, headers):
        """Метод за инициализация."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Получаване на данни от API запитване."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Статус на отговора %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Опа! Възникна HTTP грешка: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Опа! Възникна грешка: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Връща заглавките и запитването за API."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Изпълнява кода."""
    if len(sys.argv) != 2:
        print('Использване: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API е върнало %s елемента', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s реда са записани в %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Опа! Резултатът от запитването не беше записан в файла. %s',
                         str(e))
    else:
        LOGGER.error('Опа! API запитването не беше успешно %s!', response)
За тестване на правилността на настройките и функционирането на агента, ще направим тестово стартиране на скрипта api_caller.py:
sudo ./api_caller.py TOKEN 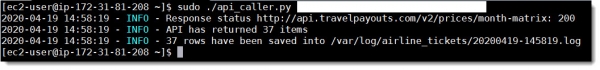
И проверяваме резултатите в логовете на Агента и на таба Мониторинг в потока данни airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 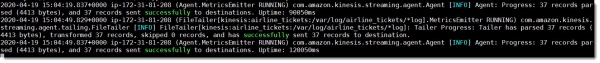
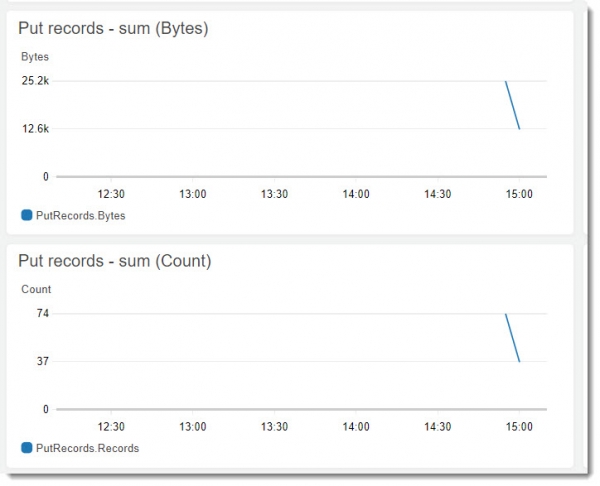
Както виждате, всичко работи и Kinesis Agent успешно изпраща данни в потока. Сега да настроим consumer.
Настройка на Kinesis Data Analytics
Да преминем към централния компонент на цялата система — създаване на ново приложение в Kinesis Data Analytics с име kinesis_analytics_airlines_app:
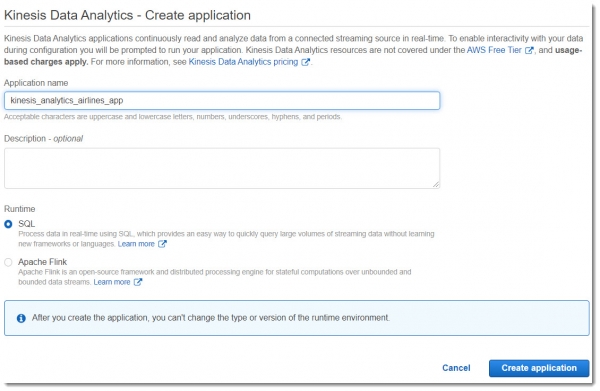
Kinesis Data Analytics позволява извършването на аналитика на данни в реално време от Kinesis Streams с помощта на SQL. Това е напълно автоматизирана услуга (в отличие от Kinesis Streams), която:
- позволява създаването на нови потоци (Output Stream) на базата на запитвания към изходните данни;
- предоставя поток с грешки, които са възникнали по време на работата на приложенията (Error Stream);
- умее автоматично да определя схемата на входните данни (може да се пренастройва ръчно при необходимост).
Тази услуга не е евтина — 0.11 USD на час работа, затова трябва да се използва внимателно и да се изтрива при приключване.
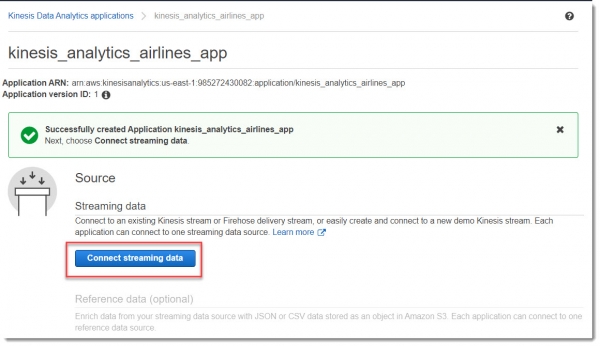
Свързваме приложението с източника на данни:
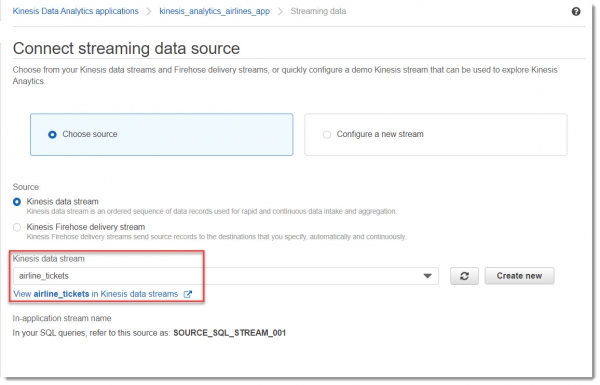
Избираме потока, с който искаме да се свържем (airline_tickets):
Следващата стъпка е да прикачим нова IAM роля, така че приложението да може да чете от потока и да записва в него. За целта е достатъчно да не променяме нищо в блока Access permissions:
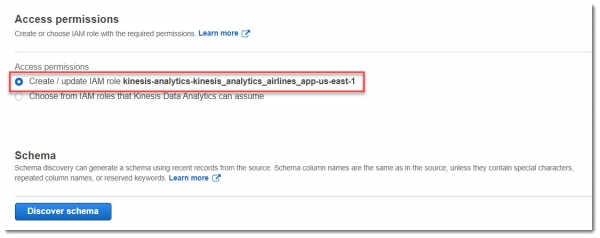
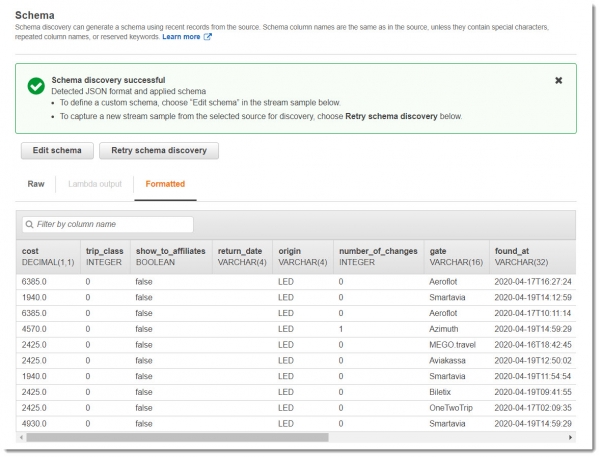
Сега ще искаме откриване на схемата на данните в потока, за целта натискаме бутона „Discover schema“. В резултат на това ще бъде обновена (създадена нова) IAM роля и ще стартира откритие на схемата от данните, които вече са постъпили в потока:
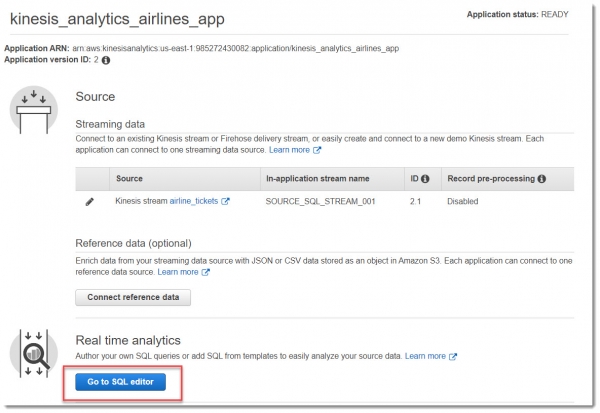
Сега е необходимо да преминем към редактора на SQL. Когато натиснете този бутон, ще се появи прозорец с въпрос за стартиране на приложението — избираме какво искаме да стартираме:
В прозореца на редактора на SQL поставяме следната проста заявка и натискаме Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
В релационните бази данни работите с таблици, използвайки оператори INSERT за добавяне на записи и оператор SELECT за запитване на данни. В Amazon Kinesis Data Analytics работите с потоци (STREAM) и „помпи“ (PUMP) — непрекъснати запитвания за вмъкване, които вмъкват данни от един поток в приложението в друг поток.
В представлената по-горе SQL заявка се търсят билети на Аерофлот с цена под пет хиляди рубли. Всички записи, отговарящи на тези условия, ще бъдат поставени в потока DESTINATION_SQL_STREAM.
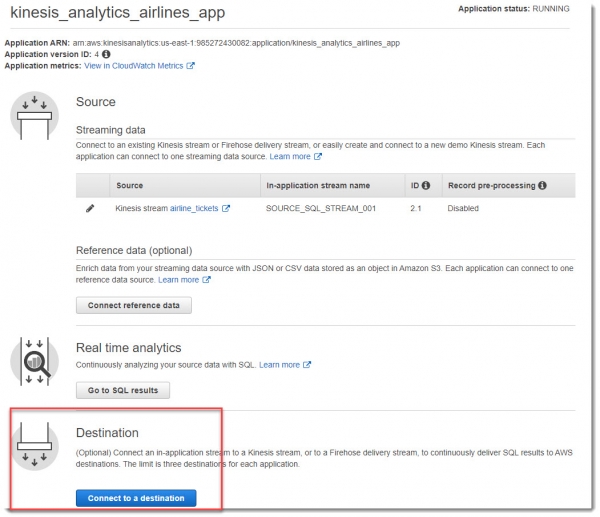
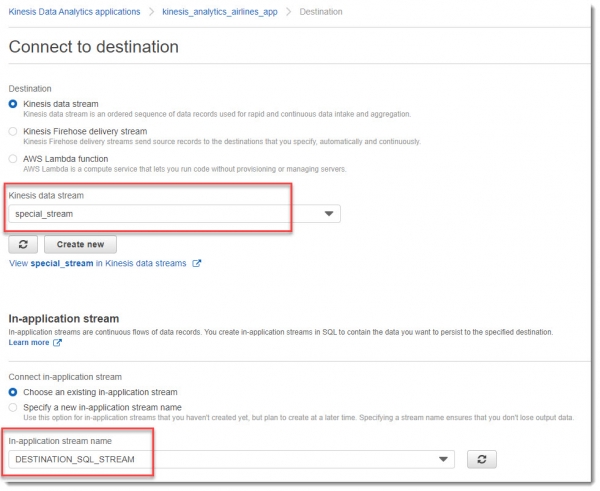
В блока Destination избираме потока special_stream, а в падащото меню In-application stream name DESTINATION_SQL_STREAM:
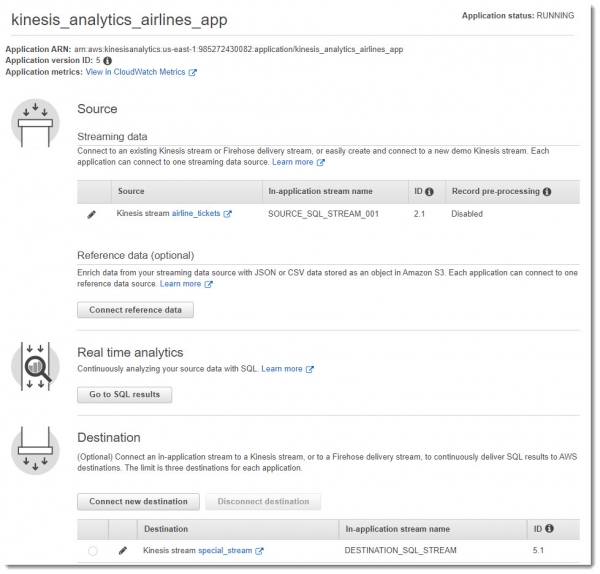
В резултат на всички манипулации трябва да получите нещо подобно на изображението по-долу:
Създаване и абониране за топик SNS
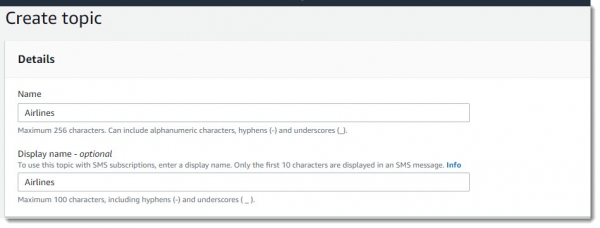
Преминаваме към услугата Simple Notification Service и създаваме нов топик с името Airlines:
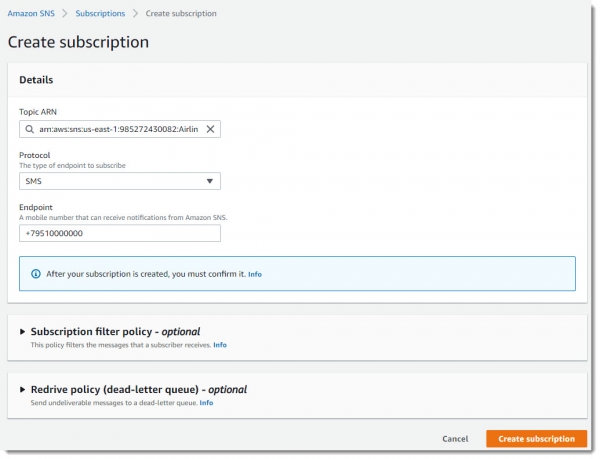
Създаваме абонамент за този топик, като посочваме номера на мобилния телефон, на който ще получаваме SMS известия:
Създаване на таблица в DynamoDB
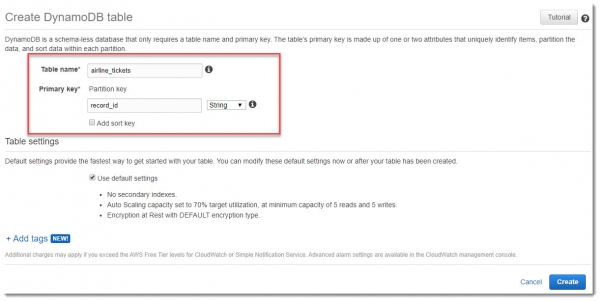
За съхранение на необработените данни от потока airline_tickets, ще създадем таблица в DynamoDB с идентично име. Като основен ключ ще използваме record_id:
Създаване на лямбда функция collector
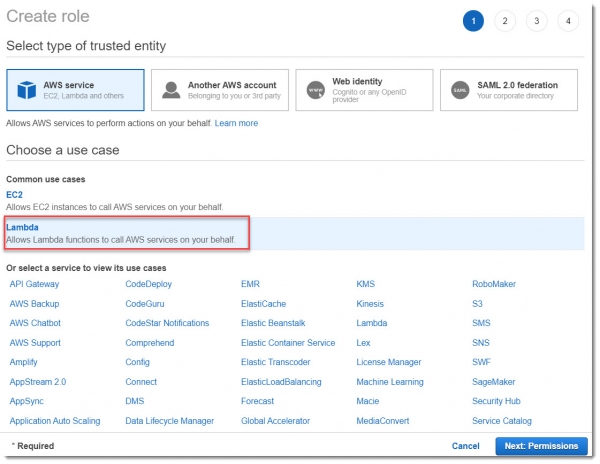
Ще създадем лямбда функция с наименование Collector, чиято задача ще бъде да опитва потока airline_tickets и, в случай на нови записи, да ги вмъква в таблицата DynamoDB. Очевидно е, че освен подразбиращите се права, тази лямбда трябва да има достъп за четене на потока Kinesis и писане в DynamoDB.
Създаване на IAM роля за лямбда функцията collector
Първо ще създадем нова IAM роля за лямбдата с наименование Lambda-TicketsProcessingRole:
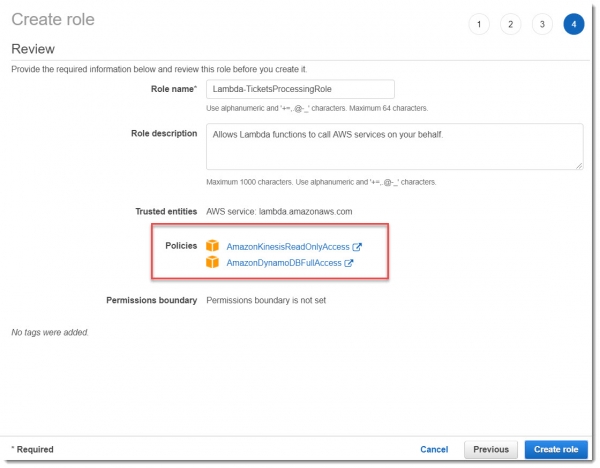
За тестовия пример напълно подхождат предварително настроените политически AmazonKinesisReadOnlyAccess и AmazonDynamoDBFullAccess, както е показано на изображението по-долу:
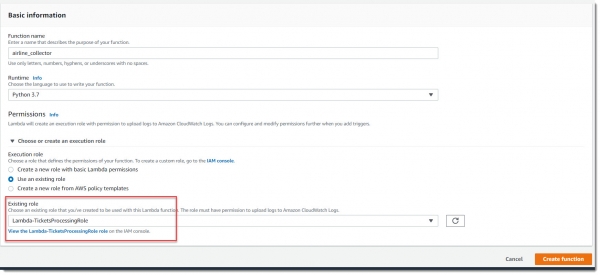
Тази лямбда трябва да се задейства от тригера на Kinesis при влизането на нови записи в потока airline_stream, затова трябва да добавим нов тригер:
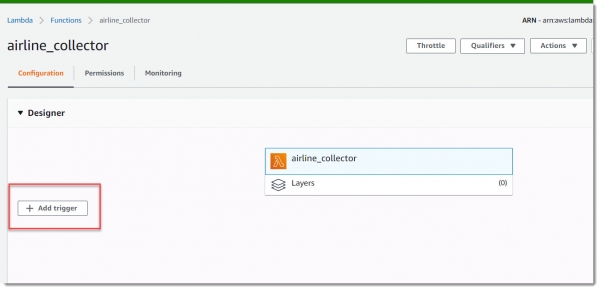
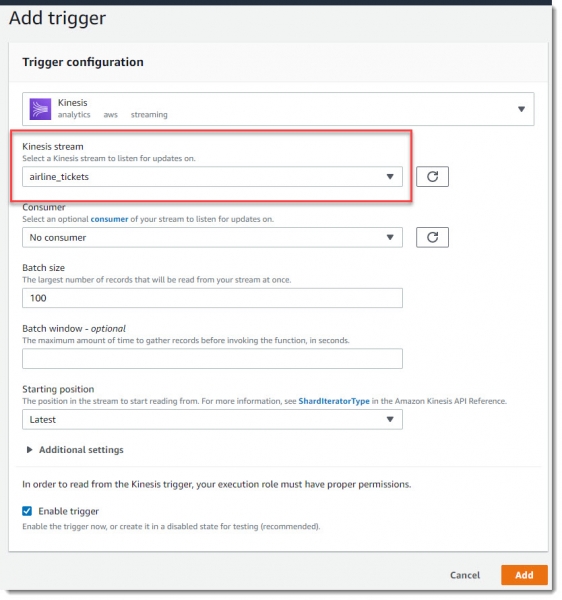
Остава да вставим кода и да запазим лямбдата.
"""Парсиране на потока и вмъкване в таблицата DynamoDB."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Парсиране на информация от потока."""

    def __init__(self, table_name, records):
        """Метод за инициализация."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Връща десериализирани данни от потока."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Предварителна обработка на json данните."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Партидно вмъкване в таблицата."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Добавени са ', len(self.json_data), 'артикула')

def lambda_handler(event, context):
    """Парсиране на потока и вмъкване в таблицата DynamoDB."""
    print('Получено събитие:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Създаване на лямбда-функция notifier
Втората лямбда-функция, която ще следи втория поток (special_stream) и ще изпраща уведомление в SNS, се създава аналогично. Следователно, тази лямбда трябва да има достъп за четене от Kinesis и да изпраща съобщения в зададения SNS-топик, който по-късно ще бъде изпратен от SNS на всички абонати на този топик (email, SMS и т.н.).
Създаване на IAM роля
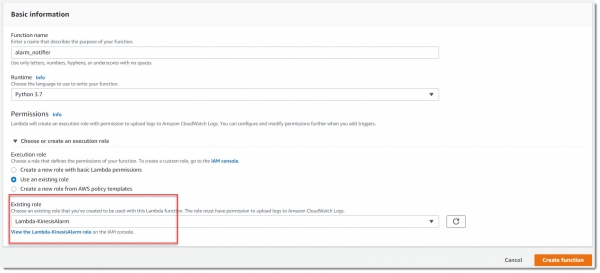
Първо създаваме IAM роля Lambda-KinesisAlarm за тази лямбда, а след това назначаваме тази роля на създаваната лямбда alarm_notifier:
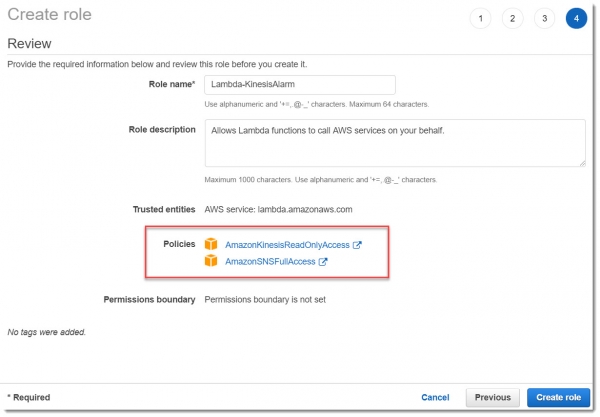
Тази лямбда трябва да работи по триггера за нови записи в потока special_stream, така че е необходимо да настроим триггера по аналогичен начин, както направихме за лямбда Collector.
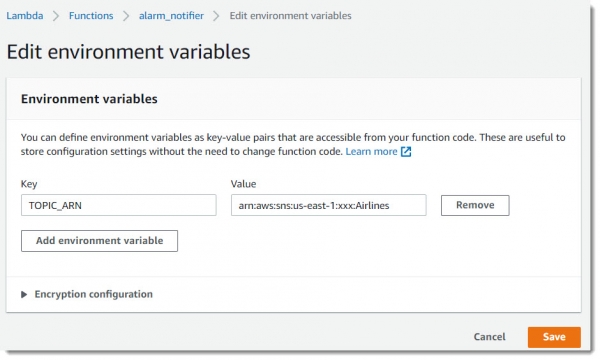
За удобство на настройката на тази лямбда, въвеждаме нова променлива на средата — TOPIC_ARN, където поставяме ANR (Amazon Resource Names) на топика Airlines:
И вмъкваме кода на лямбдата, който е доста прост:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Здравейте! Намерих интересна информация!',
                           Subject='Сигнализация за самолетни билети')
        print('Съобщението за сигнала е доставено успешно')
    except Exception as err:
        print('Неуспех при доставката', str(err))
Изглежда, че ръчната настройка на системата тук приключва. Остава само да тестваме и да се уверим, че всичко е настроено правилно.
Деплой от Terraform код
Необходима подготовка
— много удобен open-source инструмент за разгръщане на инфраструктура от код. Има собствен синтаксис, който лесно се усвоява и много примери как и какво да се разгръща. В редактора Atom или Visual Studio Code има много удобни плъгини, които улесняват работата с Terraform.
Дистрибуцията може да бъде изтеглена . Подробен анализ на всички възможности на Terraform излиза извън обхвата на тази статия, така че ще се ограничим до основните моменти.
Как да стартираме
Целият код на проекта се намира . Клонираме репозиторито. Преди стартиране е важно да се уверим, че AWS CLI е инсталирано и настроено, тъй като Terraform ще търси удостоверенията в файла ~\/ .aws\/credentials.
Добра практика преди разгръщането на цялата инфраструктура е да се стартира командата plan, за да видим какво ще създаде Terraform в облака:
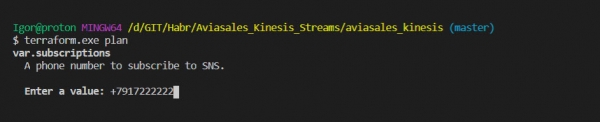
terraform.exe planЩе бъде поискано да въведете телефонен номер за получаване на уведомления. На този етап въвеждането му не е задължително.
След като анализирахме плана на програмата, можем да стартираме създаването на ресурсите:
terraform.exe applyСлед изпращането на тази команда отново ще се появи запитване за въвеждане на телефонен номер, натискаме „yes“, когато се покаже въпросът за реалното изпълнение на действията. Това ще позволи изграждането на цялата инфраструктура, извършването на необходимата конфигурация на EC2, разгръщането на lambda функции и т.н.
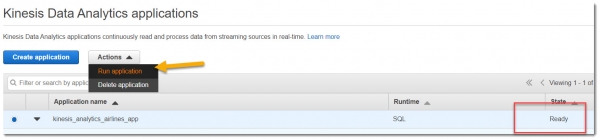
След като всички ресурси са успешно създадени чрез кода на Terraform, трябва да влезем в детайлите на приложението Kinesis Analytics (за съжаление, не успях да намеря как да го направя директно от кода).
Стартираме приложението:
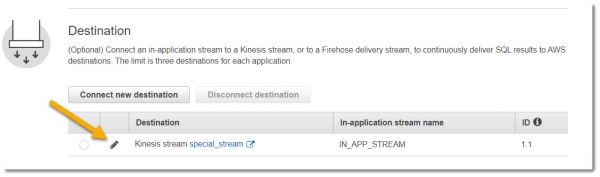
След това е необходимо явно да зададете името на потока в приложението, избирайки от падащото меню:
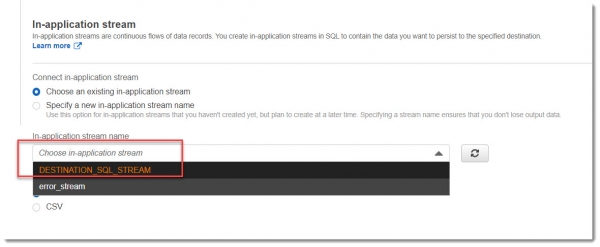
Сега всичко е готово за работа.
Тестване на работата на приложението
Независимо как сте разгръщали системата, ръчно или чрез код на Terraform, тя ще работи по един и същи начин.
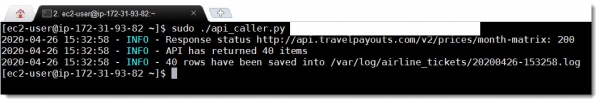
Свързваме се по SSH с виртуалната машина EC2, на която е инсталиран Kinesis Agent, и стартираме скрипта api_caller.py
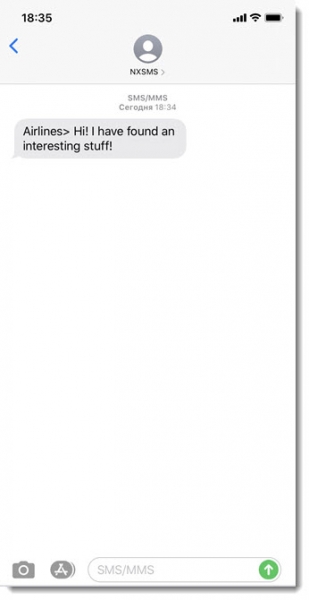
sudo ./api_caller.py TOKENТрябва да изчакате SMS на вашия номер:
SMS — съобщението идва на телефона практически за около 1 минута:
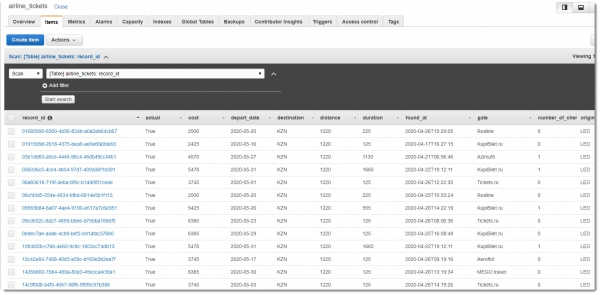
Остана да проверим дали записите са запазени в базата данни DynamoDB за последващ, по-подробен анализ. Таблицата airline_tickets съдържа приблизително следните данни:
Заключение
В хода на работата беше изградена система за онлайн обработка на данни на базата на Amazon Kinesis. Разгледахме варианти за използване на Kinesis Agent заедно с Kinesis Data Streams и реално време аналитика Kinesis Analytics с помощта на SQL команди, както и взаимодействието на Amazon Kinesis с други услуги на AWS.
Описаната по-горе система разполагаме по два начина: с относително дълга ръчна и бърза от кода Terraform.
Целият изходен код на проекта е достъпен , предлагам да се запознаете с него.
С удоволствие съм готов да обсъдим статията, очаквам вашите коментари. Надявам се на конструктивна критика.
Пожелавам успех!
Източник: habr.com
