

Тази история е за това как използваме контейнери в продуктова среда, особено под Kubernetes. Статията е посветена на събиране на метрики и логове от контейнерите, както и на изграждането на образи.
Ние сме от финтех компанията Exness, която разработва услуги за онлайн търговия и финтех продукти за B2B и B2C. В нашето R&D има много различни екипи, в отделя за разработка работят 100+ служители.
Представляваме екипа, който отговаря за платформата за събиране и изпълнение на код от нашите разработчици. По-специално, ние отговаряме за събиране, съхранение и предоставяне на метрики, логове и събития от приложенията. В момента оперираме с около три хиляди Docker контейнера в продуктова среда, поддържаме нашето big data хранилище с капацитет от 50TB и предоставяме архитектурни решения, които са изградени около нашата инфраструктура: Kubernetes, Rancher и различни публични облачни доставчици.
Нашата мотивация
Какво гори? Никой не може да отговори. Къде е огнището? Трудно е да се разбере. Кога е избухнало? Може да се установи, но не веднага.
Защо някои контейнери спират, а други се провалят? Кой контейнер е причина за това? Навън всичките контейнери изглеждат еднакви, но всеки има свой собствен Neo отвътре.
Нашите разработчици са компетентни специалисти. Те създават добри услуги, които носят печалба на компанията. Но понякога се случват проблеми, когато контейнерите с приложенията се разпръснат. Един контейнер консумира твърде много CPU, друг — мрежа, трети — операции за вход-изход, четвърти — изобщо не е ясно какво прави с сокетите. Всичко това се срива, а корабът потъва.
Агенти
За да разберем какво се случва вътре, решихме да инсталираме агенти директно в контейнерите.
Тези агенти са ограничителни програми, които поддържат контейнерите в такова състояние, че да не счупят помежду си. Агентизирането е стандартизирано, което позволява да се стандартизира подходът към обслужването на контейнерите.
В нашия случай агентите трябва да предоставят логове в стандартен формат, тагирани и с тротлинг. Също така, те трябва да предоставят стандартизирани метрики, разширяеми от гледна точка на бизнес приложенията.
Под агентите също се подразбират инструменти за експлоатация и поддръжка, които могат да работят в различни системи за оркестрация и да поддържат различни образи (Debian, Alpine, Centos и т.н.).
Накрая, агентите трябва да поддържат прост CI/CD, включващ Docker файлове. В противен случай корабът ще се разпадне, защото контейнерите ще започнат да се доставят по „криви“ релси.
Процес на изграждане и устройството на целевия image
За да бъде всичко стандартизирано и управлявано, е необходимо да се спазва някакъв стандартен процес на изграждане. Затова решихме да изграждаме контейнери с контейнери — такава рекурсия.
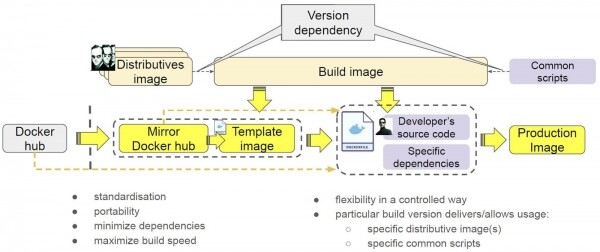
Тук контейнерите са представени с плътни контури. В същото време решихме да поставим в тях дистрибутиви, за да не изглежда „животът като малини“. Защо беше направено това, ще разкажем по-долу.
В резултат получихме инструмент за изграждане — контейнер на определена версия, който се отнася до определени версии на дистрибутиви и определени версии на скриптове.
Как го прилагаме? Имаме Docker Hub, в който се намира контейнер. Ние го огледаляме в нашата система, за да се избавим от външни зависимости. Получи се контейнер, обозначен с жълт цвят. Създаваме шаблон, за да инсталираме в контейнера всички необходими дистрибутиви и скриптове. След това изграждаме готов образ за експлоатация: разработчиците поставят в него код и свои специфични зависимости.
Какво е добро в този подход?
- На първо място, пълен контрол на версиите на инструментите за изграждане — контейнер за изграждане, версии на скриптове и дистрибутиви.
- На второ място, постигнахме стандартизация: създаваме шаблони, междинни и готови за експлоатация images по един и същ начин.
- На трето място, контейнерите осигуряват преносимост. Днес използваме Gitlab, а утре можем да преминем към TeamCity или Jenkins и по същия начин ще можем да стартираме нашите контейнери.
- На четвърто място, минимизация на зависимостите. Не е случайно, че поставихме дистрибутиви в контейнера, тъй като това позволява да не ги изтегляме всеки път от Интернет.
- На пето място, ускорена скорост на изграждане – наличието на локални копия на образите позволява да не губим време за изтегляне, тъй като вече имаме локален образ.
С други думи, постигнахме контролируем и гъвкав процес на изграждане. Използваме еднакви средства за изграждане на всякакви контейнери с пълно версиониране.
Как работи нашата процедура за изграждане
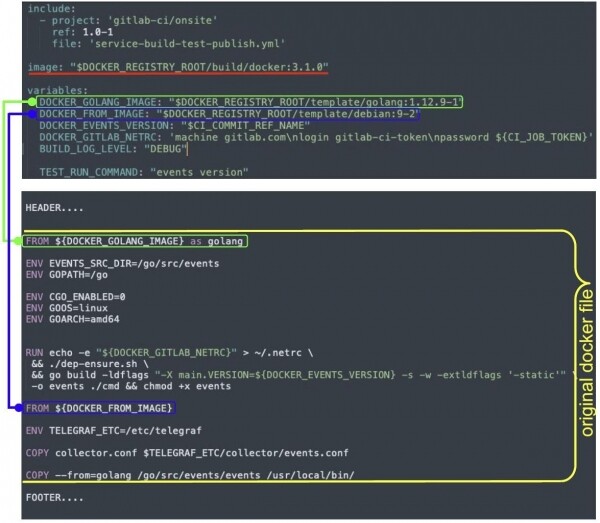
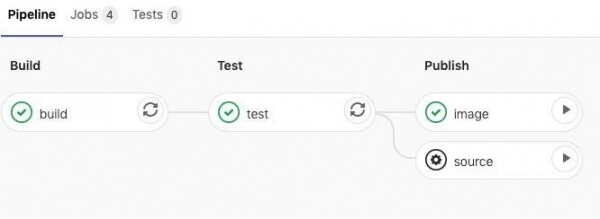
Сглобката се стартира с една команда, процесът се изпълнява в образ (отбелязан в червено). Разработчикът има Docker файл (отбелязан в жълто), ние го рендерим, заменяйки променливите със стойности. И в процеса добавяме хедъри и футъри – това са нашите агенти.
Хедърът добавя дистрибутиви от съответните образи. А футърът инсталира нашите услуги, настройва стартирането на работното натоварване, логването и други агенти, заменяйки entrypoint и т.н.
Дълго се чудехме дали да поставим супервайзор. Накрая решихме, че ни е нужен. Избрахме S6. Супервайзора осигурява управление на контейнера: позволява свързване в случай на срив на основния процес и осигурява ръчно управление на контейнера без повторно създаване. Логовете и метриките – това са процеси, изпълнявани в контейнера. Трябва да се контролират и тях, и ние правим това с помощта на супервайзора. Накрая, S6 поема извършването на housekeeping, обработка на сигнали и други задачи.
Тъй като използваме различни системи за оркестрация, след сглобяването и стартирането контейнерът трябва да разбере в каква среда се намира и да действа в зависимост от ситуацията. Например:
Това ни позволява да сглобим един образ и да го стартираме в различни системи за оркестрация, като стартирането ще се съобразява с особеностите на тази система за оркестрация.
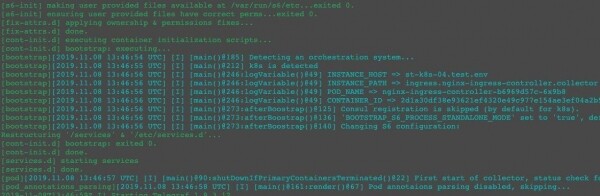
За един и същ контейнер получаваме различни процесни дървета в Docker и Kubernetes:
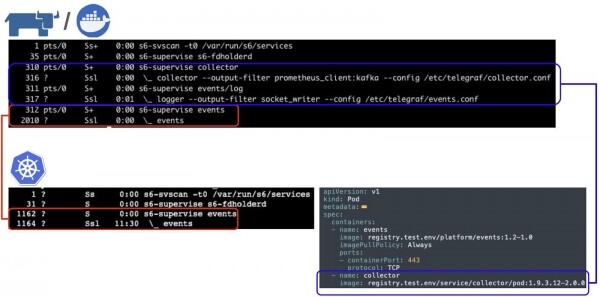
Полезният товар се изпълнява под супервайзора S6. Обърнете внимание на collector и events – това са нашите агенти, отговарящи за логовете и метриките. В Kubernetes ги няма, а в Docker ги има. Защо?
Ако погледнем спецификацията на "пода" (тук и по-нататък – Kubernetes pod), ще видим, че контейнерът events се изпълнява в пода, в който има отделен контейнер collector, изпълняващ функцията за събиране на метрики и логове. Можем да използваме възможностите на Kubernetes: стартиране на контейнери в един под, в единно процесно и/или мрежово пространство. Фактически, можем да интегрираме собствените си агенти и да изпълняваме определени функции. И ако този същият контейнер бъде стартиран в Docker, той ще получи всички същите възможности, т.е. ще може да доставя логове и метрики, тъй като агентите ще са активирани вътре.
Метрики и логове
Доставянето на метрики и логове – сложна задача. Свързани с решението ѝ са няколко аспекта.
Инфраструктура се създава за изпълнение на полезна работа, а не за масово доставяне на логове. Тоест, този процес трябва да се извършва с минимални изисквания към ресурсите на контейнерите. Стремим се да помогнем на нашите разработчици: «Вземете контейнер от Docker Hub, стартирайте го, и ние можем да доставим логовете».
Вторият аспект е ограничаването на обема на логовете. Ако в няколко контейнера възникне ситуация с увеличаване на обема на логовете (приложението в цикъл извежда stack-trace), се увеличава натоварването на CPU, комуникационните канали, системата за обработка на логове, и това влияе на работата на хоста като цяло и на другите контейнери на хоста, което понякога води до „падане“ на хоста.
Третият аспект е необходимо по подразбиране да се поддържат възможно най-много методи за събиране на метрики. От четене на файлове и опит на Prometheus-endpoint до използване на специфични приложения протоколи.
И последният аспект е необходимо да се минимизира консумацията на ресурси.
Избрахме open-source решение на Go, наречено Telegraf. Това е универсален конектор, който поддържа повече от 140 вида входни канали (input plugins) и 30 вида изходни (output plugins). Ние го подобрихме и сега ще разкажем как се използва при нас на примера на Kubernetes.
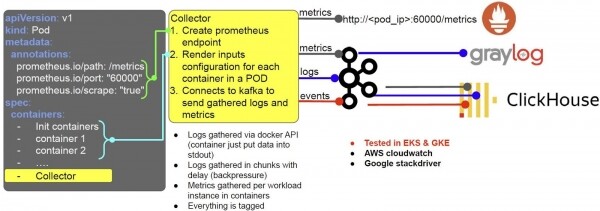
Да предположим, разработчик разгръща натоварване и Kubernetes получава заявка за създаване на под. В този момент за всеки под автоматично се създава контейнер с име Collector (използваме mutation webhook). Collector е нашият агент. При стартиране, този контейнер се настройва за работа с Prometheus и системата за събиране на логове.
- За това той използва анотации на пода, и в зависимост от съдържанието им, създава, да речем, крайна точка (end-point) на Prometheus;
- На базата на спецификацията на пода и специфичните настройки на контейнерите решава как да доставя логовете.
Логовете събираме чрез Docker API: на разработчиците е достатъчно да ги поставят в stdout или stderr, а след това Collector ще се справи. Логовете се събират на парчета с известна закъснение, за да се предотврати евентуално претоварване на хоста.
Метриките се събират по инстанции на работното натоварване (процеси) в контейнерите. Всичко се маркира с тагове: namespace, под и така нататък, а след това се конвертира във формат Prometheus – и става достъпно за събиране (освен логовете). Също така, логовете, метриките и събитията ги изпращаме в Kafka и нататък:
- Логовете са достъпни в Graylog (за визуален анализ);
- Логовете, метриките и събитията се изпращат в Clickhouse за дългосрочно съхранение.
По същия начин всичко работи в AWS, само че заменяме Graylog с Kafka с Cloudwatch. Изпращаме логовете там и всичко е много удобно: веднага е ясно на кой клъстер и контейнер принадлежат. Същото важи и за Google Stackdriver. Тоест, нашата схема работи както on-premise с Kafka, така и в облака.
Ако нямаме Kubernetes с подове, схемата става малко по-сложна, но работи по същите принципи.
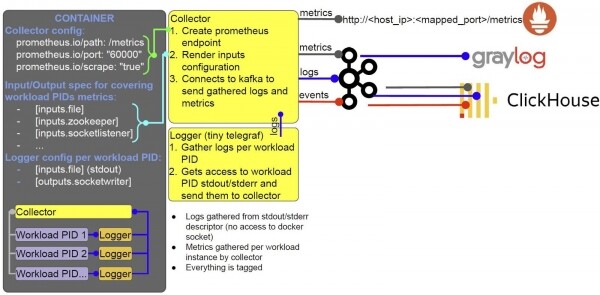
Вътре в контейнера се изпълняват същите процеси, които се оркестрират с помощта на S6. Всички същите процеси са стартирани в рамките на един контейнер.
В крайна сметка
Създадохме интегрирано решение за изграждане и стартиране на изображения в експлоатация, с опции за събиране и доставка на логове и метрики:
- Разработихме стандартизиран подход за изграждане на изображения, на базата на който създадохме CI шаблони;
- Агентите за събиране на данни са нашите разширения Telegraf. Доказахме, че работят добре в продукция;
- Прилагаме mutation webhook за внедряване на контейнери с агенти в подове;
- Интегрирахме се в екосистемата Kubernetes/Rancher;
- Можем да изпълняваме идентични контейнери в различни системи за оркестрация и да получаваме очаквания от нас резултат;
- Създадохме напълно динамична конфигурация за управление на контейнерите.
Съавтор: Иля Прудников
Източник: habr.com
