

Неотдавна се сблъсках с доста необичайна задача за настройка на маршрутизация за MetalLB. Всъщност, обикновено за MetalLB не са необходими допълнителни действия, но в нашия случай имаме доста голям клъстер с не особено сложна мрежова конфигурация.
В тази статия ще обясня как да настроите маршрутизация на базата на източника и политиката за външната мрежа на вашия клъстер.
Няма да се спирам подробно на инсталацията и настройката на MetalLB, тъй като предполагам, че вече имате известен опит. Предлагам да преминем направо към настройката на маршрутизацията. И така, имаме четири случая:
Случай 1: Когато настройката не е необходима
Нека проучим прост случай.
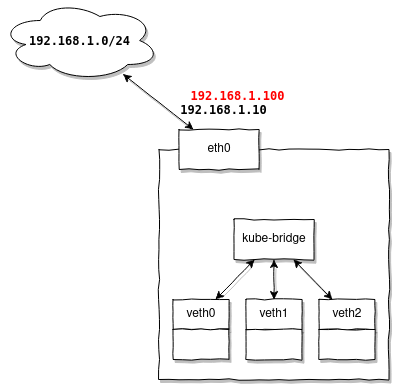
Допълнителна настройка на маршрутизацията не е необходима, когато адресите, предоставени от MetalLB, се намират в същата подсет, в която са адресите на вашите нодове.
Например, вие имате подсет 192.168.1.0/24, в която има рутер 192.168.1.1, и вашите нодове получават адреси: 192.168.1.10-30, така че за MetalLB можете да настроите диапазон 192.168.1.100-120 и да бъдете уверени, че те ще работят без никаква допълнителна настройка.
Защо е така? Защото вашите нодове вече имат настроени маршрути:
# ip route
default via 192.168.1.1 dev eth0 onlink
192.168.1.0/24 dev eth0 proto kernel scope link src 192.168.1.10
И адресите от същия диапазон ще ги повторно използват без никакви допълнителни действия.
Случай 2: Когато е необходима допълнителна настройка
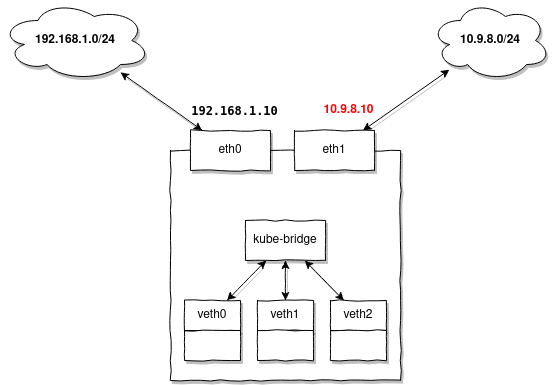
Трябва да настроите допълнителни маршрути всеки път, когато вашите нодове нямат настроен IP адреси или маршрут в подсетта, за която MetalLB предоставя адреси.
Нека обясня малко по-подробно. Всеки път, когато MetalLB предостави адрес, това може да се сравни с просто назначаване, например:
ip addr add 10.9.8.7/32 dev loОбърнете внимание на:
- a) Адресът се назначава с префикс
/32така че маршрутът за подсетта не се добавя автоматично (това е просто адрес) - b) Адресът се прикача към произволен интерфейс на нодата (например loopback). Тук е важно да спомена особеностите на мрежовия стек на Linux. Не е важно на кой интерфейс добавите адреса, ядрото винаги ще обработва arp-запитвания и ще изпраща arp-отговори на който и да е от тях, това поведение се счита за коректно и е доста широко използвано в динамична среда като Kubernetes.
Това поведение може да се конфигурира, например, чрез активиране на строг arp:
echo 1 > /proc/sys/net/ipv4/conf/all/arp_ignore
echo 2 > /proc/sys/net/ipv4/conf/all/arp_announce
В този случай arp-отговорите ще се изпращат само ако интерфейсът изрично съдържа конкретен IP адрес. Тази настройка е задължителна, ако планирате да използвате MetalLB и вашият kube-proxy работи в режим IPVS.
Въпреки това MetalLB не използва ядрото за обработка на arp заявки, а го прави самостоятелно в user-space, следователно тази опция няма да повлияе на работата на MetalLB.
Нека да се върнем към нашата задача. Ако маршрут за издадените адреси на вашите нодове не съществува, добавете го предварително на всички нодове:
ip route add 10.9.8.0/24 dev eth1Случай 3: Когато е необходимо source-based маршрутизиране
Source-based маршрутирането трябва да се настрои, когато получавате пакети през отделен gateway, различен от зададения по подразбиране, следователно отговорните пакети също трябва да преминат през същия gateway.
Например, имате същата подсет, 192.168.1.0/24 посветена на вашите нодове, но искате да издавате външни адреси с помощта на MetalLB. Нека приемем, че имате няколко адреса от подсет, 1.2.3.0/24 намиращи се във VLAN 100, и искате да ги използвате за достъп до Kubernetes услуги отвън.
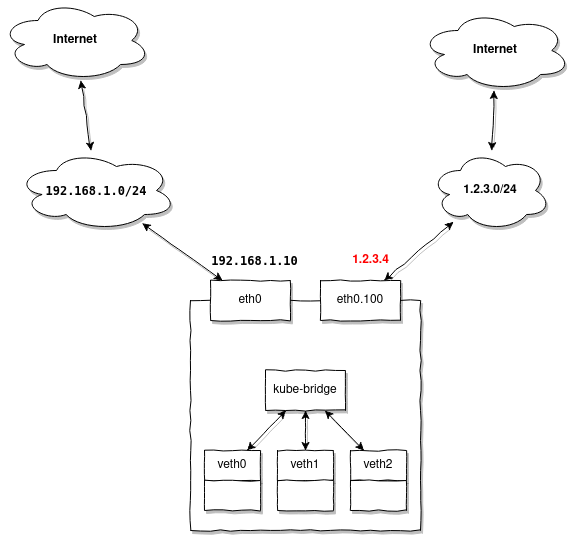
При обращение на 1.2.3.4 вие ще правите заявки от друга подсет, различна от 1.2.3.0/24 и да очаквате отговор. Нода, която в момента е майстор за издадения MetalLB адрес, 1.2.3.4, ще получи пакет от маршрутизатора 1.2.3.1, но отговорът за него задължително трябва да върви по същия маршрут, през 1.2.3.1.
Тъй като нашият нода вече има настроен default gateway, 192.168.1.1, по подразбиране отговорът ще отиде при него, а не при 1.2.3.1, през който получихме пакета.
Как да се справим с тази ситуация?
В този случай е необходимо да подготвите всички ваши нодове по такъв начин, че те да са готови да обслужват външни адреси без допълнителна настройка. Тоест за горния пример трябва предварително да създадете VLAN интерфейс на нодата:
ip link add link eth0 name eth0.100 type vlan id 100
ip link set eth0.100 up
След това добавете маршрути:
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Обърнете внимание, маршрути добавяме в отделна таблица за маршрутизиране, 100 тя ще съдържа само два маршрута, необходими за изпращане на отговорния пакет през gateway, 1.2.3.1, намиращ се зад интерфейса eth0.100.
Сега трябва да добавим просто правило:
ip rule add from 1.2.3.0/24 lookup 100което изрично казва: ако адресът на източника на пакета е в 1.2.3.0/24, трябва да се използва таблицата за маршрутизация 100. В него вече е описан маршрут, който ще го изпрати през 1.2.3.1
Случай 4: Когато е необходимо маршрутизиране на основата на политика
Топологията на мрежата е като в предишния пример, но да предположим, че искате също да имате възможност да се обръщате към външни адреси на пула 1.2.3.0/24 от вашите подове:
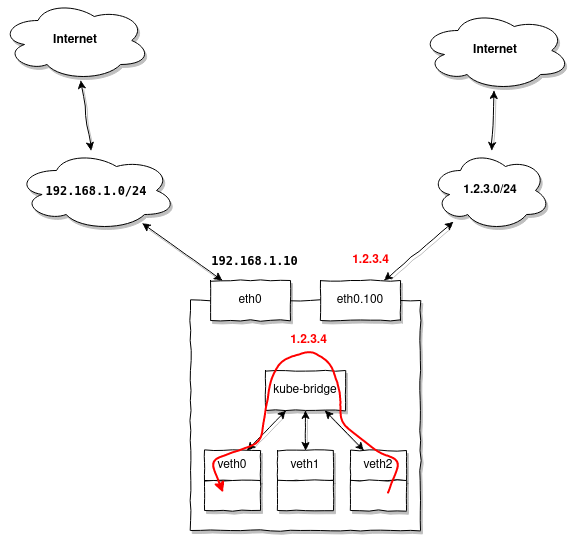
Особеността е, че при обръщение към който и да е адрес в 1.2.3.0/24, отговорният пакет попада на нода и има адрес на източника в диапазона 1.2.3.0/24 ще бъде изпратен в eth0.100, но ние искаме Kubernetes да го пренасочи към нашия първи под, който е генерирал оригиналната заявка.
Да разрешим този проблем се оказа трудно, но това стана възможно благодарение на маршрутизирането на основата на политика:
За по-добро разбиране на процеса, ще дам блок-схема на netfilter:
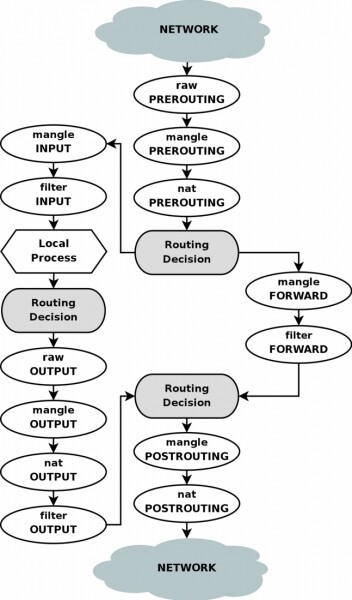
Първо, както в предишния пример, ще създадем допълнителна таблица за маршрутизиране:
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Сега ще добавим няколко правила в iptables:
iptables -t mangle -A PREROUTING -i eth0.100 -j CONNMARK --set-mark 0x100
iptables -t mangle -A PREROUTING  -j CONNMARK --restore-mark
iptables -t mangle -A PREROUTING -m mark ! --mark 0 -j RETURN
iptables -t mangle -A POSTROUTING -j CONNMARK --save-mark
Тези правила ще маркират входящите връзки на интерфейса eth0.100, маркирайки всички пакети с таг 0x100, с този същия таг ще бъдат маркирани и отговорите в рамките на едно свързване.
Сега можем да добавим правило за маршрутизиране:
ip rule add from 1.2.3.0/24 fwmark 0x100 lookup 100Тоест всички пакети с адрес на източника 1.2.3.0/24 и тага 0x100 трябва да бъдат маршрутизирани, използвайки таблицата 100.
По този начин другите пакети, получени на друг интерфейс, не попадат под това правило, което ще им позволи да бъдат маршрутизирани по стандартните средства на Kubernetes.
Има още нещо, но в Linux съществува така нареченият филтър за обратен път, който разваля всичко, като извършва прост контрол: за всички входящи пакети, той променя адреса на източника на пакета със адреса на подателя и проверява дали пакетът може да излезе през същия интерфейс, на който е получен; ако не може, той го филтрира.
Проблемът е, че в нашия случай той ще работи неправилно, но можем да го изключим:
echo 0 > /proc/sys/net/ipv4/conf/all/rp_filter
echo 0 > /proc/sys/net/ipv4/conf/eth0.100/rp_filter
Обърнете внимание, че първата команда контролира глобалното поведение на rp_filter; ако не бъде изключен, втората команда няма да има никакъв ефект. Въпреки това, останалите интерфейси ще останат с включен rp_filter.
За да не ограничаваме работата на филтъра напълно, можем да се възползваме от реализацията на rp_filter за netfilter. Използвайки rpfilter като модул на iptables, можем да настроим достатъчно гъвкави правила, например:
iptables -t raw -A PREROUTING -i eth0.100 -d 1.2.3.0/24 -j RETURN
iptables -t raw -A PREROUTING -i eth0.100 -m rpfilter --invert -j DROP
включи rp_filter на интерфейса eth0.100 за всички адреси, с изключение на 1.2.3.0/24.
Източник: habr.com
