

Здравейте, наскоро ми попадна интересна задача да настроя хранилище за архивиране на голямо количество блочни устройства.
Всяка седмица правим резервно копие на всички виртуални машини в нашето облако, така че е нужно да можем да обслужваме хиляди резервни копия и да правим това максимално бързо и ефективно.
За съжаление стандартните конфигурации RAID5, RAID6 в този случай няма да ни подхождат, тъй като процесът на възстановяване на толкова големи дискове като нашите ще бъде мъчително дълъг и вероятно няма да приключи никога.
Нека разгледаме какви алтернативи има:
— Аналог на RAID5 и RAID6, но с настройваемо ниво на четност. При това резервирането се изпълнява не на блокове, а за всеки обект поотделно. Най-простият начин да пробвате erasure coding е да развернете .
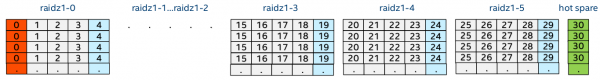
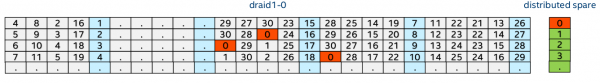
— това е все още неиздадената възможност на ZFS. В отличие от RAIDZ, DRAID има разпределен parity block и при възстановяване включва веднага всички дискове от масива, благодарение на което по-добре оцеляват от откази и по-бързо се възстановяват след срив.
На разположение имам сървър Fujitsu Primergy RX300 S7 с процесор Intel Xeon CPU E5-2650L 0 @ 1.80GHz, девет плочки оперативна памет Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), дискова кутия Supermicro SuperChassis 847E26-RJBOD1, свързана чрез Dual LSI SAS2X36 Expander и 45 диска Seagage ST6000NM0115-1YZ110 по 6TB всеки.
Преди да решим нещо, първо трябва да тестваме всичко подобаващо.
За целта се подготвих и проведох тестове на различни конфигурации. За това използвах minio, който служеше като S3-бекенд и го стартирах в различни режими с различен брой цели.
Основно тестваната беше ситуацията minio в erasure coding срещу софтуерен RAID с едно и също количество дискове и parity дискове, а именно: RAID6, RAIDZ2 и DRAID2.
За справка: когато стартирате minio с един-единствен таргет, то minio работи в режим на S3-шлюз, предоставяйки вашата локална файлова система като S3-хранилище. В случай, че стартирате minio с указание за няколко таргета, автоматично ще се включи режим Erasure Coding, който ще разпространява данните между вашите таргети с предоставяне на отказоустойчивост.
По подразбиране minio разделя таргетите на групи от 16 диска, като за всяка група се падат по 2 parity. Т.е. едновременно могат да излязат от строя два диска без загуба на данни.
За тестване на производителността използвах 16 диска по 6TB всеки и записвах на тях малки обекти с размер 1MB, което максимално точно описваше нашето бъдещо натоварване, тъй като всички съвременни инструменти за бекъп разделят данните на блокове от няколко мегабайта и ги записват по този начин.
За провеждане на бенчмарка използвах утилитата s3bench, която се стартира на отдалечен сървър и изпраща на minio десетки хиляди такива обекти в стотици потоци. След което по същия начин се опитваше да ги запита обратно.
Резултатите от бенчмарка са представени в следната таблица:
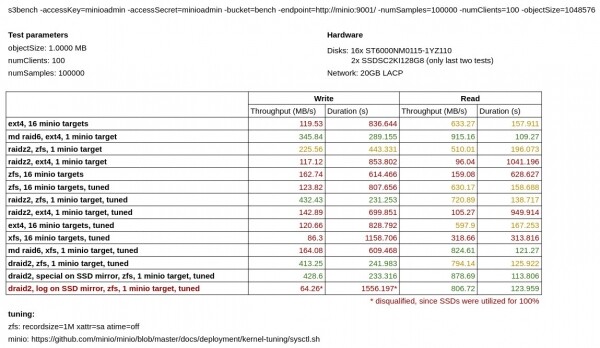
Както виждаме, minio в режима на собствен erasure coding работи значително по-зле на запис, отколкото minio, стартиран върху софтуерен RAID6, RAIDZ2 и DRAID2 в същата конфигурация.
Отделно, мен да тествам minio на ext4 срещу XFS. Удивително, но за моя тип натоварване XFS се оказа значително по-бавен от ext4.
В първия порция тестове Mdadm показа превъзходство над ZFS, но по-късно , че може да се подобри производителността на ZFS, установявайки следните опции:
xattr=sa atime=off recordsize=1Mи след това тестовете с ZFS станаха значително по-добри.
Също така може да се забележи, че DRAID не дава особено преимущество в производителността пред RAIDZ, но теоретично трябва да бъде много по-безопасен.
В последните два теста също така се опитах да изнеса метаданните (special) и ZIL (log) на огледало от SSD. Но изнасянето на метаданните не доведе до значително подобрение в скоростта на запис, а при изнасяне на ZIL моите се натъкнаха на таван с 100% утилизация, така че смятам, че този тест се провали. Не изключвам, че ако имах по-бързи SSD дискове, може би това би могло значително да подобри моите резултати, но за съжаление, не разполагах с тях.
В крайна сметка реших да се спра на използването на DRAID и макар да има бета статус, той е най-бързото и ефективно решение за съхранение в нашия случай.
Създадох прост DRAID2 в конфигурация с три групи и две distributed spares:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Добре, с хранилището се разбрахме, сега за това с какво ще правим бекъп. Тук веднага искам да разкажа за три решения, които успях да опитам, а именно:
— клон , специализирано решение за резервно копиране на блочни устройства, има тясна интеграция с Ceph. Умее да взима разлики между снимки и да формира инкрементални резервни копия от тях. Поддържа голямо количество бекенди за съхранение, сред които локален и S3. Изисква отделна база данни за съхранение на хеш таблица за дедупликация. От недостатъците: написан е на python и има малко неотзивчивен cli.
— клон , отдавна известно и доказано средство за резервно копиране, умее да резервира данни и добре дедуплицира. Умее да съхранява резервни копия както локално, така и на отдалечен сървър посредством scp. Умее да резервира блочни устройства, ако е пуснат с флага --special, от недостатъците: при създаване на резервно копие, репозиторият напълно се блокира, затова за всяка виртуалка се препоръчва да се създаде отделен репозиторий, в принцип това не е проблем, тъй като се създават много лесно.
— активно развиващ се проект, написан на go, достатъчно бърз и поддържа голямо количество бекенди за съхранение, сред които има както локално хранилище, така и scp, S3 и много други. Особено искам да отбележа, че има специално създаден за restic, който позволява най-бързо да експортира хранилище за използване отдалеч. От всички изброени, ми хареса най-много. Умее да резервира от stdin. Почти няма забележими недостатъци, но има няколко особености:
На първо място, опитах да го използвам в режим на общ репозиторий за всички виртуалки (като Benji) и това работеше дори добре, но операциите по възстановяване отнемаха доста време, тъй като всеки път преди възстановяването restic се опитва да прочете метаданните на всички резервни копия. Тази проблема лесно се реши, както и при borg, с създаването на отделен репозиторий за всяка виртуалка. Този подход се оказа ефективен и за управлението на резервните копия. Изолираните репозитории могат да имат отделна парола за достъп до данните, както и можем да не се боим, че глобалният репо може някак си да се развали. Създаването на нови репозитории става също толкова лесно, колкото и при borg backup.
Във всеки случай дедупликацията се извършва само спрямо предишната версия на резервното копие, като предишното резервно копие се определя по пътя за посоченото резервно копие, така че ако архивирате различни обекти от stdin в общо хранилище, не забравяйте да посочите опцията
--stdin-filename, или явно всеки път да указвате опцията--parent.
На второ място, възстановяването в stdout отнема значително повече време, отколкото възстановяването на файловата система, поради своята паралелност. В бъдеще се планира добавяне на по-тясна поддръжка за резервни копия за блочни устройства.
На трето място, в момента се препоръчва да се използва , тъй като версия 0.9.6 има бъг с бавно възстановяване на големи файлове.
За да тествам ефективността на резервното копие и скоростта на записване / възстановяване от резервно копие, създадох отделно хранилище и пробвах да направя архив на малък образ на виртуална машина (21 GB). Извърших две резервни копия без промяна на оригинала, използвайки всяко от изброените решения, за да проверя колко по-бързо / бавно се копират дедуплицираните данни.
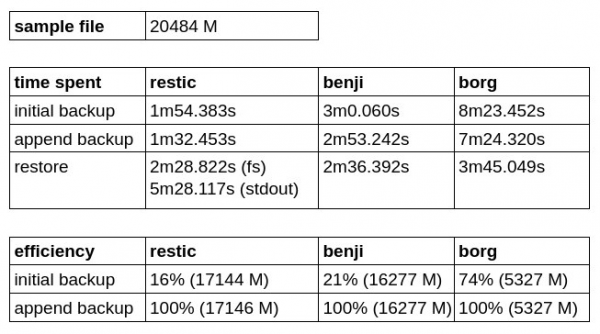
Както можем да забележим, Borg Backup има най-добър коефициент на ефективност при първоначалното резервно копие, но изостава по скорост както на записа, така и на възстановяването.
Restic се оказа по-бърз от Benji Backup, но възстановява в stdout по-бавно, а за съжаление в момента не може да пише директно в блочно устройство.
След като претеглих всичко за и против, реших да се спра на restic с rest-server като най-удобното и перспективно решение за резервно копие.
В този скрийнкаст можете да видите как 10-гигабитен канал се използва изцяло при няколко едновременни операции по резервно копие. Струва си да се отбележи, че използването на дискове не надвишава 30%.
Полученото решение ме задоволи повече от всякога!
Източник: habr.com
