

Алоха, пипл! Меня зовут Олег Анастасьев, работя в Одноклассниках в команде Платформы. Освен мен, в Одноклассниках работят множество съоръжения. Имаме четири дата центъра с около 500 рафта, които съдържат над 8000 сървъра. В един момент осъзнахме, че внедряването на нова система за управление ще ни позволи по-ефективно да натоварим техниката, да улесним управлението на достъпа, да автоматизираме (преразпределението на) изчислителните ресурси, да ускорим стартирането на нови услуги и да засилим реакцията при мащабни инциденти.
Какво стана от това?
Освен мен и многото съоръжения, има и хора, които работят с тях: инженери, които са на място в дата центровете; мрежови специалисти, които настройват мрежовото оборудване; администратори, или SRE, които осигуряват устойчивостта на инфраструктурата; и екипи от разработчици, всеки от които отговаря за част от функциите на портала. Създаденият от тях софтуер работи по следния начин:
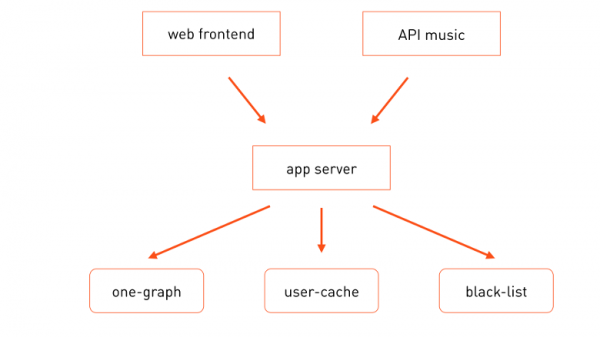
Запитванията на потребителите постъпват както на фронтовете на основния портал , така и на други, например на фронтовете на API музиката. За обработка на бизнес логиката те извикват сървъра на приложенията, който при обработката на заявката извиква необходимите специализирани микросервиси — one-graph (граф на социалните връзки), user-cache (кеш на потребителските профили) и т.н.
Всяка от тези услуги е внедрена на множество машини, и всяка от тях има отговорни разработчици, които отговарят за функционирането на модулите, тяхната експлоатация и технологичното им развитие. Всички тези услуги се стартират на физически сървъри, и до неотдавна ние стартирахме точно по една задача на един сървър, т.е. той беше специализиран за конкретна задача.
Защо така? Този подход имаше няколко предимства:
- Улеснява масовото управление. Да кажем, задачата изисква някои библиотеки, определени настройки. Тогава сървърът се приписва точно на една определена група, описва се политика cfengine за тази група (или тя вече е описана), и тази конфигурация централизирано и автоматично се разгръща на всички сървъри от тази група.
- Упрощава диагностиката. Да предположим, че наблюдавате увеличено натоварване на централния процесор и осъзнавате, че това натоварване може да е генерирано единствено от задачата, която работи на този хардуер. Търсенето на виновника приключва много бързо.
- Упрощава мониторинг. Ако нещо не е наред със сървера, мониторът уведомява за това и вие със сигурност знаете кой е виновен.
На услугата, състояща се от няколко реплики, се разпределят няколко сървера — по един за всяка. Тогава ресурсите за услугата се разпределят много просто: колкото сървера има услугата, толкова ресурси може максимално да потреби. "Просто" тук не е в смисъл, че е лесно за използване, а в това, че разпределението на ресурсите се извършва ръчно.
Този подход също ни позволява да създадем специализирани хардуерни конфигурации за задачата, изпълняваща се на този сървер. Ако задачата съхранява големи обеми данни, използваме 4U сървър с шаси на 38 диска. Ако задачата е чисто изчислителна, можем да закупим по-евтин 1U сървър. Това е ефективно от гледна точка на изчислителните ресурси. Такъв подход ни позволява да използваме четири пъти по-малко машини при натоварване, сравнимо с едно познато ни социално мрежа.
Тази ефективност на използване на изчислителните ресурси трябва да осигури и икономическа ефективност, ако се приемат за основа предпоставките, че най-скъпото са сърверите. Дълго време най-скъпо беше именно хардуерът, и вложихме много усилия за намаляване на цената на хардуера, измисляйки алгоритми за осигуряване на устойчивост за намаляване на изискванията за надеждност на оборудването. Днес вече сме достигнали етап, в който цената на сървера спря да бъде определяща. Освен ако не разглеждаме най-новите екзотики, конкретната конфигурация на сърверите в рафта вече не е от значение. В момента имаме друг проблем — цената на заеманото от сървера място в дата центъра, т.е. мястото в рафта.
Осъзнавайки, че е така, решихме да изчислим колко ефективно използваме рафтовете.
Взехме цената на най-мощния сървър от икономически оправданите, изчислихме колко такива сървъри можем да поберем в стелажите, колко задачи бихме стартирали на тях, основавайки се на старата схема "един сървър = една задача" и до каква степен тези задачи биха могли да използват оборудването. Изчислихме — просълзихме се. Оказа се, че ефективността на използване на стелажите ни е около 11 %. Заключението е очевидно: необходимо е да се повиши ефективността на използването на дата центровете. Би било логично решението да е очевидно: трябва да стартираме няколко задачи на един сървър. Но тук започват сложностите.
Масовата конфигурация рязко се усложнява — вече е невъзможно да се назначи на сървъра някаква конкретна група. Тъй като на един сървър могат да бъдат стартирани няколко задачи от различни екипи. Освен това, конфигурацията може да е конфликтна за различни приложения. Диагностиката също се усложнява: ако виждате повишено потребление на процесори или дискове на сървъра, не знаете коя от задачите причинява проблема.
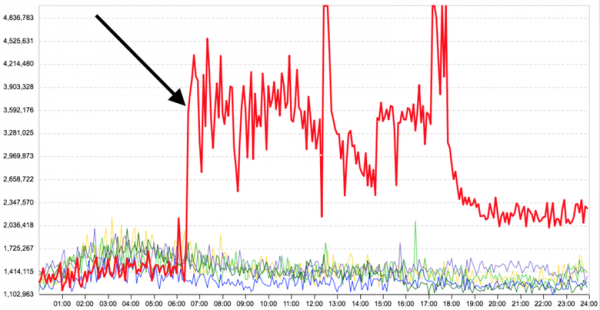
Но най-важното е, че между задачите, стартирани на една и съща машина, няма изолация. Например, графикът на средното време за отговор на сървърната задача преди и след стартирането на свързано с нея калкулационно приложение — времето за отговор на основната задача силно се увеличава.
Очевидно, трябва да стартираме задачи или в контейнери, или във виртуални машини. Тъй като почти всички наши задачи се стартират под управлението на една ОС (Linux) или са адаптирани за нея, поддържането на множество различни операционни системи не е необходимо. Следователно, виртуализация не е нужна, поради допълнителните разходи тя ще бъде по-малко ефективна от контейнеризацията.
Като реализация на контейнери за стартиране на задачи директно на сървърите, Docker е добър кандидат: образите на файловите системи решават успешно проблемите с конфликтните конфигурации. Това, че образите могат да се съставят от няколко слоя, ни позволява значително да намалим обема на данните, необходими за тяхното внедряване в инфраструктурата, като отделяме общите части в отделни основни слоеве. Тогава основните (и най-обемни) слоеве ще бъдат кеширани достатъчно бързо в цялата инфраструктура и за доставката на множество различни типове приложения и версии ще е необходимо да предаваме само малки по обем слоеве.
В допълнение, готовият регистър и таговете на образите в Docker ни предоставят готови примитиви за версиониране и доставка на код в продукция.
Docker, подобно на всяка друга подобна технология, предоставя известен ниво на изолация на контейнерите от кутията. Например, изолация по памет — на всеки контейнер се задава лимит на използване на паметта на машината, над който той не може да потребява. Също така е възможно да се изолират контейнерите по употреба на CPU. Въпреки това, стандартната изолация не беше достатъчна за нас. Но за това по-долу.
Директното стартиране на контейнери на сървърите е само част от проблемите. Другата част е свързана с разполагането на контейнерите на сървърите. Необходимо е да разберем кой контейнер може да бъде разположен на кой сървър. Това не е толкова проста задача, защото контейнерите трябва да бъдат разположени на сървърите възможно най-плътно, без да се намалява скоростта на тяхната работа. Такова разполагане може да бъде сложно и от гледна точка на устойчивост на откази. Често искаме да разполагаме реплики на един и същ сервис в различни шкафове или дори в различни зали на дата центъра, за да не загубим всички реплики на сервиса при отказ на шкаф или зала.
Разпределянето на контейнерите ръчно не е вариант, когато имаш 8000 сървъра и 8000–16000 контейнера.
Освен това искахме да дадем на разработчиците повече самостоятелност в разпределянето на ресурсите, така че те да могат сами да разполагат своите услуги в продукция, без помощта на администратор. В същото време искахме да запазим контрол, така че някакъв второстепенен сервис да не изразходва всички ресурси на нашите дата центрове.
Очевидно е, че е необходим управляващ слой, който да се грижи за това автоматично.
Ето ни, стигнахме до проста и ясна картина, която всички архитекти обичат: три квадратчета.
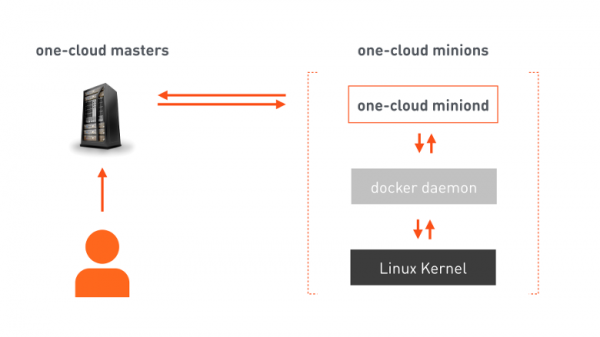
one-cloud masters — отказоустойчив клъстер, отговорен за оркестрация на облака. Разработчикът изпраща в майстора манифест, в който е съдържа цялата необходима информация за разполагане на услугата. Майсторът на основата на него дава команди на избраните миньони (машини, предназначени за стартиране на контейнери). На миньоните е нашият агент, който получава команда, отдава вече своите команди на Docker, а Docker конфигурира ядрото на Linux за стартиране на съответния контейнер. Освен изпълнението на командите, агентът постоянно уведомява майстора за промените в състоянието както на машината-миньон, така и на стартираните върху нея контейнери.
Разпределение на ресурсите
Сега нека разгледаме задачата за по-сложно разпределение на ресурсите за множество миньони.
Изчислителен ресурс в one-cloud — това е:
- Изчислителната мощност на процесора, потребявана от конкретна задача.
- Обемът на паметта, наличен на задачата.
- Мрежов трафик. Всеки от миньоните има конкретен мрежови интерфейс с ограничена пропускна способност, затова не може да се разпределят задачи, без да се вземе предвид обема на данните, предавани по мрежата.
- Дискове. Освен, очевидно, мястото за данни на задачата, ние също така предлагаме тип диска: HDD или SSD. Дискът може да обслужва ограничено количество заявки в секунда — IOPS. Затова за задачи, генериращи повече IOPS, отколкото може да обслужи един диск, ние също така предлагаме „шпиндели“ — т.е. дискови устройства, които трябва да бъдат изцяло резервирани за задачата.
Така, за някаква услуга, например за user-cache, можем да запишем потребяваните ресурси по следния начин: 400 процесорни ядра, 2,5 TB памет, 50 Gbps трафик в двете посоки, 6 TB място на HDD, разположен на 100 шпиндела. Или в по-познатата форма за нас така:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Ресурсите на услугата user-cache консумират само част от всички налични ресурси в продукционната инфраструктура. Затова искаме да направим така, че внезапно, поради грешка на оператора или не, user-cache да не потреби повече ресурси, отколкото са му предвидени. Тоест, трябва да лимитираме ресурсите. Но към какво бихме могли да привържем квотата?
Нека се върнем към нашата значително опростена схема на взаимодействие между компонентите и да я прерисуваме с повече детайли — така:
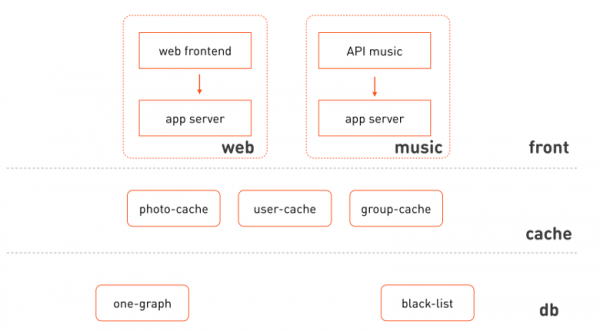
Какво привлича вниманието:
- Уеб фронтендът и музиката използват изолирани клъстери на един и същ сървър на приложения.
- Можем да идентифицираме логическите слоеве, към които принадлежат тези клъстери: фронтове, кешове, слой за съхранение и управление на данни.
- Фронтендът не е хомогенен, това са различни функционални подсистеми.
- Кешовете също могат да бъдат разпределени по подсистемата, данните от която кешират.
Още веднъж прерисуваме картината:
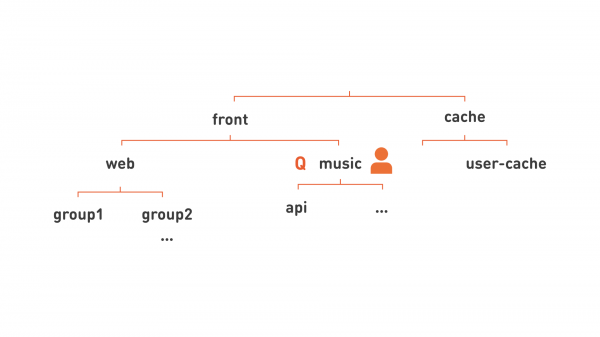
О, виждаме йерархия! А това означава, че можем да разпределим ресурсите по-големи части: да назначим отговорен разработчик за възел на тази йерархия, съответстващ на функционалната подсистема (като "music" на картинката), и да свържем квота с този същия ниво на йерархията. Такава йерархия също ни позволява по-гъвкаво да организираме услугите за удобство на управлението. Например, всички web, тъй като това е много голяма група от сървъри, подразделяме на няколко по-малки групи, показани на картинката като group1, group2.
Премахвайки излишните линии, можем да запишем всеки възел на нашата картинка в по-плосък вид: group1.web.front, api.music.front, user-cache.cache.
Така стигаме до понятието "йерархична опашка". Тя има име, като "group1.web.front". Назначава се квота за ресурси и права на потребителите. На човек от DevOps ще дадем права за изпращане на услугата в опашката, а такъв служител може да стартира нещо в опашката, а на човек от OpsDev — администраторски права, и сега той може да управлява опашката, да назначава хора там, да дава на тези хора права и т.н. Услугите, които се стартират в тази опашка, ще се изпълняват в рамките на квотата на опашката. Ако квотата за изчисление на опашката не е достатъчна за едновременното изпълнение на всички услуги, те ще се изпълняват последователно, формирайки по този начин самата опашка.
Нека да разгледаме услугите по-подробно. Услугата има пълно име, което винаги включва името на опашката. Тогава услугата на уеб фронта ще има име ok-web.group1.web.front. А услугата на сървъра на приложения, на която тя се обръща, ще се нарича ok-app.group1.web.front. Все услуги имат манифест, в който е описана цялата необходима информация за разполагане на конкретни машини: колко ресурси изисква тази задача, каква конфигурация е необходима за нея, колко реплики трябва да има, свойства за обработка на отказите на тази услуга. И след разполагането на услугата директно на машините се появяват нейните инстанции. Те също се именуват еднозначно — като номер на инстанцията и име на услугата: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Това е много удобно: гледайки само името на стартирания контейнер, можем веднага да разберем много.
А сега по-близо ще се запознаем с това, какви задачи всъщност изпълняват тези инстанции.
Класове на изолация на задачите
Всички задачи в ОК (да речем, навсякъде) могат да бъдат разделени на групи:
- Задачи с кратко забавяне — prod. За такива задачи и услуги е много важно забавянето на отговора (latency), колко бързо всяка от заявките ще бъде обработена от системата. Примери за задачи: уеб фронтове, кешове, приложения, OLTP хранилища и т.н.
- Изчислителни задачи — batch. Тук скоростта на обработка на всяка конкретна заявка не е важна. За тях е важно колко изчисления общо зададена задача ще направи за определен (голям) период от време (throughput). Такива ще бъдат всякакви задачи MapReduce, Hadoop, машинно обучение, статистика.
- Фонови задачи — idle. За такива задачи не е важно нито latency, нито throughput. Те включват различни тестове, миграции, преизчисления, конвертиране на данни от един формат в друг. От една страна, те са подобни на изчислителните, от друга — не ни интересува как бързо ще завършат.
Нека видим как такива задачи консумират ресурси, например, централния процесор.
Задачи с кратко забавяне. За такава задача, моделът на потребление на ЦП ще изглежда подобно на това:
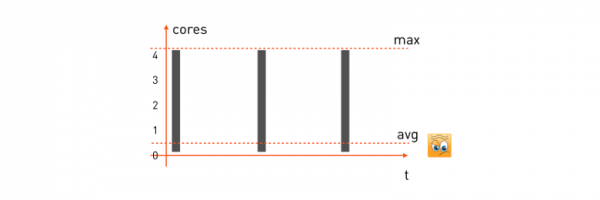
Постъпва заявка от потребител, задачата започва да използва всички налични ядра на ЦП, обработва, връща отговор, чака следващата заявка и спира. Поступва следваща заявка — отново е избрала всички налични ресурси, обработила е, чакаме следващата.
За да гарантираме минимално забавяне за такава задача, трябва да вземем максималното потребление на ресурси и да резервираме необходимия брой ядра на миньона (машината, която ще извършва задачата). Тогава формулата за резервация за нашата задача ще бъде такава:
alloc: cpu = 4 (max)Ако разполагаме с миньон машина с 16 ядра, можем да разместим точно четири такива задачи на нея. Важно е да отбележим, че средното потребление на процесора за такива задачи е често много ниско — което е очевидно, тъй като значителна част от времето задачата е в очакване на запитване и не прави нищо.
Изчислителни задачи. При тях моделът ще бъде малко по-различен:
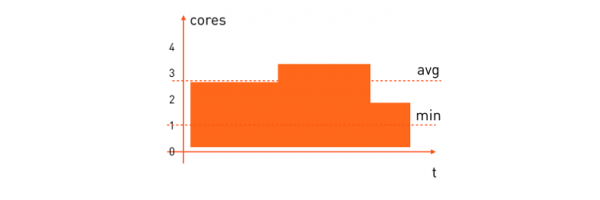
Средното потребление на ресурси от процесора за такива задачи е доста високо. Често искаме изчислителната задача да бъде изпълнена в определено време, затова е необходимо да резервираме минималното количество процесори, което е нужно, за да завърши цялото изчисление в приемливо време. Формулата за резервиране ще изглежда така:
alloc: cpu = [1,*)«Моля, разположете на миньона, където има поне едно свободно ядро, а останалите колкото има — всичко ще вземе.»
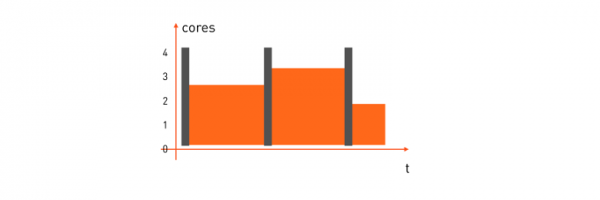
Тук ефективността на използване вече е значително по-добра в сравнение с задачите с кратко забавяне. Но печалбата ще бъде много по-голяма, ако комбинираме двата типа задачи на една машина-миньон и разпределяме ресурсите ѝ на момента. Когато задачата с кратко забавяне изисква процесор — тя го получава веднага, а когато ресурсите вече не са нужни — те се предават на изчислителната задача, т.е. нещо като:
Но как да го направя?
Първо, нека разгледаме prod и неговото alloc: cpu = 4. Трябва да резервираме четири ядра. В Docker run това може да се направи по два начина:
- Чрез опцията
--cpuset=1-4, т.е. да зададем четири определени ядра на машината за задачата. - Да използваме
--cpuquota=400_000 --cpuperiod=100_000, да зададем квота за процессорно време, т.е. да кажем, че на всеки 100 мс реално време задачата не консумира повече от 400 мс процессорно време. Получаваме същите четири ядра.
Но кой от тези методи ще бъде подходящ?
Доста привлекателен изглежда cpuset. При задачата с четири специализирани ядра, кешовете на процесора ще работят максимално ефективно. Има и обратна страна: ще трябва да поемем отговорността за разпределението на изчисленията между незаетите ядра на машината вместо ОС, което е доста не тривиална задача, особено ако опитаме да разположим батч задачи на такава машина. Тестовете показаха, че тук по-добре подхожда вариант с квотата: така операционната система има повече свобода при избора на ядро за изпълнение на задачата в текущия момент и времето на процесора се разпределя по-ефективно.
Нека да разгледаме как в Docker да направим резервиране по минимален брой ядра. Квотата за батч задачи вече не е приложима, защото не е нужно да ограничаваме максимума, достатъчно е да гарантираме минималното. И тук добре подхожда опцията docker run --cpushares.
Договорихме се, че ако батчът изисква гаранция за минимум едно ядро, то указваме --cpushares=1024, а ако е минимално за две ядра, то указваме --cpushares=2048. Cpu shares не намесват в разпределението на времето на процесора, стига да е достатъчно. Така, ако prod в момента не използва всичките си четири ядра - нищо не ограничава батч задачите и те могат да използват допълнителното време на процесора. В ситуация на недостиг на процесор, ако prod е изразходвал всичките си четири ядра и е достигнал квотата - оставащото време на процесора ще бъде разпределено пропорционално на cpushares, т.е. в ситуация с три свободни ядра, едно ще получи задача с 1024 cpushares, а другите две - задача с 2048 cpushares.
Но използването на квота и shares не е достатъчно. Трябва да направим така, че задачата с кратко закъснение да получава приоритет пред батч задачата при разпределението на времето на процесора. Без такова приоритизиране, батч задачата ще отнеме всичкото време на процесора в момента, когато е необходимо на prod. В Docker run няма опции за приоритизиране на контейнерите, но на помощ идват политиките на планировщика на централния процесор в Linux. Подробно за тях може да се прочете , а в рамките на тази статия ще ги разгледаме накратко:
- SCHED_OTHER
По подразбиране получават всички обикновени потребителски процеси на Linux машина. - SCHED_BATCH
Предназначена за ресурсно интензивни процеси. При поставяне на задача в процесора се активира така наречената глобална такса: такава задача с по-ниска вероятност ще получи ресурси от процесора, ако в момента той е зает от задача с SCHED_OTHER - SCHED_IDLE
Фонов процес с много нисък приоритет, дори под nice –19. Използваме нашата библиотека с отворен код , за да зададем необходимата политика при стартиране на контейнера с повикването
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Но дори и ако не програмирате на Java, същото може да се направи с командата chrt:
chrt -i 0 $pidНека обединим всичките ни нива на изолация в една таблица за по-добра визуализация:
Клас на изолацията
Пример alloc
Опции Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Ако правите chrt от вътре в контейнера, може да се нуждаете от capability sys_nice, защото по подразбиране Docker отнема този capability при стартиране на контейнера.
Но задачите консумират не само процесор, но и трафик, който влияе на закъснението на мрежовата задача дори повече от неправилно разпределение на ресурсите на процесора. Следователно, естествено, искаме да получим същата картина и за трафика. Тоест, когато prod-задачата изпраща пакети в мрежата, ние квотируем максималната скорост (формула alloc: lan=[*,500mbps) ), с която prod може да го прави. А за batch ние гарантираме само минимална пропускна способност, но не ограничаваме максималната (формула alloc: lan=[10Mbps,*) ) При това трафикът на prod трябва да има приоритет пред batch-задачите.
Тук Docker няма никакви примитиви, които можем да използваме. Но на помощ ни идва . Успяхме да постигнем желания резултат с помощта на дисциплината . С нея выделяме два класa трафик: високоприоритетен prod и нископриоритетен batch/idle. В крайна сметка конфигурацията за изходящия трафик изглежда така:
тук 1:0 — «коренова qdisc» на дисциплините hsfc; 1:1 — дъщерен клас hsfc с общ лимит на пропускна способност от 8 Gbit/s, под който са поставени дъщерните класове на всички контейнери; 1:2 — дъщерен клас hsfc общ за всички batch и idle задачи с «динамичен» лимит, за който ще говорим по-долу. Останалите дъщерни класове hsfc са резервирани класове за текущо работещи prod-контейнери с лимити, съответстващи на техните манифести — 450 и 400 Mbit/s. На всеки клас hsfc е зададена qdisc опашка fq или fq_codel, в зависимост от версията на ядрото на linux, за да се избегнат загуби на пакети при натрупвания на трафик.
Обикновено дисциплините tc служат само за приоритизиране на изходящия трафик. Но ние искаме да приоритизираме и входящия трафик — в крайна сметка, някоя batch-задача може лесно да заема цялата входяща линия, като получава, например, голям пакет входни данни за map&reduce. За тази цел използваме модула , който създава виртуален интерфейс ifbX за всеки мрежов интерфейс и пренасочва входящия трафик от интерфейса в изходящия на ifbX. След това за ifbX работят всички същите дисциплини за контрол на изходящия трафик, за който конфигурацията на hsfc ще бъде много подобна:
В хода на експериментите установихме, че най-добрите резултати hsfc показва тогава, когато клас 1:2 на неприоритетен batch/idle трафик е ограничен на миньоните до не повече от определена свободна лента. В противен случай неприоритетният трафик твърде много влияе на закъснението на prod-задачите. Текущата стойност на свободната лента miniond определя всяка секунда, измервайки средното потребление на трафик от всички prod-задачи в този миньон  и изваждайки я от пропускната способност на мрежовия интерфейс
 с малък запас, т.е.

Лентите се определят независимо за входящ и изходящ трафик. И в съответствие с новите стойности miniond преконфигурира лимита на неприоритетния клас 1:2.
По този начин реализирахме трите класа изолация: prod, batch и idle. Тези класове оказват значително влияние върху характеристиките на изпълнението на задачите. Затова решихме да поставим този признак на върха на йерархията, за да е ясно какво точно имаме предвид при поглед на името на йерархичната опашка:
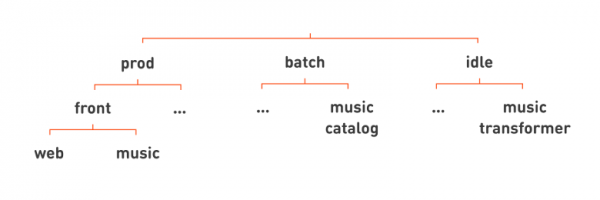
Всички наши познати web и music фронтове тогава се поставят в йерархията под prod. За пример под batch нека поставим услугата music catalog, който периодично съставя каталог на тракове от набор с mp3 файлове, качени в „Одноклассники“. Пример за услуга, работеща в режим idle, може да бъде music transformer, нормализираща нивото на звука на музиката.
Отново, след като премахнем излишните линии, можем да запишем имената на нашите услуги по-плоско, добавяйки класа на изолация на задачата в края на пълното име на услугата: web.front.prod, catalog.music.batch, transformer.music.idle.
И сега, гледайки името на услугата, разбираме не само каква функция изпълнява, но и нейния клас на изолация, а следователно и критичността й и т.н.
Всичко е прекрасно, но има една горчива истина. Пълен изолация на задачите, работещи на една машина, е невъзможна.
Какво успяхме да постигнем: ако batch интензивно консумира само ресурси на процесора, то вграденото CPU планиране в Linux се справя много добре със задачата си, и влиянието върху prod задачата е почти никакво. Но ако тази batch задача започне активно да работи с паметта, взаимното влияние вече се проявява. Това се случва, защото „изтичат“ кешовете на паметта на prod задачата — в резултат на което увеличава промахите в кеша и процесорът обработва prod задачата по-бавно. Такава batch задача може да увеличи закъснението на нашия типичен prod контейнер с 10%.
Изолирането на трафика е още по-сложно, защото съвременните мрежови карти имат вътрешна опашка за пакети. Ако пакетът от batch задачата попадне там първи, значи той ще бъде предаден по кабела първи, и тук нищо не може да се направи.
Също така, досега успяхме да решим само задачата с приоритизиране на TCP трафика: подходът с hsfc не работи за UDP. И дори в случая с TCP трафика, ако batch задача генерира много трафик, това също дава около 10% увеличение на закъснението на prod задачата.
Отказоустойчивост
Една от целите при разработването на one-cloud беше да подобри отказоустойчивостта на Одноклассники. Затова по-нататък бих искал по-подробно да разгледам възможни сценарии на откази и аварии. Нека започнем с прост сценарий — отказ на контейнера.
Контейнерът сам по себе си може да откаже по няколко начина. Това може да бъде някакъв експеримент, грешка или бъг в манифеста, поради което prod-задачата започва да консумира повече ресурси, отколкото е посочено в манифеста. Имахме случай: разработчикът реализира един сложен алгоритъм, много пъти го преработваше, сам се заплете и в крайна сметка задачата се зацикли доста неочаквано. Тъй като prod-задачата е с по-висок приоритет от всички останали на същите миньони, тя започна да консумира всички налични ресурси на процесора. В тази ситуация ни спаси изолацията, а именно квотата за процесорно време. Ако на задачата е определена квота, тя не може да консумира повече. Затова batch- и други prod-задачи, които работеха на същата машина, не забелязаха нищо.
Втората възможна неприятност е падането на контейнера. И тук ни спасяват политиките за рестарт, всички ги знаят, Docker сам се справя отлично. Практически всички prod-задачи имат политика за рестарт always. Понякога използваме on_failure за batch-задачи или за отстраняване на грешки в prod-контейнерите.
Какво можем да направим при недостъпност на целия миньон?
Очевидно, можем да стартираме контейнера на друга машина. Най-интересното тук е какво става с IP адреса (адресите), назначени на контейнера.
Можем да назначаваме на контейнерите същите IP адреси, каквито имат машините-миньони, на които тези контейнери се стартират. Тогава при стартиране на контейнера на друга машина неговият IP адрес се променя и всички клиенти трябва да разберат, че контейнерът е преместен, и сега трябва да се свързват на друг адрес, което изисква отделен сервиз Service Discovery.
Service Discovery е удобно. На пазара има много решения с различна степен на отказоустойчивост за организиране на регистър на услуги. Често в такива решения се реализира логика на балансировчика на натоварването, съхранение на допълнителна конфигурация под формата на KV-съхранение и т.н.
Обаче, бихме желали да се минем без необходимостта от внедряване на отделен регистър, тъй като това ще означава въвеждане на критична система, която се използва от всички услуги в производство. А значи, това е потенциална точка на отказ, и трябва да изберем или разработим много отказоустойчиво решение, което очевидно е много трудно, дълго и скъпо.
И още един голям недостатък: за да работи нашата стара инфраструктура с новата, ще трябва да пренапишем абсолютно всички задачи, за да използваме някаква система за откриване на услуги. Работата е изключително много, а на места — до невъзможност, когато става въпрос за ниско ниво на устройства, които работят на ниво ядрото на ОС или директно с хардуера. Реализирането на тази функционалност с помощта на утвърдени шаблони за решения, като например бихме добавили на места допълнителна натовареност, на места — усложняване на експлоатацията и допълнителни сценарии на отказ. Не искахме да усложняваме, затова решихме да направим използването на откритие на услуги опционално.
В one-cloud IP следва контейнера, т.е. всеки екземпляр на задачата има свой собствен IP адрес. Този адрес е "статичен": той се закриля за всеки екземпляр в момента на първото изпращане на услугата в облака. Ако по време на живота на услугата е имало различен брой екземпляри — в крайна сметка за нея ще бъдат закрити толкова IP адреси, колкото са били максимално екземплярите.
Впоследствие тези адреси не се променят: те са присвоени веднъж и съществуват през целия живот на услугата в продукция. IP адресите следват контейнерите през мрежата. Ако контейнерът бъде пренесен на друг миньон, то адресът ще премине заедно с него.
По този начин съпоставянето на името на услугата със списъка на нейните IP адреси се променя много рядко. Ако отново погледнем имената на екземплярите на услугата, които споменахме в началото на статията (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), ще забележим, че те наподобяват FQDN, използвани в DNS. И така е, за да се покажат имената на екземплярите на услугите в техните IP адреси, използваме DNS протокола. Като това DNS връща всички резервирани IP адреси на всички контейнери — както работещи, така и спряни (да речем, използват се три реплики, а ние имаме пет резервирани адреса — всички пет ще се върнат). Клиентите, получавайки тази информация, ще се опитат да установят връзка с всичките пет реплики — и по този начин ще определят тези, които работят. Този вариант за определяне на достъпността е значително по-надежден, в него не участват нито DNS, нито Service Discovery, а следователно, няма и трудно решавани задачи с осигуряване на актуалността на информацията и отказоустойчивостта на тези системи. Освен това, в критичните услуги, от които зависи работата на целия портал, можем да не използваме DNS изобщо, а просто да запишем IP адресите в конфигурацията.
Реализацията на такова прехвърляне на IP за контейнерите може да бъде нетривиална — и ще се спрем на това как работи, на следващия пример:
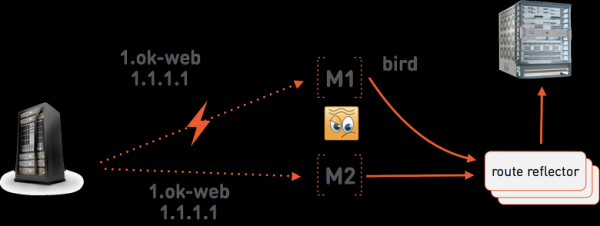
Да предположим, че one-cloud майсторът дава команда на миньона M1 да стартира 1.ok-web.group1.web.front.prod с адрес 1.1.1.1. На миньона работи , който анонсира този адрес в специални сървъри . Последните имат BGP сесия с мрежовото устройство, в което се транслира маршрутът на адрес 1.1.1.1 към M1. M1 маршрутизира пакетите вътре в контейнера с помощта на Linux. Сървърите route reflector са три, тъй като това е много критична част от инфраструктурата one-cloud — без тях мрежата в one-cloud няма да работи. Ние ги разполагаме в различни стелажи, по възможност разположени в различни зали на дата центъра, за да намалим вероятността от едновременен отказ на всичките три.
Нека сега предположим, че връзката между майстора one-cloud и миньона M1 е прекъснала. Майсторът one-cloud сега ще действа, основавайки се на предположението, че M1 е отказал напълно. Тоест ще даде команда на миньона M2 да стартира web.group1.web.front.prod с адреса 1.1.1.1. Сега имаме два конфликтиращи маршрута в мрежата за 1.1.1.1: на М1 и на М2. За да разрешим такива конфликти, използваме Multi Exit Discriminator, който се посочва в BGP обявлението. Това е число, което показва тежестта на обявения маршрут. От конфликтуващите ще бъде избран маршрутът с по-ниска стойност на MED. Мастер one-cloud поддържа MED като интегрална част от IP адресите на контейнерите. При първото изписване адресът се задава с достатъчно голям MED = 1 000 000. В ситуация на аварийно прехвърляне на контейнера, майсторът намалява MED, и М2 вече получава команда да обяви адреса 1.1.1.1 с MED = 999 999. Инстанцията, работеща на M1, остава без връзка и бъдещето й ни интересува само до възстановяване на връзката с майстора, когато тя ще бъде спряна като стар дубликат.
Аварии
Всички системи за управление на дата центрове винаги адекватно обработват малки откази. Изход на контейнер е норма почти навсякъде.
Нека да разгледаме как обработваме авария, например отказ на захранването в една или повече зали на дата центъра.
Какво означава авария за системата за управление на дата центъра? Първо, това е масивен едновременен отказ на множество машини, и системата за управление трябва да мигрира много контейнер едновременно. Но ако аварията е много мащабна, може да се случи така, че всички задачи не могат да бъдат преразпределени на другите миниони, защото ресурсната вместимост на дата центъра пада под 100% натоварване.
Често аварии съпътстват отказ на управляващия слой. Това може да се случи поради повреда на неговото оборудване, но по-често поради това, че аварии не се тестват, и управляващият слой сам пада от увеличеното натоварване.
Какво може да се направи с всичко това?
Масови миграции означават, че в инфраструктурата възниква голямо количество действия, миграции и разполагания. Всяка от миграциите може да отнеме известно време, необходимо за доставка и разопаковане на образите на контейнерите до минионите, стартиране и инициализация на контейнерите и т.н. Следователно е желателно по-важните задачи да се стартират преди по-малко важните.
Нека отново погледнем познатата ни йерархия на услугите и се опитаме да решим кои задачи искаме да стартираме първо.
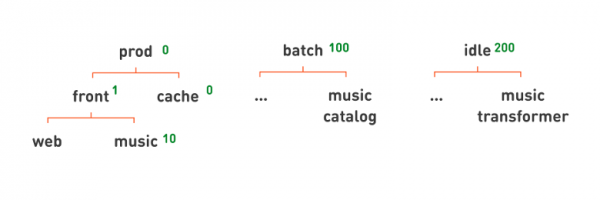
Разбира се, това са процесите, които пряко участват в обработката на потребителските заявки, т.е. prod. Указваме това с помощта на приоритет на разполагане — число, което може да бъде назначено на опашка. Ако дадена опашка има по-висок приоритет, нейните услуги се разполагат първо.
На prod назначаваме по-високи приоритети, 0; на batch — малко по-ниски, 100; на idle — още по-ниски, 200. Приоритетите се прилагат йерархично. Всички задачи по-долу в йерархията ще имат съответен приоритет. Ако искаме кешовете в prod да се стартират преди фронтендите, назначаваме приоритети на кеш = 0 и на фронт подопашки = 1. Ако например искаме основният портал да се стартира първи от фронтовете, а музикалният фронт след него, можем да зададем по-нисък приоритет на последния — 10.
Следващият проблем е недостигът на ресурси. И така, имаме много отказали устройства, цели зали на дата центъра, а сме пуснали толкова много услуги, че сега не стигат ресурси за всички. Трябва да решим с какви задачи да се лишим, за да работят основните критични услуги.
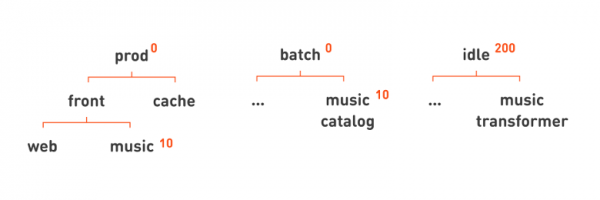
В отличие от приоритета на разполагане, не можем просто да жертваме всички batch задачи; някои от тях са важни за работата на портала. Поради това отделихме приоритет на вытесняване на задачите. При разполагането задача с по-висок приоритет може да вытесни, т.е. да спре задача с по-нисък приоритет, ако няма свободни миньони. При това задача с нисък приоритет вероятно ще остане неразположена, т.е. за нея вече няма подходящ миньон с достатъчно свободни ресурси.
В нашата йерархия е много лесно да зададем такъв приоритет на вытесняване, че prod и batch задачи да вытесняват или спират idle задачи, но не и помежду си, като зададем на idle приоритет 200. Също както и в случая с приоритета на разполагане, можем да използваме нашата йерархия, за да опишем по-сложни правила. Например, можем да зададем, че на функцията музика жертваме, ако ни липсват ресурси за основния уеб портал, като зададем по-нисък приоритет на съответните възли: 10.
Проблеми с ДЦ цялостно
Защо може да се провали целият дата център? Стихии. Имаше добър пост как Стихията може да се определи от бездомниците, които веднъж запалиха оптика в колектора, и дата центърът напълно изгуби свръзка с останалите площадки. Причината за неизправността понякога може да бъде и човешкият фактор: операторът може да издаде команда, която да доведе до срив на целия дата център. Такова нещо може да се случи заради сериозна грешка. Общо взето, дата центровете падат — това не е рядкост. При нас това става на всеки няколко месеца.
И ето какво правим, за да никой #окживи да не поства в Туитър.
Първата стратегия е изолация. Всеки инстанс на one-cloud е изолиран и може да управлява машините само в един дата център. Тоест, загубата на облака заради грешки или неправилна команда на оператор е загуба само на един дата център. Ние сме подготвени за това: имаме политика за резервиране, при която реплики на приложения и данни се разполагат във всички дата центрове. Използваме отказоустойчиви бази данни и периодично тестваме откази.
Тъй като днес разполагаме с четири дата центъра, имаме и четири отделни, напълно изолирани инстанции на one-cloud.
Този подход не само че защитава от физически отказ, но може да защити и от грешки на операторите.
А какво друго може да се направи с човешкия фактор? Когато операторът даде на облака някаква странна или потенциално опасна команда, от него внезапно може да се изисква да реши малка задача, за да се провери колко добре е мислил. Например, ако става въпрос за масово спиране на много реплики или просто странна команда — намаляване на броя на репликите или смяна на името на образа, а не само номер на версията в новия манифест.
Итог
Отличителни характеристики на one-cloud:
- Йерархична и визуално ясна схема на именуване на услуги и контейнери, която позволява много бързо да се разбере каква задача е, към какво се отнася и как работи, и кой отговаря за нея.
- Ние прилагаме нашата техника за комбиниране на prod- и batch-задачи на миньоните, за да увеличим ефективността на съвместното използване на машините. Вместо cpuset, ние използваме CPU квоти, дялове, политиките на планировчика на CPU и Linux QoS.
- Напълно да изолираме контейнерите, работещи на една машина, не успяхме, но тяхното взаимно влияние остава в рамките до 20%.
- Организацията на услугите в йерархия помага при автоматичното ликвидиране на аварии чрез приоритети за разполагане и вытеснение..
Здравейте
Защо не избрахме готово решение.
- Различните класове изолация на задачите изискват различна логика при разполагане на миньоните. Докато prod задачите могат да се разполагат с прост резерв на ресурсите, то batch и idle задачите трябва да се разполагат, следейки реалната употреба на ресурсите на машините-миньони.
- Необходимостта от отчитане на ресурсите, консумирани от задачите, като:
- пропускната способност на мрежата;
- типовете и 'шпинделите' на дисковете.
- Необходимостта да се задават приоритети на услугите при ликвидиране на аварии, правата и квотите на екипите за ресурси, което се решава чрез йерархични опашки в one-cloud.
- Необходимостта от човешки названия на контейнерите за намаляване на времето за реакция при аварии и инциденти.
- Невъзможността за едновременно внедряване на Service Discovery; необходимостта дълго време да съществуват задачите, разположени на физически хостове — нещо, което се решава с 'статични' IP адреси, следващи контейнерите, и, следователно, необходимостта от уникална интеграция с голямата мрежова инфраструктура.
Всички тези функции биха изисквали значителни промени в съществуващите решения, а след оценка на количеството работа, осъзнахме, че можем да разработим собствено решение с приблизително същите усилия. Но нашето решение ще бъде значително по-лесно за експлоатация и развитие – в него няма ненужни абстракции, поддържащи ненужния ни функционал.
На тези, които четат последните редове – благодаря за търпението и вниманието!
Източник: habr.com
