

Половин година назад — публичен към PostgreSQL.
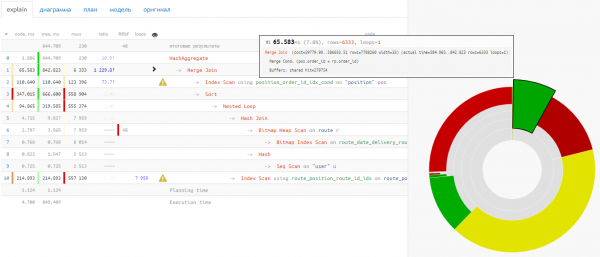
През последните месеци направихме доклад за него , подготвихме обобщаваща на базата на препоръките, които той предоставя… но най-важното е, че събирахме вашите отзиви и наблюдавахме реални случаи на уп Usage.
И сега сме готови да ви разкажем за новите възможности, с които можете да се възползвате.
Поддръжка на различни формати на планове
План от лог, заедно с заявката
Пряко от конзолата выделяме целия блок, започвайки от реда с Query Text, с всички водещи интервали:
        Query Text: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604 (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
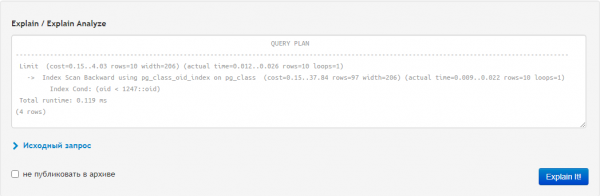
… и качваме всичко копирано направо в полето за план, без разделяне:
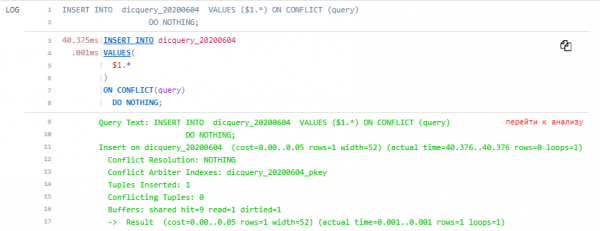
На изхода получаваме бонус към разбираемия план и вкладка „контекст“, където нашата заявка е представена в цялата си прелест:
JSON и YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
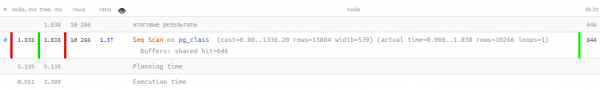
]"Независимо дали с външни кавички, както копира pgAdmin, или без — качваме в същото поле, на изхода — красота:
Разширена визуализация
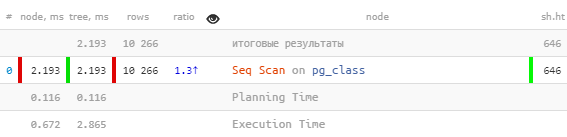
Планирано време / Време за изпълнение
Сега е по-ясно къде е отишло допълнителното време при изпълнението на заявката:
I/O Timing
Понякога се налага да се сблъскваме със ситуация, в която изглежда, че не е използвано твърде много ресурси в плана, но времето за изпълнение е неоснователно голямо.
Тук се налага да кажем: "О, вероятно в този момент дискът на сървъра е бил твърде натоварен, затова четенето е отнело толкова дълго!" Но това не е много точно…
Но може да се определи абсолютно точно. Факт е, че сред опциите за настройка на PG-сървъра има :
Включва меренето на времето за операции с вход/изход. Тази настройка по подразбиране е деактивирана, тъй като тя изисква постоянно запитване на текущото време от операционната система, което може значително да забави работата на някои платформи. За оценка на разходите за мерене на времето на вашата платформа можете да използвате утилитата pg_test_timing. Статистиката за вход/изход може да бъде получена чрез представянето pg_stat_database, в изхода на EXPLAIN (когато се използва настройката BUFFERS) и чрез представянето pg_stat_statements.
Тази настройка може да се активира и в рамките на локална сесия:
SET track_io_timing = TRUE;Но сега идва най-приятното — научихме се да разбираме и показваме тези данни с оглед на всички трансформации на изпълнителното дърво:
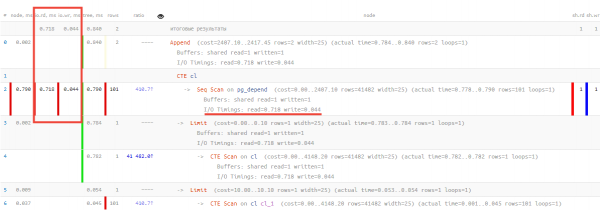
Тук може да се забележи, че от 0.790ms общо време за изпълнение 0.718ms е отнело четенето на една страница данни, 0.044ms — записването ѝ, а за цялата останала полезна активност са изразходвани само 0.028ms!
Бъдещето с PostgreSQL 13
Можете да се запознаете с пълния преглед на нововъведенията , а ние конкретно ще разгледаме промените в плановете.
Планиращи буфери
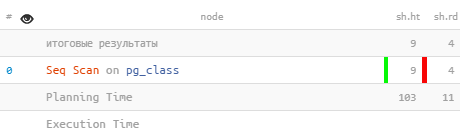
Отчитането на ресурсите, отделени за планиращия, намери отражение и в друг патч, който не е свързан с pg_stat_statements. EXPLAIN с опция BUFFERS ще информира за броя на буферите, използвани на етапа на планиране:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
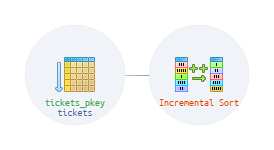
Инкрементална сортировка
В случаи, когато е необходима сортиране по много ключове (k1, k2, k3…), планиращият сега може да се възползва от знанието, че данните вече са сортирани по няколко от първите ключове (например k1 и k2). В този случай не е необходимо да се пренареждат всички данни, а вместо това да се разделят на последователни групи с еднакви стойности на k1 и k2, и да се "досортира" по ключа k3.
По този начин цялата сортиране се разпада на няколко последователни сортирания с по-малък размер. Това намалява необходимия обем памет, а също така позволява да се извеждат първите данни по-рано, преди цялата сортиране да бъде изпълнено напълно.
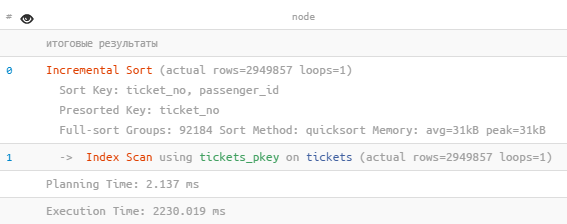
 Инкрементална Сортиране (actual rows=2949857 loops=1)
   Sort Key: ticket_no, passenger_id
   Presorted Key: ticket_no
   Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
   ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
Подобрения на UI/UX
Скриншотите, те са навсякъде!
Сега всеки раздел предлага възможността бързо да вземете екранна снимка на раздела в клипборда с цялата ширина и дълбочина на раздела — «прицел» вдясно-горе:
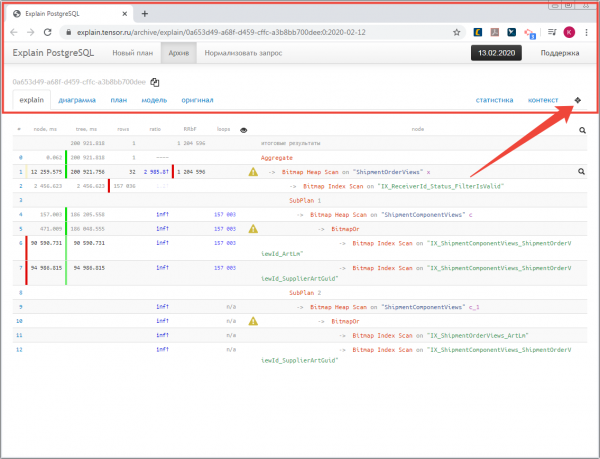
По същество, повечето изображения за тази публикация са получени именно по този начин.
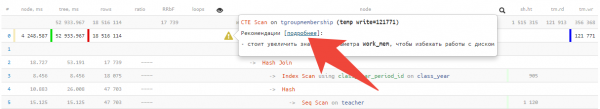
Препоръки на възлите
Не само, че станаха повече, но за всеки от тях може , като кликнете на връзката:
Изтриване от архива
Някои много ни помолиха да добавим възможността да изтривате «напълно» планове, които не са публикувани в архива — моля, просто натиснете съответната икона:
А, и не забравяйте, че имаме , където може да пишете своите забележки и предложения.
Източник: habr.com
