

Екип предлага инженер Рахул Бхатия из компании Clairvoyant о том, какие форматы файлов существуют в больших данных, какие самые распространенные функции форматов Hadoop и какой формат лучше использовать.
Зачем нужны разные форматы файлов
Серьезная узкая точка в производительности приложений с поддержкой HDFS, таких как MapReduce и Spark — это время поиска, чтения и записи данных. Эти проблемы усугубляются сложностями в управлении большими наборами данных, когда у нас нет фиксированной структуры, а схема постоянно эволюционирует или существуют специфические ограничения на хранение.
Обработка больших данных увеличивает нагрузку на подсистему хранения — Hadoop хранит данные избыточно для обеспечения отказоустойчивости. Кроме дисков, нагрузку испытывают процессор, сеть, системы ввода-вывода и пр. По мере роста объема данных увеличиваются и затраты на их обработку и хранение.
Различные форматы файлов в разработаны для решения именно этих проблем. Выбор правильного формата файла может предоставить несколько значительных преимуществ:
- Быстрее время чтения.
- Быстрее время записи.
- Общие файлы.
- Поддержка эволюции схем.
- Расширенная поддержка сжатия.
Некоторые форматы файлов предназначены для общего использования, другие — для более специфических случаев, а некоторые разрабатываются с учетом определенных характеристик данных. Таким образом, выбор действительно довольно велик.
Формат файлов Avro
За сериализации данных широко используют Avro — это основанный на строках, то есть строковый, формат хранения данных в Hadoop. Он хранит схему в формате JSON, что облегчает ее чтение и интерпретацию любой программой. Вся информация сохраняется в двоичном формате, компактно и эффективно.
Система сериализации Avro нейтральна к языку. Файлы могут обрабатываться различными языками, в настоящее время это C, C++, C#, Java, Python и Ruby.
Ключевой особенностью Avro является надежная поддержка схем данных, которые изменяются с течением времени, то есть эволюционируют. Avro понимает изменения схемы — удаление, добавление или изменение полей.
Avro поддерживает разнообразные структуры данных. Например, можно создать запись, содержащую массив, перечислимый тип и подзапись.
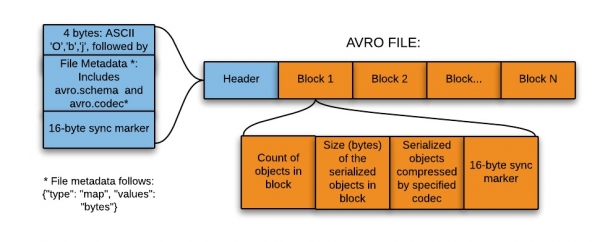
Этот формат идеально подходит для записи в переходную зону озера данных (, или data lake — колекция от инстанции за съхранение на различни типове данни в допълнение директно към източниците на данни).
Така че, за запис в котловата зона на езерото от данни, този формат е най-подходящ по следните причини:
- Данните от тази зона обикновено се четат в целия си обем за по-нататъшна обработка от по-долни системи — и форматът, основан на редове, в този случай е по-ефективен.
- По-долните системи могат лесно да извличат таблици на схеми от файлове — не е нужно да се съхраняват схемите отделно във външно мета-хранилище.
- Всяка промяна в оригиналната схема се обработва лесно (еволюция на схемата).
Форматът на файловете Parquet
Parquet е open-source формат на файлове за Hadoop, който съхранява вложени структури от данни в плосък колонен формат..
В сравнение с традиционния редов подход, Parquet е по-ефективен по отношение на съхранението и производителността.
Това е особено полезно за запитвания, които четат определени колони от широка (с много колони) таблица. Поради формата на файловете се четат само необходимите колони, така че входно-изходните операции са сведени до минимум.
Небольшо отклонение-пояснение: за да разберем по-добре формата на файла Parquet в Hadoop, нека погледнем какво представлява колонният — т.е. колонен — формат. В такъв формат заедно се съхраняват еднотипни стойности на всяка колона.
, записа включва полета ID, Name и Department. В този случай всички стойности на колоната ID ще се съхраняват заедно, както и стойностите на колоната Name и т.н. Таблицата ще изглежда приблизително така:
ID
Name
Department
1
emp1
d1
2
emp2
d2
3
emp3
d3
В стринг формат данните ще се съхранят по следния начин:
1
emp1
d1
2
emp2
d2
3
emp3
d3
В колонен формат на файловете същите данни ще се съхранят така:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Колонният формат е по-ефективен, когато трябва да запитвате няколко колони от таблицата. Той ще прочете само необходимите колони, защото те са в съседство. Така че входно-изходните операции са сведени до минимум.
Например, нуждаете се само от колоната NAME. В всяка запись в набора от данни трябва да бъде заредена, разобрана по полета и след това да бъдат извлечени данните NAME. Колонният формат позволява директно да се премине към колоната Name, тъй като всички стойности за тази колона се съхраняват заедно. Няма да се налага да сканирате цялата запись.
Така колонният формат увеличава производителността на запитванията, тъй като за преминаването към необходимите колони е необходимо по-малко време за търсене и се намалява броят на входно-изходните операции, тъй като се четат само нужните колони.
Една от уникалните характеристики е, че в такъв формат той може да съхранява данни с вложени структури. Това означава, че в Parquet файла дори вложените полета могат да се четат отделно, без необходимост от четене на всички полета във вложената структура. За съхранение на вложените структури Parquet използва алгоритъм за разчупване и сбор (shredding and assembly).
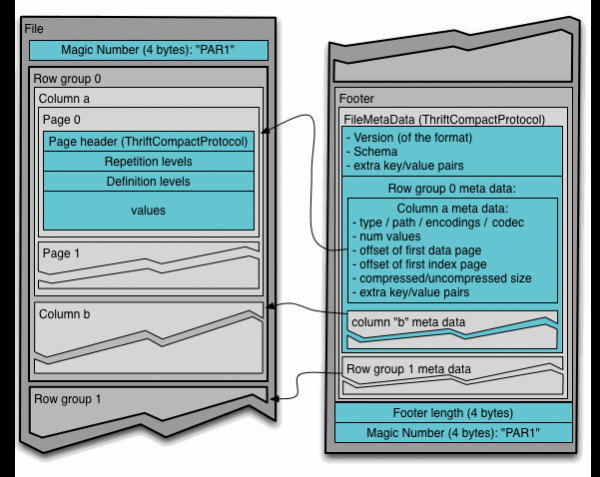
За да разберете формата на файла Parquet в Hadoop, е необходимо да знаете следните термини:
- Група редове (row group): логично хоризонтално разделение на данните на редове. Групата редове се състои от фрагмент на всяка колона в набора от данни.
- Фрагмент на колона (column chunk): фрагмент на конкретна колона. Тези фрагменти на колоните живеят в определена група редове и гарантирано ще бъдат съседни във файла.
- Страница (page): фрагментите на колоните се разделят на страници, записани една след друга. Страниците имат общ заглавие, така че при четене можете да пропуснете ненужните.
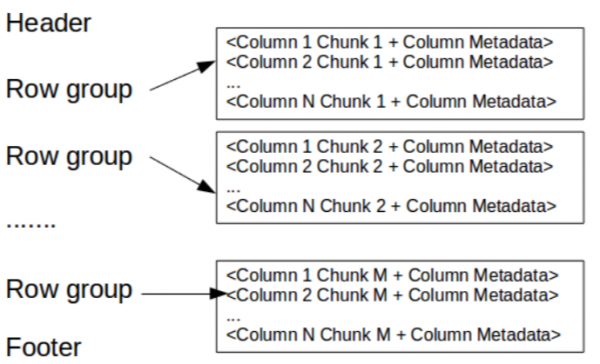
Тук заглавието просто съдържа магическо число PAR1 (4 байта), което идентифицира файла като файл от формата Parquet.
В края е записано следното:
- Метаданни на файла, които съдържат началните координати на метаданните на всяка колона. При четене първо трябва да се прочетат метаданните на файла, за да се намерят всички интересни фрагменти на колоните. След това фрагментите на колоните трябва да се четат последователно. Освен това метаданните включват версия на формата, схема и всякакви допълнителни двойки ключ-стойност.
- Дължина на метаданните (4 байта).
- Магическото число PAR1 (4 байта).
Форматът на файловете ORC
Оптимизиран редовно-колонен формат на файловете (Optimized Row Columnar, ) предлага много ефективен начин за съхранение на данни и е разработен, за да преодолее ограниченията на други формати. Съхранява данни в идеално компактен вид, позволявайки пропускане на ненужни детайли — при това не изисква изграждане на големи, сложни или ръчно обслужвани индекси.
Предимствата на формата ORC:
- Един файл на изхода на всяка задача, което намалява натоварването на NameNode (възел на имената).
- Поддръжка на типове данни Hive, включително DateTime, десетични и сложни типове данни (struct, list, map и union).
- Възможност за едновременен достъп до един и същ файл от различни процеси RecordReader.
- Възможност за разделяне на файлове без сканиране за наличие на маркери.
- Оценка на максимално допустимото разпределение на паметта на купчината за процеси на четене/писане на базата на информацията в футера на файла.
- Метаданните се запазват в бинарен формат на сериализация Protocol Buffers, който позволява добавяне и премахване на полета.
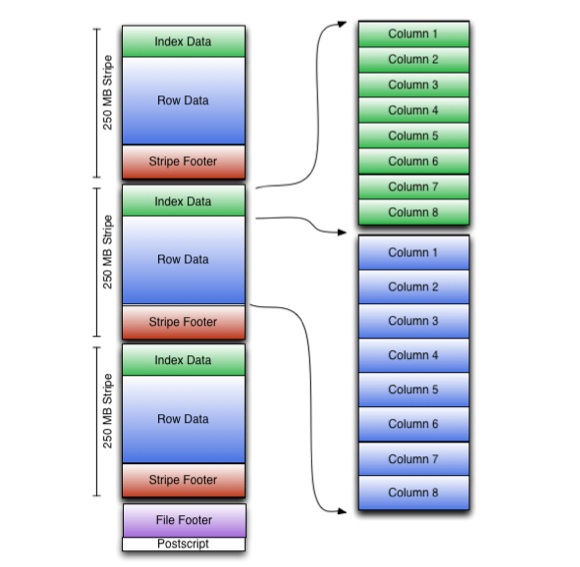
ORC съхранява колекции от редове в един файл, а в рамките на колекцията редовите данни се съхраняват в колонен формат.
Файлът ORC съхранява групи от редове, наречени ленти (stripes), и допълнителна информация във футера на файла. Постскриптумът в края на файла съдържа параметри за компресия и размер на компресирания футер.
По подразбиране размерът на лентата е 250 МБ. Поради лентите с такъв голям размер, четенето от HDFS се извършва по-ефективно: с големи непрекъснати блокове.
В футера на файла е записан списък с ленти в файла, брой редове на лента и тип данни на всяка колона. Там също е записано резултатното значение count, min, max и sum за всяка колона.
Футерът на лентата съдържа каталог на местоположенията на потока.
Редовите данни се използват при сканиране на таблици.
Индексните данни включват минимални и максимални стойности за всяка колона и позицията на редовете във всяка колона. Индексите ORC се използват само за избор на ленти и групи от редове, а не за отговаряне на запитвания.
Сравнение на различни формати на файлове.
Avro в сравнение с Parquet.
- Avro е формат за съхранение на редове, докато Parquet съхранява данни по колони.
- Parquet е по-добре подходящ за аналитични запитвания, тоест операциите по четене и извличане на данни са много по-ефективни от писането.
- Операциите по запис в Avro се извършват по-ефективно, отколкото в Parquet.
- Avro работи по-успешно с еволюцията на схемите. Parquet поддържа само добавяне на схеми, докато в Avro е реализирана многофункционална еволюция, т.е. добавяне или промяна на колони.
- Parquet е идеален за запитвания на подмножество от колони в многоколонна таблица. Avro е подходящ за операции ETL, където запитваме всички колони.
ORC в сравнение с Parquet.
- Parquet по-добре съхранява вложени данни.
- ORC е по-добре приспособен за предаване на предикати (predicate pushdown).
- ORC поддържа свойства ACID.
- ORC стиснява данните по-добре.
Какво още може да се прочете по темата:
- .
- .
- .
Източник: habr.com
