

Прим. прев.: авторите на тази статия са инженери от малката чешка компания pipetail. Те успяха да съберат страхотен списък от [понякога тривиални, но все още] толкова актуални проблеми и заблуждения, свързани с експлоатацията на Kubernetes клъстери.
През годините на използване на Kubernetes, ние работихме с множество клъстери (както управлявани, така и неуправлявани — в GCP, AWS и Azure). С времето започнахме да забелязваме, че някои грешки постоянно се повтарят. Въпреки това, няма нищо срамно в това: ние сами сме направили повечето от тях!
В статията са събрани най-разпространените грешки, както и споменаване на начина, по който да ги поправите.
1. Ресурси: заявки и лимити
Тази точка определено заслужава най-внимателно внимание и първо място в списъка.
Заявката за CPU обикновено или изобщо не е зададена, или има много ниска стойност (за да се разположат колкото се може повече pod'ове на всеки възел). Така възлите се затрупват. По време на високо натоварване, изчислителните мощности на възела са напълно използвани и конкретното работно натоварване получава само това, което "е заявило" чрез тротлинг на CPU. Това води до нарастване на закъсненията в приложението, таймаути и други неприятни последици. (Повече за това можете да прочетете в другия наш скорошен превод: „“ — бел. на прев.)
Най-добро усилие (в краен случаи не препоръчително):
resources: {}Екстремно ниската заявка за CPU (крайно не препоръчително):
   resources:
      Requests:
        cpu: "1m"
От друга страна, наличието на лимит за CPU може да доведе до неоправдано пропускане на тактовете от pod'овете, дори ако процесорът на възела не е напълно натоварен. Отново, това може да доведе до увеличаване на закъсненията. Споровете около параметъра CPU CFS quota в ядрото на Linux и тротлинга на CPU в зависимост от зададените лимити, както и деактивирането на CFS квотата… Уви, лимитите за CPU могат да причинят повече проблеми, отколкото могат да решат. Повече информация можете да намерите на линка по-долу.
Прекомерното разпределение (overcommiting) на паметта може да доведе до по-мащабни проблеми. Постигането на лимита на CPU води до пропускане на тактове, докато достигането на лимита на паметта води до „убийството“ на pod'а. Някой наблюдавал ли е OOMkill? Да, речь идет именно о нем.
Искате ли да намалите вероятността за това събитие? Не разпределяйте прекомерни количества памет и използвайте Guaranteed QoS (Качество на услугата), установявайки заявката за памет равна на лимита (както в примера по-долу). Научете повече за това в (водещ инженер в Zalando).
Бурстабилен (по-висока вероятност да получите OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Гарантиран:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Какво потенциално може да помогне при настройката на ресурсите?
С помощта на metrics-server може да видите текущото потребление на CPU и използването на памет от pod-ове (и контейнерите в тях). Вероятно вече го използвате. Просто изпълнете следните команди:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Но те показват само текущото използване. С тях можете да получите приблизителна представа за реда на величини, но в крайна сметка ще ви е нужна история на промените на метриките във времето (за да отговорите на такива въпроси като: "Какъв беше пикът на натоварване на CPU?", "Какво беше натоварването вчера сутринта?" и т.н.). За това можете да използвате Prometheus, DataDog и други инструменти. Те просто получават метрики от metrics-server и ги съхраняват, а потребителят може да ги запитва и да изгражда съответни графици.
позволява автоматизира този процес. Той следи историята на използването на процесора и паметта и настройва нови заявки и лимити на база на тази информация.
Ефикасното използване на компютърни мощности е трудна задача. Това е все едно постоянно да играете тетрис. Ако плащате твърде много за компютърни мощности с ниско средно потребление (да кажем, ~10 %), препоръчваме да се обърнете към продукти, базирани на AWS Fargate или Virtual Kubelet. Те са изградени на основата на модела на таксуване serverless/pay-per-usage, което в такива условия може да се окаже по-евтино.
2. Проверки на живост и готовност
По подразбиране проверките на живост и готовност в Kubernetes не са включени. И понякога забравят да ги активират...
Но как иначе може да се инициира повторно стартиране на службата в случай на неустранима грешка? И как балансировачът на натоварването ще знае, че някой pod е готов да приема трафик? Или че може да обработи повече трафик?
Често тези проби се бъркат помежду си:
- Liveness — проверка на "живост", която рестартира pod при неуспешно завършване;
- Readiness — проверка на готовност, при неуспех тя отключва pod от услугата Kubernetes (може да се провери с помощта на
kubectl get endpoints) и трафик към него не постъпва, докато следващата проверка не приключи успешно.
И двете проверки СЕ ИЗПЪЛНЯВАТ ПО ВРЕМЕТО НА ЦЕЛИЯ ЖИЗНЕН ЦИКЪЛ НА POD’А. Това е много важно.
Разпространено е погрешното схващане, че readiness пробите се стартират само в началото, за да може балансировчикът да разбере, че pod е готов (Готово) и може да започне да обработва трафика. Въпреки това, това е само един от вариантите за тяхното приложение.
Друг вариант е да се определи, че трафикът към pod е твърде голям и претоварва него (или pod изпълнява ресурсно интензивни изчисления). В този случай readiness проверката помага да се намали натиска върху pod и да го „охлади“. Успешното приключване на readiness проверката в бъдеще позволява отново да се увеличи натоварването на pod. В този случай (при провал на readiness пробата) провалът на liveness проверката би бил много контрапродуктивен. Защо да рестартирате pod, който е здрав и работи усилено?
Затова в някои случаи пълното отсъствие на проверки е по-добро, отколкото тяхната включеност с неправилно настроени параметри. Както беше споменато по-горе, ако liveness проверката копира readiness проверката, вие сте в големи проблеми. Възможен вариант е да настроите , а да оставите настрана.
И двата типа проверки не трябва да завършват неуспешно при провал на общи зависимости, в противен случай това ще доведе до каскадна (лавинна) повреда на всички pod’ове. С други думи, .
3. LoadBalancer за всеки HTTP-сервис
Вероятно имате HTTP услуги в кластера, които искате да пробиете навън.
Ако отворите услугата като type: LoadBalancer, контролерът му (в зависимост от доставчика на услуги) ще предоставя и съгласува външен LoadBalancer (не задължително работещ на L7, а по-скоро на L4), и това може да се отрази на цената (външен статичен адрес IPv4, изчислителни ресурси, тарифи на секунда) заради необходимостта от създаването на много подобни ресурси.
В този случай значително по-логично е да се използва един външен балансировчик на натоварването, отваряйки услугите като type: NodePort. Или, още по-добре, да разположите нещо като nginx-ingress-controller (или traefik, който да бъде единственият NodePort с край точка, свързана с външен балансьор на натоварването, и ще маршрутизира трафика в клъстера с помощта на ingress-ресурси на Kubernetes.
Други вътрешноклъстерни (микро)услуги, взаимодействуващи помежду си, могат да «общуват» чрез услуги от тип ClusterIP и вграден механизъм за откриване на услуги чрез DNS. Просто не използвайте техните публични DNS/IP, тъй като това може да повлияе на закъснението и да доведе до повишаване на разходите за облачни услуги.
4. Автоматично мащабиране на клъстера без да се вземат предвид неговите особености
Когато добавяте възли в клъстера и ги премахвате от него, не бива да разчитате на някои основни метрики като използването на CPU на тези възли. Планирането на pod трябва да се извършва с оглед на множество на ограниченията, като affinity на pod/възли, taints и tolerations, искания за ресурси, QoS и т.н. Използването на външен autoscaler, който не взема под внимание тези нюанси, може да доведе до проблеми.
Представете си, че даден pod трябва да бъде планиран, но всички налични ресурси на CPU са заявени/разпределени и pod застряла в състояние Pending. Външният autoscaler вижда средното текущо натоварване на CPU (а не заявеното) и не инициира разширение (scale-out) — не добавя още един възел. В резултат на това, този pod няма да бъде планиран.
В същото време, обратно мащабиране (scale-in) — премахване на възел от клъстера — винаги е по-сложно за реализиране. Представете си, че имате stateful pod (с прикачено постоянно хранилище). Persistent томовете обикновено принадлежат на определена зона на достъпност и не се репликират в региона. По този начин, ако външният autoscaler премахне възел с този pod, планиращият не може да планира този pod на друг възел, тъй като това може да се направи само в зоната на достъпност, където се намира постоянното хранилище. Pod ще остане в състояние Pending.
В Kubernetes общността е много популярен . Той работи в клъстера, поддържа API от основните доставчици на облачни услуги, отчита всички ограничения и може да се мащабира в посочените случаи. Той също така е в състояние да извършва scale-in, като запазва всички наложени ограничения, икономисвайки средства (които иначе биха били похарчени за ненужни ресурси).
5. Пренебрегване на възможностите на IAM/RBAC
Бъдете внимателни при използването на IAM потребители с постоянни тайни за машини и приложения. Организирайте временен достъп, използвайки роли и служебни акаунти (служебни акаунти).
Често се сблъскваме с това, че ключовете за достъп (и тайните) са 'hardcode'-нати в конфигурацията на приложението, а също и с пренебрегването на ротацията на тайните, въпреки наличността на достъп до Cloud IAM. Използвайте IAM роли и служебни акаунти вместо потребители, където е уместно.
Забравете kube2iam и преминете директно към IAM роли за служебни акаунти (както е описано в Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Една анотация. Не е толкова трудно, нали?
Освен това, не наделяйте служебните акаунти и профилите на инстанциите с права админ и cluster-admin, ако не е необходимо. Това е малко по-сложно за реализиране, особено в RBAC K8s, но определено си заслужава усилията.
6. Не разчитайте на автоматичен anti-affinity за pod’овете
Представете си, че имате три реплики на някакъв deployment на узел. Узелът пада, а заедно с него и всички реплики. Неприятна ситуация, нали? Но защо всички реплики се намираха на един и същи узел? Не трябва ли Kubernetes да осигурява висока наличност (HA)?!
За съжаление, Kubernetes планировчикът по своя инициатива не спазва правилата за разделно съществуване (anti-affinity) за pod’овете. Те трябва да бъдат явно дефинирани:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Ето го. Сега pod’овете ще бъдат планирани на различни узли (това условие се проверява само по време на планирането, но не и по време на тяхната работа — откъдето и requiredDuringSchedulingIgnoredDuringExecution).
Тук говорим за podAntiAffinity на различни узли: topologyKey: "kubernetes.io/hostname", — а не за различни зони на наличност. За да реализирате пълноценна HA, ще трябва да се задълбочите в темата.
7. Игнориране на PodDisruptionBudget’ите
Представете си, че имате производствена натовареност в Kubernetes кластер. Периодично е необходимо да обновявате (или изключвате) узлите и самия кластер. PodDisruptionBudget (PDB) представлява нещо като гаранционно споразумение между администраторите на кластер и потребителите.
PDB позволява да се избегнат смущения в работата на услугите, предизвикани от недостиг на узли:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
В този пример, като потребител на клъстера, вие уведомявате администраторите: „Хей, имам услуга zookeeper и независимо какво правите, искам най-малко 2 реплики на тази услуга да бъдат винаги налични“.
Повече за това можете да прочетете .
8. Няколко потребители или среди в общ клъстер
Пространствата от имена на Kubernetes (namespaces) не осигуряват силна изолация.
Широкоразпространено е погрешното схващане, че ако разположите не-prod натоварване в едно пространство от имена, а prod натоварването в друго, те няма да влияят едно на друго… Въпреки това, определено ниво на изолация може да бъде постигнато чрез заявки/ ограничения на ресурси, задаване на квоти, назначаване на priorityClass'и. Някаква "физическа" изолация в data plane се осигурява от affinities, tolerations, taints (или nodeselectors), но подобно разделение е доста сложно за реализиране.
На тези, които трябва да комбинират двата типа натоварвания в един клъстер, ще се наложи да се справят с трудността. Ако обаче нямате такава нужда и можете да си позволите да създадете още един клъстер (да кажем, в публичен облак), по-добре е да го направите. Това ще осигури много по-високо ниво на изолация.
9. externalTrafficPolicy: Cluster
Много често наблюдаваме, че целия трафик вътре в клъстера постъпва през услуга от тип NodePort, за която по подразбиране е зададена политиката externalTrafficPolicy: Cluster. Това означава, че NodePort е отворен на всеки възел в клъстера и всеки от тях може да се използва за взаимодействие с нужната услуга (набор от pod'ове).
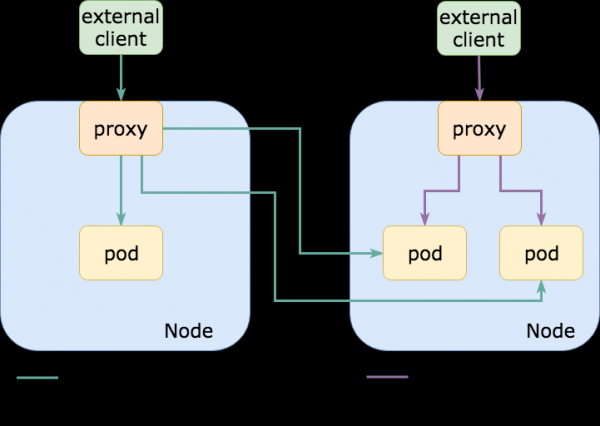
В същото време реалните pod'ове, свързани с гореспоменатата NodePort услуга, обикновено се намират само на някакво подмножество от тези възли.С други думи, ако се свържа с възел, на който няма нужния pod, той ще пренасочва трафика към друг възел, добавяйки транзитен участък (hop) и увеличавайки забавянето (ако възлите са в различни зони на достъпност/дата центрове, забавянето може да бъде доста високо; освен това разходите за egress трафик ще нараснат).
От друга страна, ако за някаква услуга в Kubernetes е зададена политиката externalTrafficPolicy: Local, то NodePort се отваря само на тези възли, където всъщност работят нужните pod'ове. При използване на външен балансьор на натоварването, който проверява състоянието (healthchecking) на endpoint'ите (както прави AWS ELB), той ще изпраща трафик само на нужните възли., което ще се отрази благоприятно на забавянията, изчислителните нужди, сметките за egree (и здравият разум подсказва същото).
Вероятно вече използвате нещо като traefik или nginx-ingress-controller като крайна NodePort точка (или LoadBalancer, който също използва NodePort) за маршрутизиране на HTTP ingress трафика, а включването на тази опция може значително да намали забавянето при подобни заявки.
В можете да научите повече за externalTrafficPolicy, нейните предимства и недостатъци.
10. Не се привързвайте към клъстери и не злоупотребявайте с управляващия слой.
Преди сървърите обикновено се наричаха с имена собственни: , HAL9000 и Colossus… Днес на тяхно място идват случайно генерирани идентификационни номера. Въпреки това навикът остана и сега собствените имена принадлежат на клъстерите.
Типична история (основана на реални събития): всичко започна с обосноваването на концепцията, така че клъстерът носеше гордото име тест… Изминаха години и той СЕ ИЗПОЛЗВА в production, и всички се страхуват да го докоснат.
Няма нищо смешно в това, че клъстерите стават питомци, затова препоръчваме периодично да ги изтривате, докато практикувате възстановяване след сривове (в това ще помогне — забележка на преводача). Освен това, не би било зле да се занимавате и с управляващия слой (контролен слой). Страхът да се докоснете до него — не е много добър знак. Etcd мъртъв? Хора, вие наистина сте в беда!
От друга страна, не трябва да се увлекате с манипулациите с него. С времето управляващият слой може да стане бавен.Скорее, това е свързано с многото създавани обекти без ротация (обичайна ситуация при използване на Helm с настройки по подразбиране, в резултат на което състоянието му не се обновява в configmap-овете/тайните — следствие, в управляващия слой се натрупват хиляди обекти) или с постоянно редактиране на обекти kube-api (за автоматично мащабиране, за CI/CD, за мониторинг, логове на събития, контролери и т.н.).
Освен това, препоръчваме да проверите SLA/SLO споразуменията с доставчика на управляван Kubernetes и да обърнете внимание на гаранциите. Доставчикът може да гарантира достъпността на управляващия слой (или неговите подконтролни компоненти), но не p99-забавянето на заявките, които му изпращате. С други думи, можете да въведете kubectl get nodes, а отговорката да получите само след 10 минути няма да е нарушение на условията на договора за обслужване.
11. Бонус: използването на таг latest
Това вече е класика. В последно време се срещаме с такава техника не толкова често, тъй като много хора, учейки се от горчивия опит, спряха да използват тага :latest и започнаха да закрепват (pin) версиите. Ура!
ECR ; препоръчваме да се запознаете с тази забележителна особеност.
Резюме
Не очаквайте всичко да заработи с едно щракване: Kubernetes не е панацея. Лошото приложение (и може би ще стане още по-лошо). Безотговорността ще доведе до излишна сложност, бавна и стресирана работа на управляващия слой. Освен това рискувате да останете без стратегия за възстановяване в случай на бедствия. Не разчитайте, че Kubernetes "из коробки" ще поеме осигуряването на изолация и висока наличност. Отделете известно време, за да направите приложението си наистина cloud native.
Можете да се запознаете с неуспешния опит на различни екипи в от Хенинг Якобс.
Желаещите да допълнят списъка с грешки, посочени в тази статия, могат да се свържат с нас в Twitter (, ).
P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «» (преглед и видео на доклада);
- «».
Източник: habr.com
