

Преди две години вече публикувах пост по . Сега има известно развитие на проекта, а също така публикувах под , затова реших да напиша в Хабр този малък преглед.
[ ]
Кому може да бъде интересно това
Вам може да бъде интересно, ако работите в малък екип или дори сам. Нямате мониторинг и не сте сигурни, дали наистина е нужен. Или пък сте опитвали някакъв популярен сериозен мониторинг "за големите момчета", но за вас той сякаш "не се получи", или работи почти в дефолтна конфигурация и не е променил живота ви особено. Още — ако не планирате да отделите цял служител (или дори отдел), за да мулит медиума поне няколко часа на ден да следи в таблото за мониторинг или да го настройва.
С какво е необичаен okerr
По-нататък ще покажа интересни особености на окерра, които го отличават от някои други мониторинги.
Okerr — хибриден мониторинг
При вътрешния мониторинг на наблюдаваните машини работи "агент", който предава данни на мониторинг сървъра (например, свободно място на диска). При външния — сървър по мрежата извършва проверки (например, ping или наличност на уебсайта). Всеки подход има своите ограничения. Okerr използва и двата варианта. Проверка вътре в сървърите се извършва с много лек (30Kb) агент или вашите собствени скриптове и приложения, а мрежовите — чрез сензори okerr в различни страни.
okerr — това не е просто софтуер, а също и услуга
Сървърната част на всяко мониторинг решение е голяма и сложна, трудно е да се инсталира и настройва, изисква ресурси. С okerr можете да инсталирате собствен мониторинг сървър (той е безплатен и с отворен код), или можете просто да използвате само клиентската част и да се възползвате от услугата на нашия сървър. Също безплатно.
Ако мониторингът позволява да компенсира недостатъка на надеждността на сървърите и приложенията, се поставя философският въпрос — кой охранява охранителя? Как мониторингът може да ни уведоми за проблем, ако той самият е 'умрял' по някаква причина, самостоятелно или заедно с другите ваши ресурси (например, ако връзката с дата центъра падне)? При използването на външния сервиз okerr — този проблем се решава — вие ще получите аларма дори ако целият дата център с вашите сървъри е без захранване или е подложен на зомби атака.
Разбира се, съществува риск, че сървърът на okerr сам ще бъде недостъпен, така е (както знаем, 90% надеждност се получават винаги лесно и 'безплатно', 99% — с минимални усилия, а всяка следваща девятка — е експоненциално по-трудна). Но, на първо място, шансовете за това са по-ниски, а на второ място, проблемът може да остане незабелязан само ако съвпадне по време с проблеми на нашите сървъри. Ако имаме надеждност 99.9%, и вие 99.9% (не особено високи числа), тогава шансът за незабелязан проблем е 0.1% от 0.1% = 0.0001%. Да добавите три девятки в надеждността почти без усилия и разходи — това е много добре!
Още едно предимство на мониторинга като услуга — хостинг доставчик или уеб студио може да инсталира сървър на okerr и да предоставя достъп на клиентите като платена или безплатна допълнителна услуга. Вашите конкуренти предлагат само хостинг и сайтове — а вие предлагате надежден хостинг с мониторинг.
Okerr — това са индикатори
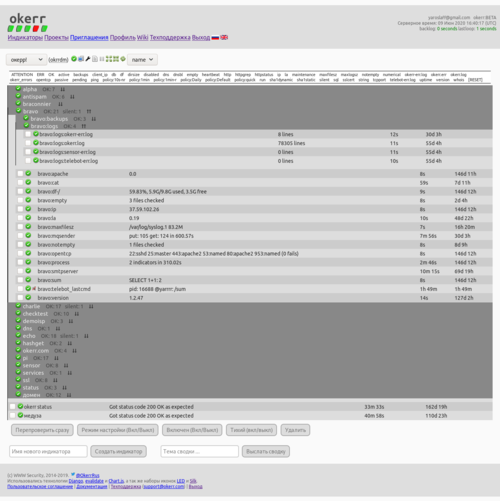
Индикаторът е 'лампичка'. Той има две основни състояния — зелено (OK) или червено (ERR). В проекта — множество групирани (например, по сървъри) индикатори. На главната страница на проекта вие веднага виждате, или всичко е зелено (и може да затворите), или нещо свети в червено и трябва да се поправи. При преминаване между тези състояния — се изпраща уведомление. Веднъж на ден, когато го настроите — се изпраща обобщение на проекта.
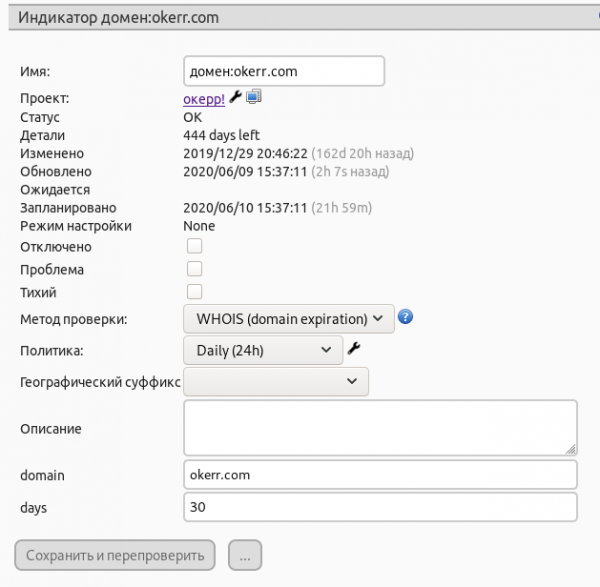
Всеки индикатор на okerr има вградени условия, по които променя състоянието си (в Zabbix това се нарича trigger). Например, средното натоварване трябва да бъде не повече от 2 (разбира се, това е настраиваемо). И за всяка вътрешна проверка (средно натоварване, свободно пространство на диска, …) — има watchdog. Ако по някаква причина не получим успешно потвърждение в определеното време — се регистрира грешка и се изпраща аларма.
Обичайната ни работна схема е сутрешна проверка на пощата, където сред другите писма разглеждаме обобщението (времето му определяме за начало на работния ден). Ако всичко е наред, минаваме към другите важни задачи (но можем за сигурност бързо да надникнем в дашборда на окерра, за да се уверим, че и в този момент всичко е зелено). Ако получим аларма, реагираме.
Разбира се, има възможност просто да се държат «информационни» индикатори (за да виждате ситуацията в мрежата от наблюдението), но всичко е направено, за да бъде лесно, удобно и бързо да се създават индикатори именно за автоматично наблюдение и изпращане на аларми.
Смисълът, поради който настройвате okerr, е в алармите, в това да можете за минута да създадете индикатор, който може да е спал години, просто да е приемал актуализации, а когато след година нещо се повреди — той да светне и да изпрати аларма. Времето, което веднъж сте похарчили за създаването на индикатора, се изплати, защото веднага разбирате за проблема, по-рано от всички. Може би сте го поправили, преди някой друг да е забелязал. Бързо внесеното не се счита за паднало!
Сигурност
Беше бързо обидно, ако настройвате наблюдение за повишаване на надеждността, а в резултат — чрез него ви атакуват по мрежата. Мрежовите уязвимости на различните средства за наблюдение са доста много., ).
Агентът (okerrmod от пакета ), работещ на системата — не е мрежов сървър, а клиент. Затова на наблюдавания сървър няма допълнителни отворени портове, клиентът работи лесно зад защитна стена или NAT и е много трудно (щях да кажа „невъзможно“) да се хакне през мрежата, тъй като той принципно не слуша мрежов сокет.
Пълен обхват на наблюдение
В момента имаме правило — научаваме за всички технически проблеми от okerr. Ако случайно правилото бъде нарушено (ако окерр не ни е предупредил за приближаващата му поява (ако е възможно) или че вече е настъпил) — добавяме проверки в okerr.
Външни проверки
Доста типичен набор:
- ping
- http статус
- проверка на валидността и свежестта на SSL сертификата (ще предупреди, ако срокът скоро изтече)
- отворен TCP порт и банер на него
- http grep (на страницата [не] трябва да присъства определен текст)
- sha1 хеш за откриване на промени на страницата.
- DNS (DNS записа трябва да има определена стойност)
- WHOIS (ще предупреди, ако домейна скоро изтече)
- Antispam DNSBL (проверка на хоста веднага по 50+ антипартидни черни списъци)
Вътрешни проверки
Също така, доста типичен набор (но лесно разширяем).
- df (свободно пространство на дисковете)
- средна натовареност
- opentcp (открити слушащи TCP сокети — уведомява, ако нещо е стартирало или е паднало)
- uptime — просто uptime на сървера. Уведомява, ако той се е променил надолу (т.е. сървърът се е рестартирал)
- client_ip
- dirsize — използваме го, за да следим, когато нашите rootfs виртуализации превишават разрешения размер, без да въвеждаме строги ограничения, и за размерите на домашните каталози на потребителите
- empty и nonempty — следят за файлове, които трябва да бъдат празни (или не празни). Например, error log на самия сървър okerr — трябва да бъде празен, и ако в него има поне един ред — ще получа уведомление и ще проверя. А mail.log на пощенския сървър трябва да бъде НЕ празен (след N минути след ротацията). Понякога обаче е бил празен след обновление на системата, когато logrotate не е могъл правилно да рестартира rsyslog.
- linecount — брой редове във файла (като wc -l). Използваме го като по-мека замяна за empty, когато error log все пак може да расте, но само бавно (например, нашият гуглобот хрупа на някои затворени страници). Има ограничение от 2 реда за 20 минути. Ако бъде надхвърлено — ще има сигнал
Интересни вътрешни проверки
Ако до тук си четял «по диагонал», сега ще е по-интересно да прочетеш внимателно.
backup-и
Следи за backup-и в директорията. Нашите backup файлове имат имена като «ServerName-20200530.tar.gz». За всеки сървър в okerr се създава индикатор ServerName-DATE.tar.gz (фактическата дата се променя на реда «DATE»). Също така се следи наличието на актуален backup и неговият размер (например, не може да бъде по-малък от 90% от предишния backup).
Какво трябва да направим, за да започне новият backup да се следи, след като започнем да го създаваме и да го поставяме в тази директория? Нищо! Това е много удобен подход, когато трябва да направиш «нищо», защото:
- Да направиш «нищо» — е доста бързо, спестява време
- Трудно е да забравиш да направиш «нищо»
- Трудно е да направиш «нищо» неправилно, с грешка. Нищо — това е най-надеждният метод
Ако вдруг случайно престанат да се появяват нови backup файлове — ще има сигнал. Ако например сте изключили един от сървърите, и не трябва да има повече негови backup-и — ще трябва да изтриете индикатора (чрез уеб интерфейса или от командния ред чрез API).
maxfilesz
Следи за размера на най-големите файлове (обикновено: /var/log/*). Това позволява да се откриват непредвидими проблеми, например, опити за подбиране на пароли или разпространение на спам през сървъра.
runstatus/runline
Тези два важни proxy модула служат за стартиране на други програми на сървъра. Runstatus съобщава индикатора за изходния код на програмата. Например, в okerr няма (не е нужен) модул за проверка на работата на systemd услугите. Това се прави чрез runstatus (вижте по-долу). Runline — съобщава на сървъра реда, който издава програмата. Например, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" в конфигурацията Runline на нашия сървър създава индикатор servername:temp с температурата на процесора.
sql
Изпълнява числов заявка към MySQL и съобщава резултата в индикатора. В прост случай може да направите например „SELECT 1“ — това ще провери, че базата данни работи общо взето.
Но много по-интересно приложение е, например, да следите броя на поръчките в интернет магазина. Ако знаете, че на час получавате от 100 поръчки, можете да зададете минимален праг от 100 или 80. Тогава, ако продажбите ви се сринат неочаквано — ще получите алерт и ще можете да разберете какво се случва.
Забележете — не е важно по каква непредвидима причина се е случило това:
- Сървърът просто е недостъпен (изключен или без интернет), а алертът e дошъл от това, че индикаторът е „изтекъл“.
- Сървърът е натоварен с нещо, работи бавно или пакети се губят, неудобно е за потребителите и те напускат без покупки.
- Сървърът е попаднал в списъци за спам и имейлите не се приемат, потребителите не могат да се регистрират.
- Стигнал е край бюджетът на рекламната кампания и банерите не се показват.
Причини могат да бъдат колкото искате, и всичките не могат да се предвидят предварително, а и е сложно технически да се проследят. Но може удобно да следите крайния параметър (поръчките) и по тях да определите, че ситуацията е подозрителна и заслужава да се разгледа.
Логически индикатори
Позволява използването на логически изрази (синтаксис на Python) чрез модула (). За израза са налични данни от проекта и неговите индикатори. Например, в главата за SQL проверката по-горе, вероятно сте забелязали слабото място — през деня имаме около 100 продажби на час, но през нощта — 20, и това е нормално, не е проблем. Какво да правим? Индикаторът ще паникьосва постоянно през нощта.
Можете да създадете два индикатора, дневен и нощен. И двата да бъдат 'тихи' (те няма да изпращат известия). И създайте логически индикатор, който изисква до 20:00 дневният индикатор да бъде OK, а след 20:00 е достатъчно нощният индикатор да е OK.
Друг пример за използване на логически индикатор е ескалация. Например, проектен мениджър се отписва от алерти (не му е нужно, администраторите трябва да реагират на обичайните проблеми), но се отписва на логически индикатор, който променя цвета си на червен, ако някой индикатор в проекта не е коригиран в рамките на зададеното време.
Също така, има възможност да се зададе допустимо време за работа, например, от 3 до 5 сутринта. Не ни интересува, ако сървърите и сайтовете 'падат' в това време. Но в 5:00 те трябва да работят. Ако не работят по всяко друго време — предупреждение. Логическият индикатор също така позволява да се вземе предвид резервирането на сървъри. Ако имате 5 уеб сървъра, администраторите могат да изключват 1-2 сървъра по всяко време. Но ако в употреба са по-малко от 3 от 5 сървъра — ще има предупреждение.
Примерите по-горе не са функции на okerr, не са някакви функции, които трябва да се активират и настройват. Всички тези функции не са налични в okerr, но има логически модул, който позволява реализиране на този функционал (Приблизително, както в програмния език — ако имаме аритметични оператори, не ни трябва специална функция на езика за изчисляване на 20% ДДС, тя винаги може да бъде направена от самите нас според нуждите).
Логическият индикатор вероятно е една от малкото относително сложни теми в okerr, но добрата новина е, че не е нужно да ги овладявате, докато не се наложи. Но те значително разширяват възможностите, като запазват самата система достатъчно проста.
Добавяне на собствени проверки
Бих искал много да подчертая, че okerr не е набор от хиляди готови проверки за всички случаи на живота, а напротив — на първо място — прост двигател с проста възможност за създаване на собствени проверки. Създаването на собствени проверки в okerr не е задача за хакери, съ-разработчици на системата или поне напреднали потребители на okerr, а е по силите на всеки администратор, който месец преди това за първи път е инсталирал linux.
Проверките на минималните нива се извършват чрез модула :
Тази линия в конфигурацията ще ви уведоми, ако по някаква причина /bin/true не се стартира или връща не 0.
true_OK=\/bin\/trueСамо едно изречение — и ето, вече сме малко разширили функционал okerr.
Дори такава проверка — вече има своя стойност: ако случайно вашият сървър падне — съответният индикатор на сървъра okerr няма да се обнови своевременно и след определено време ще възникне аларма.
Тази проверка ще алармира, че сървърът apache2 е паднал (все пак...):
apache_OK="systemctl is-active --quiet apache2"Така че, ако владеете който и да е език за програмиране, поне можете да пишете shell скриптове — вече можете да добавяте собствени проверки.
По-трудно — можете да напишете (на който и да е език) свой модул за okerrmod. В най-простия случай той изглежда така:
#!/usr/bin/python3

print("STATUS: OK")
Наистина, не е ли много сложно? Модулът трябва да направи самата проверка и да изведе резултатите на STDOUT. По-сложен модул дава, например, следното:
$ okerrmod --dump df
NAME: pi:df-\/\
TAGS: df
METHOD: numerical|maxlim=90
DETAILS: 49.52%, 13.9G\/28.2G заето, 13.0G свободно
STATUS: 49.52

NAME: pi:df-\/boot
TAGS: df
METHOD: numerical|maxlim=90
DETAILS: 84.32%, 53.1M\/62.9M заето, 9.9M свободно
STATUS: 84.32
Той обновява веднага няколко индикатора (разделени с празен ред), при необходимост ще ги създаде, указва детайли за проверката и таг, по който в таблото лесно да се намерят нужните индикатори.
Телеграм
Има Telegram бот . Не е нужно да застарявате телефона си с отделни приложения (самият аз не обичам, че за Пятерочка трябва едно приложение с карта, за Лента друго, за МТС трето и така за всички-всички-всички). Един Telegram — достатъчно. Чрез Telegram можете да получавате аларми веднага и да проверявате статуса на проекта и да дадете команда за повторна проверка на всички проблемни индикатори. Излязохте от театъра\/самолета, два часа не държахте ръка на пулса, включихте телефона, натиснахте един бутон в чат-бота и се уверихте, че всичко е наред.
Страници за статус
В наше време, страниците за статус — вече почти са задължителни за всеки бизнес, който има IT, отговорно отношение към надеждността и който уважава своите клиенти\/потребители.
Представете си ситуация — потребителят иска да направи нещо, да види информация или да направи поръчка, и нещо не работи. Той не знае какво не е наред, на чия страна е проблемът и кога ще бъде разрешен. Може да е, че сайта на вашата фирма просто не работи? Или е счупен от половин година и ще бъде поправен след две години? А хладилникът трябва да се купи сега, вече е в количката… И съвсем друго е, когато човек вижда, че нещо не е наред при вас (поне е ясно, че проблемът не е на неговата страна), че проблемът е открит, че работите по него и може би дори сте написали приблизително време за решаване. Потребителят може да се абонира и да получи по имейл уведомление, когато проблемът бъде решен и ще може да направи това, което е искал (да закупи хладилника).
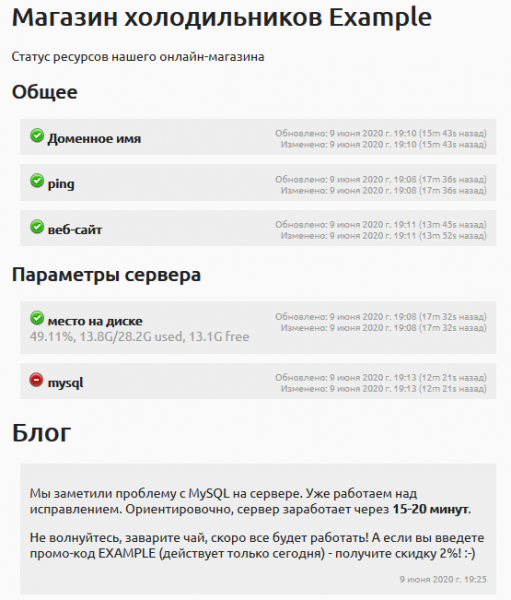
Проблеми, прекъсвания — всеки ги има. Но потребителите и партньорите повече доверяват на тези, които са по-прозрачни и отговорно подхождат към това.
Ето . Ето примери как изглеждат тези страници при проектите и . .
Failover
За да не разширявам тази статия още повече, ще се позова отново на предишната си статия — . Ако можете да направите дублиращ сървър, с използване на failover, в принцип ще нямате дълги прекъсвания — веднага щом проблемът бъде открит, потребителите автоматично ще бъдат пренасочени към работещия резервен сървър. И ми се струва, че това е много интересна, ярка функция, която е рядкост.
Ниски системни изисквания
За сървърите okerr — използваме машини с RAM от 2Gb. За мрежовите сензори — дори 512Mb е достатъчно. Клиентската част — почти нулева. (Пакетът тегли 26 Kb, но изисква Python3 и стандартни библиотеки). Клиентът се стартира от cron скрипт, така че има нулево постоянно потребление на памет. Сред наблюдаваните машини имаме сензори (супер-евтини VPS с 512Mb RAM) и Raspberry Pi. Може дори без клиентската част ! (вижте по-долу)
С оглед на това — окерр, вероятно, най-добрият безплатен Мониторинг, предоставляемый okerr, устраняет необходимость выделения ресурсов для других бесплатных опен-сорсных систем, таких как Zabbix или Nagios, что уже связано с затратами. Кроме того, всё равно требуется обслуживание сервера. С помощью okerr эту часть можно исключить или использовать собственный сервер — в зависимости от ваших предпочтений.
API и интеграция в собственное ПО
Простая и открытая архитектура. У okerr достаточно простая , которая легко настраивается. Нужно создать 1000 индикаторов? Один шелл-скрипт в 3-4 строчки это сделает. Нужно перенастроить 1000 индикаторов? Это также очень просто. Например, мы хотим перепроверить все наши HTTPS сертификаты с помощью российского сенсора:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Обновить индикатор можно как через наш клиентский модуль, так и просто через curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Можно обновлять индикаторы прямо из своей программы. Например, отправляя сигналы heartbeat, чтобы okerr знал, что программа запущена и поднял тревогу, если она остановилась или зависла. Кстати, компоненты okerr так и работают — okerr следит за собой, и проблемы практически в любом модуле будут обнаружены с последующей генерацией оповещения. (А на случай этого «почти» — они проверяются с другого сервера.)
Вот такой код (упрощенно) в нашем телеграм-боте:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
Для обновления индикаторов из Python-программ есть библиотека , для других языков библиотек нет, но можно либо вызвать скрипт okerrupdate, либо выполнить HTTP-запрос к серверу okerr.
Как нам помогает okerr
Okerr изменил нашу жизнь. На самом деле. Возможно, другая система мониторинга могла бы это сделать, но с okerr работать легко, и в нем есть все функции, которые нам были нужны (чего не хватало — мы дописали). Кстати, если какой-то функции нет — спросите, и я добавлю её (не обещаю, но хочу, чтобы okerr был лучшей системой мониторинга для малых и средних проектов). Или, ещё лучше, добавьте сами — это просто.
Ние успяхме да живеем по принципа "да научим за всички проблеми от okerr". Ако се случи проблем, за който научаваме не от okerr — добавяме проверка в okerr. (В този случай "ние" разбираме като потребители на системата, а не като съ-разработчици). Първоначално това беше често, но сега стана много рядко.
Мониторинг
Чрез okerr следим размера на логовете на всички сървъри. Едва ли е възможно да четем всяка редица от лога внимателно с очите, но просто следенето на скоростта на растежа — вече е много полезно. Чрез това откривахме както спам разпращане, така и brute force опити за пробив на пароли, и когато някои приложения "полудяват", нещо не им се получава и те повтарят отново и отново (всеки път добавяйки няколко реда в лога).
SSL сертификати. Почти веднага след старта нашият клиент започна да предоставя на своите клиенти безплатни SSL сертификати (около хиляда от тях). И това се оказа просто ад за администриране! Фактът е, че сайтовете са "живи", клиентите периодично нещо искат да им направят, програмистите действат. Могат напълно свободно да преместят сайта на друг DocumentRoot например. Или да добавят безусловен Rewrite в конфигурацията на виртуалния хост. Естествено, след такова автоматичното обновяване на сертификатите се чупи. Сега всички наши SSL хостове се добавят в okerr автоматично чрез още едно наше полезно приложение от пакета . Просто стартираме a2okerr.py — и ако на сървера се появят няколко нови сайта — те автоматично ще се появят в okerr. Ако по някаква причина сертификатът не се обновява, три седмици преди да изтече сертификатът — ние сме наясно и разследваме, защо не се обновява, толкова много. a2certbot.py от същия пакет — много помага в това (веднага проверява най-вероятните проблеми и пише, че добре е проверено и къде вероятно има проблем).
Следим срока на изтичане на всички наши домейни. А всички наши пощенски сървъри, които изпращат имейли — още и проверяваме по 50+ различни черни списъка. (И понякога попадат в тях). Между другото, знаете ли, че пощенските сървъри на Google също са в черните списъци? Просто за самопроверка добавихме mail-wr1-f54.google.com към наблюдаваните сървъри и той наистина е в черния списък на SORBS! (Това е във връзка с ценността на "антиспамерите")
Резервните копия са нещо, за което вече споменах, как лесно да ги следим с okerr. Но ние следим и за новите резервни копия на нашия сървър, и (с помощта на отделна утилита, която използва okerr) — за резервните копия, които качваме на Amazon Glacier. И да, периодично се случват проблеми. Не без причина следим.
Използваме индикатор за ескалация. Чрез него можем да видим, ако някакъв проблем не е решен за дълго време. И аз самият, когато решавам определени задачи, понякога мога да забравя за тях. Ескалацията е добро напомняне, дори когато сам следя.
Като цяло смятам, че качеството на нашата работа се е увеличило значително. Прекъсванията почти не съществуват (или клиентът не успява да ги забележи. Само шшш!), а обемът на работа намаля, а условията на работа станаха по-спокойни. Преходът от авариен труд с латане на пробойни с лента към спокойна и измерима работа, при която много проблеми могат да бъдат предсказани предварително и имаме време, за да ги предотвратим, беше успешен. Дори вече случили се проблеми — беше по-лесно да се решат: преди всичко, научаваме за тях преди клиентите да паникьосат, а второ, често проблемът е свързан с неотдавнашна работа (докато правех едно, счупих друго) — затова е по-лесно да се справим с него на
А ето още един случай…
Знаете ли, че в популярната Debian 9 (Stretch) толкова популярният пакет phpmyadmin все още (от много месеци!) е в статус vulnerable? (). Когато уязвимостта излезе — бързо предприехме мерки, за да я прикрием. Но настроих в okerr следене на страничката на security-tracker, за да знам кога ще излезе 'красивото' решение (чрез SHA1 хеш на съдържанието). Няколко пъти индикаторът ме подсещаше, страницата се променяше, но както виждате — все още (от януари 2019 г.!) не е посочено, че проблемът е решен. Може би, между другото, някой знае какъв е проблемът, който прави този важен пакет vulnerable повече от година?
В друга ситуация подобен: след уязвимост в SSH, бе необходимо да се обновят всички сървъри. Когато поставяш задача — трябва да се контролира изпълнението. (Подчинените имат свойството да не разбират, да забравят, да се объркват, да правят грешки). Затова първо добавихме в okerr проверка за версията на SSH на всички сървъри и чрез okerr следяхме, за да се уверим, че актуализациите са прилагани на всички сървъри. (Удобно! Избрал съм този тип индикатор и веднага е видно на кой сървър коя версия е). Когато се уверихме, че задачата е изпълнена на всички сървъри — премахнахме индикаторите.
Пару пъти имаше ситуация, че някакъв проблем възниква, а после сам преминава. (вероятно всички знаете за това?). Докато забележиш, докато провериш — а там вече и за проверка няма — всичко вече работи добре. Но после пак се чупи. При нас имаше, например, с продуктите, които зареждахме в Amazon Marketplace (MWS). В някакъв момент зареденото inventory беше неправилно (не същите количества продукти и не тези цени). Разбрахме се. Но за да разберем — важно беше да узнаем за проблема веднага. За съжаление, MWS както всички услуги на амазон — е малко бавен, така че винаги имаше закъснение, но все пак — успяхме поне приблизително да уловим връзката между проблема и скриптовете, които го предизвикват (направихме проверка, свързахме я с окерра и проверявахме веднага след получаване на алерт).
Наскоро добавихме интересен случай в нашето портфолио, свързан с един голям и скъп европейски хостинг провайдер, който ползва наш клиент. Изведнъж всички наши сървъри изчезнаха от радарите! Първоначално клиентът сам забеляза (по-бързо от Okerr!), че сайтът, с който работеше, не се отваря и подаде тикет относно това. Но проблемът не беше само с един сайт, а с всички! (Наташа, всички сървъри паднаха!). След това и Okerr започна да изпраща дълги анализи с всички индикатори, които се бяха включили. Паника-паника, тичаме в кръгове (а какво друго да правим?). След това всичко беше възстановено. Оказа се, че в data центъра имаше рутинна работа (веднъж на много години) и те, разбира се, трябваше да ни уведомят. Но им се случи нещо и не ни предупредиха. Ами, инфаркт с инфаркт, не е голяма работа. Но след възстановяването — трябва всичко да се провери! Не мога да си представя как бих го направил сам. Okerr тестира всичко за няколко минути. Оказа се, че по-голямата част от сървърите просто бяха временно недостъпни, но работеха. Някои се рестартираха, но също се върнаха на линия. От всичките загуби — загубихме два бэкапа, които по график трябваше да се създадат и качат по време на този пълен хаос. Нямаше да ги създавам, но след 24 часа получихме уведомления, че всичко е ОК, бэкаповете се появиха. Този пример ми харесва много, защото Okerr се оказа много полезен в ситуация, за която дори не сме мислили предварително, но именно в това е задачата на мониторинга — да се противопоставя на непредсказуемото.
За сензорите на Okerr използваме най-евтините хостинги (качество и надеждност там не са важни, те се застраховат взаимно). Та, наскоро намерихме много добър хостинг на супер ниска цена, бенчмарковете са невероятни. Но… понякога се оказва, че изходящите връзки от виртуалната машина се извършват с друг (съседен) IP. Чудеса. Модулът client_ip с получава грешния IP. А и от сървърните логове на индикатора се вижда, че ъпдейтът е дошъл също от този съседен IP. Сега се разбираме със сапорта. Добре, че забелязахме това в спокойно време. Но, например, често се случва, когато достъпът е ограничен до бял списък IP — и ако сърверът понякога мигновено бърка, може да отнеме много време, за да хванем този проблем.
И още нещо — щом заговорихме за VPS хостинг — ние винаги използваме икономични (hetzner, ovh, scaleway). Както по бенчмаркове, така и по стабилност — много сме доволни. Използваме и доста по-скъп Amazon EC2 за други проекти. И така, благодарение на okerr, имаме обосновано мнение. Падат — и двете. И бих казал, че за дългото време на нашите наблюдения, евтините хостинги като hetzner не се оказаха значително по-недостоверни от EC2. Затова, ако не сте обвързани с други функции на Amazon — защо да плащате повече? 🙂
Какво следва?
Ако на този етап все още не съм ви уплашил от Okerr — опитайте! През този линк можете да влезете в (Кликнете веднага!). Но имайте предвид — че демо акаунтът е един за всички, следователно, ако правите нещо — някой друг в същия акаунт може да ви пречи в същото време. Или (по-добре) се регистрирайте през линка на — всичко е просто, без SMS. Ако не обичате да използвате истинския си имейл — можете да използвате еднократен, например от mailinator (Препоръчвам ). Тези акаунти с времето могат да бъдат изтривани — но за тестове са подходящи.
След регистрацията ще ви бъде предложено да преминете обучение (да изпълните няколко не много сложни обучителни задачи). Първоначалните лимити са много малки, но за обучение или един сървър са достатъчни. След преминаването на обучението — лимитите (например, максималното количество индикатори) ще бъдат увеличени.
От документацията — на първо място за сървърната част и за клиента (). Но ако нещо не е ясно — пишете на support (at) okerr.com или оставяйте тикет — ще се опитаме да решим всичко бързо.
Ако планирате да използвате сериозно и тези повишени лимити няма да са достатъчни — също пишете в сапорта, ще увеличим (безплатно).
Искате да инсталирате сървър okerr на своя сървър? Ето . Препоръчваме да инсталирате на чиста виртуална машина, така че да е лесно с инсталационния скрипт. На вашата виртуалка — никакви ограничения :-). И отново — ако е необходимо — ще се постараем да помогнем.
Искаме проектът да успее, за да направим света по-безопасен. С безплатния софтуер и услуги светът стана по-приветлив и се развива динамично. Изходният код може да се съхранява в безплатен GitHub, а за имейл можем да използваме безплатен Gmail. Ние използваме безплатен за поддръжка. Няма нужда да плащате за сървъри, да сваляте и настройвате или да решавате различни проблеми с експлоатацията. Всеки нов проект, всяки екип — веднага получава имейл, хранилища и CRM. И всичко това е с високо качество, безплатно и готово веднага. Искаме да е също така за мониторинг — малките компании и проекти да могат безплатно да използват okerr и дори на етапа на раждане и растеж да имат стабилност като големи сериозни проекти.
Източник: habr.com
