

Здравей, Хабр!
Днес искам да споделя за нашия опит с автоматизацията на резервното копиране на големи данни хранилища Nextcloud в различни конфигурации. Работя като CTO в "Мълния АК", където се занимаваме с конфигурационно управление на IT системи, а за съхранение на данни използваме Nextcloud. Включително и с разпределена структура с резервиране.
Проблемите произтичат от особеностите на инсталацията, тъй като данните са много. Версионирането, което предоставя Nextcloud, резервирането, субективните причини и други, създават множество дубли.
Предистория
При администрирането на Nextcloud належаща става проблемът с организирането на ефективно резервно копие, което задължително трябва да бъде криптирано, тъй като данните са ценни.
Предлагаме опции за съхранение на резервно копие при нас или при клиента на отделни от Nextcloud машини, което изисква гъвкав и автоматизиран подход към администрирането.
Има много клиенти, всеки с различни конфигурации, и всички на свои площадки с уникални особености. Стандартната методика, когато цялата площадка принадлежи на вас и резервните копия се правят от cron, не работи добре.
Първо, нека да разгледаме входните данни. Нуждаем се от:
- Мащабируемост в плановете за една или няколко единици. За големи инсталации използваме minio като хранилище.
- Да разберем за проблемите с изпълнението на резервното копие.
- Необходимо е да се съхранява резервното копие при клиентите и/или при нас.
- Бързо и лесно справяне с проблеми.
- Клиентите и инсталациите се различават значително помежду си - не можем да постигнем единство.
- Скоростта на възстановяване трябва да бъде минимална в два сценария: пълно възстановяване (катастрофа) и възстановяване на една папка - изтрита по грешка.
- Функцията за дедупликация е задължителна.
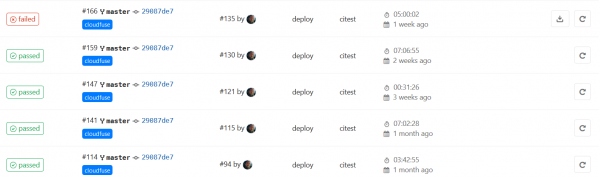
За решението на задачата за управление на резервните копия интегрирахме GitLab. Повече информация ще предоставим по-късно.
Безспорно, не сме първите, които решават подобен проблем, но смятаме, че нашият практически опит, изстрадан от опит, може да бъде интересен и сме готови да го споделим.
Тъй като в нашата компания е приета политика на open-source, ние търсихме решение именно с отворен код. От своя страна споделяме нашите разработки и ги публикуваме. Например, в GitHub има , който инсталираме на клиентите, за да подобрим защитата на данните в случай на случайно или преднамерено изтриване.
Средства за резервно копиране
Започнахме търсенето на методи за решение с подбора на средство за създаване на резервна копия.
Обикновеният tar + gzip работи лошо — данните се дублират. Инкременталът често съдържа много малко промени, а голяма част от данните в един файл се повтарят.
Има още един проблем — излишъкът в разпределеното хранилище на данни. Използваме minio и данните му по принцип са излишни. Либо е следвало да направим резервно копие през самия minio – да го натоварим и да ползваме всички интерфейси между файловата система, и не по-малко важно, съществува риск да забравим за част от бакетите и мета-информацията. Либо да използваме дедупликация.
Инструменти за резервно копиране с дедупликация има в опенсорс (в Хабра бяха ) и нашите финалисти станаха и . За нашето сравнение на двете приложения по-долу, а сега ще разкажем как организирахме цялата схема.
Управление на създаването на резервни копия
Borg и Restic са добри, но нито един от двата продукта няма централен механизъм за управление. За целите на управлението и контрола избрахме инструмент, който вече е внедрен у нас, без който не можем да си представим работата, включително в автоматизацията – това е известният CI/CD – GitLab.
Идеята е следната: на всеки възел, който съхранява данни Nextcloud, се инсталира gitlab-runner. Рънърът стартира по график скрипт, който следи процеса на резервно копиране, и той стартира Borg или Restic.
Какво получихме? Обратна връзка от изпълнението, удобен контрол върху промените, детайли в случай на грешка.
Ето публикувахме примери на скрипт за различни задачи, а ние в крайна сметка го свързахме с бекъпа не само на Nextcloud, но и на много други услуги. Там също е планировчикът, ако не ти се ще да го настройваш ръчно (а на нас не ни се иска) и .gitlab-ci.yml.
В API на GitLab за момента няма възможност да се променя таймаута на CI/CD, а той е малък. Трябва да го увеличим, да речем до 1d.
GitLab, за щастие, може да стартира не само по комит, но и по график, точно това ни е необходимо.
Сега за обвивката на скрипта.
Поставихме следните условия за този скрипт:
- Трябва да се стартира както от рънър, така и ръчно от консолата с еднаква функционалност.
- Задължително трябва да има обработчици на грешки:
- код на върнато значение.
- търсене на низ в логовете. Например, за нас грешка може да бъде съобщение, което програмата не счита за фатално.
- Обработка на таймаут. Времето за изпълнение трябва да е разумно.
- Нужен подробен лог. Но само лишь в случай на грешка.
- Провеждат се и ред тестове преди започването.
- Малки удобства, които намерихме за полезни по време на поддръжката:
- Стартиране и приключване се записва в системния лог на локалната машина. Това помага да свържем системни грешки и работата на бекапа.
- Част от логовете за грешки, когато има такива, се извеждат в stdout, целият лог се записва в отделен файл. Удобно е веднага да погледнем в CI и да оценим грешката, ако е тривиална.
- Режими за дебъг.
Пълният лог се съхранява като артефакт в GitLab, ако няма грешки, логът се изтрива. Скриптът е написан на bash.
Ще се радваме да разгледаме всякакви предложения и забележки относно опенсорса — добре дошли.
Как работи това
На нодата, която се архивира, се стартира раннер с bash екзекутор. В специално хранилище по планировчика се стартира CI/CD job. Раннерът стартира скрипт - универсална обвивка за подобни задачи, в него преминават проверки за валидност на хранилището за архив, точки на монтаж и всичко, което поискаме, след това се извършва архивиране и почистване на старото. Самият готов архив се изпраща на S3.
Работим по такава схема — това е външен доставчик AWS или руски аналог (по-бързо е и данните не напускат РС). Либо поставяме отделен minio клъстер на площадката на клиента за тези цели. Обикновено го правим по съображения за сигурност, когато клиентът не иска данните да напускат контур.
Не използвахме функцията за изпращане на бекапа по ssh. Така не добавя сигурност, а мрежовите възможности на доставчика S3 са значително по-високи от една наша ssh машина.
За да се защитим от хакер на локалната машина — тъй като той може да изтрие данни на S3, е задължително да активираме версионирането.
Бекаперът винаги шифрова бекапа.
При Borg има режим без шифровка. none, но настойчиво не препоръчваме да го включвате. В този режим няма не само шифроване, но и не се изчислява контролна сума на записваното, следователно целостта може да се провери само индиректно, по индексите.
С отделен шедулър се извършва проверка на бекъпите за целостта на индексите и съдържанието. Проверка се извършва бавно и дълго, затова я стартираме отделно веднъж месечно. Може да отнеме няколко дни.
Ридми на български
Основни функции
prepareподготовкаtestcheckпроверка на готовностmaincommandосновна командаforcepostscriptфункция, която се изпълнява в края или при грешка. Използваме я за демонтиране на дял.
Функции на услугата
cleanupзаписваме грешки или изтриваме лог файл.checklogпарсим лог за наличие на грешка.retexit handler.checktimeoutпроверка на таймаут.
Околна среда
VERBOSE=1извеждаме грешки на екрана веднага (stdout).SAVELOGSONSUCCES=1запазваме лог при успех.INIT_REPO_IF_NOT_EXIST=1Създаваме репозиторий, ако такъв не съществува. По подразбиране е изключен.TIMEOUTмаксимално време за основната операция. Можете да го зададете като ‘m’, ‘h’ или ‘d’ в края.
Режим на съхранение на стари копия. По подразбиране:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Променливи вътре в скрипта
ERROR_STRING— низ за проверка в лог за грешка.EXTRACT_ERROR_STRING— израз за показване на низ при грешка.KILL_TIMEOUT_SIGNAL— сигнал за убиване при таймаут.TAIL— колко низа с грешки да се показват на екрана.COLORMSG— цвят на съобщението (по подразбиране жълт).
Този скрипт, наречен wordpress, е условно име, неговата особеност е в това, че също така прави бекъп на mysql базата. Следователно може да се използва за еднократни инсталации на Nexcloud, където също можете да бекъпите базата. Удобството не е само в това, че всичко е на едно място, но и че съдържанието на базата е близко до съдържанието на файловете, тъй като разликата във времето е минимална.
Restic vs Borg
Сравненията на Borg и Restic са налични, включително , и ние не целяхме просто да направим още едно, а свое. Важно за нас беше как това ще изглежда на нашите данни, с нашата специфика. Ние сме ги приведели.
Нашите критерии за избор, освен вече споменатите (дедупликация, бързо възстановяване и др.):
- Устойчивост на недовършена работа. Проверка на kill -9.
- Размер на диска.
- Изисквания към ресурсите (ЦПУ, памет).
- Размер на съхраняваните блобове.
- Работа с S3.
- Проверка на целостта.
За теста взехме един клиент с реални данни и общ размер 1.6Тб.
Условия.
Borg не може да работи директно с S3, и ние го монтирахме като fuse диск, чрез . Restic изпращаше в S3 сам.
Goofys работи много бързо и добре, и към него има , което още повече ускорява работата. Той е в бета версия и, признавам, падна при тестовете с загуба на данни (други). Но удобството е в това, че самата процедура за бекъп не изисква голямо четене, а основно запис, затова кеша използваме само по време на проверка на целостта.
За да намалим влиянието на мрежата, използвахме местен провайдер — Яндекс Облако.
Резултати от тестовете на сравнението.
- Kill -9 с последващо рестартиране, и двата минаха успешно.
- Размер на диска. Borg може да компресира, затова очакваните резултати са.
Backuper
Размер
Borg
562Гб
Restic
628Гб
- По CPU
Сам по себе си borg използва малко, с дефолтна компресия, но трябва да се оценява заедно с процеса goofys. Като цяло те са сравними и използват около 1.2 ядра на една и съща тестова виртуалка. - Памет. Restic приблизително 0.5Гб, Borg около 200Мб. Но всичко това е незначително в сравнение с файловия кеш на системата. Затова е желателно да се отдели повече памет.
- Разликата в размера на блобовете се оказа значителна.
Backuper
Размер
Borg
около 500Мб
Restic
около 5Мб
- Работата с S3 от Restic е отлична. Работата на Borg през goofys не предизвиква въпроси, но е забелязано, че е желателно след приключване на резервното копие да се направи umount, за да се нулира напълно кеша. Особеност на работата с S3 е, че недоизтеглените чанкове никога няма да бъдат изпратени в бакета, а това означава, че непълно заредените данни водят до големи повреди.
- Проверка на целостта работи добре и в двата случая, но скоростта се различава значително.
Restic – 3.5 часа.
Borg, с файлов кеш от 100Гб SSD – 5 часа. Приблизително такъв същия резултат по скорост, ако данните са на локален диск.
Borg чете директно от S3 без кеш 33 часа. Ужасно дълго.
В крайна сметка Borg може да компресира и има по-големи блобове — което прави съхранението и операциите GET/PUT в S3 по-евтини. Но за това плащате с по-сложна и бавна проверка. Що се отнася до скоростта на възстановяване — не забелязахме разлика. Последващите резервни копия (след първото) restic прави малко по-дълго, но незначително.
Размерът на общността не беше на последно място в избора.
И ние избрахме borg.
Няколко думи за компресията
Borg разполага с прекрасен нов компресионен алгоритъм — zstd. По качество на компресията не е по-лош от gzip, но е значително по-бърз. И е сравним по скорост с дефолтния lz4.
Например, дамп на MySQL база се компресира два пъти по-добре от lz4 при същата скорост. Въпреки това, опитът с реални данни показва, че разликата в степента на компресия на нодата Nextcloud е много малка.
В Borg има доста бонусен режим на компресия — ако файлът има висока ентропия, то компресията изобщо не се прилага, което увеличава скоростта на работа. Активира се с опция при създаване
-C auto,zstd
за алгоритъма zstd
Така че с тази опция в сравнение с компресията по подразбиране получихме
560Gb и 562Gb съответно. Данните от примера по-горе, припомням, без компресия резултатът е 628Gb. Резултатът с разликата от 2Гб ни изненада, но решихме все пак да изберем. auto,zstd.
Метод за проверка на резервно копие
По планираното, виртуалната машина се стартира директно при доставчика или при клиента, което значително намалява мрежовото натоварване. По този начин е поне по-евтино, отколкото да я стартираме у нас и да пренасочваме трафика.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https://storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/
borg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
По същия начин проверяваме файловете с антивирус (постфактум). Потребителите качват различни файлове в Nextcloud и не всички разполагат с антивирус. Проверката по време на качване отнема твърде много време и пречи на бизнеса.
Мащабируемостта се постига чрез стартиране на ранери на различни възли с различни тагове.
В нашия мониторинг се събират статусите на резервните копия чрез API GitLab в едно прозорец, при необходимост проблемите лесно се забелязват и също така лесно се локализират.
Заключение
В крайна сметка знаем, че правим резервни копия, че нашите резервни копия са валидни, а проблемите, които възникват с тях, отнемат малко време и се решават на ниво дежурен администратор. Резервните копия заемат наистина малко място в сравнение с tar.gz или Bacula.
Източник: habr.com
