

Преводът на статията е подготвен в очакване на старта на курса .
Как да спестите от облачните разходи при работа с Kubernetes? Няма едно единствено правилно решение, но в тази статия са описани няколко инструмента, които ще ви помогнат да управлявате ресурсите по-ефективно и да намалите разходите за облачни изчисления.
Написах тази статия с оглед на Kubernetes за AWS, но тя ще бъде приложима (почти) по същия начин и за други облачни доставчици. Предполагам, че вашият клъстер(и) вече има настроено автоматично мащабиране (). Премахването на ресурси и намаляването на мащаба на внедряването ще спести средства, само ако също така намали вашия парк от работни възли (EC2 инстанции).
В тази статия ще бъдат разгледани:
- очистка на неизползвани ресурси ()
- намаляване на мащабирането в неработно време ()
- използване на хоризонтално автоматично мащабиране (HPA),
- намаляване на излишното резервиране на ресурси (, VPA)
- използване на Spot инстанции
Очистка на неизползвани ресурси
Работата в бързо променяща се среда е чудесна. Искаме технологичните организации . По-бързото доставяне на софтуер също означава повече PR внедрения, среди за предварителен преглед, прототипи и аналитични решения. Всичко се внедрява на Kubernetes. Кой има време да чисти тестови внедрения на ръка? Лесно е да забравите да премахнете експеримента от преди седмица. Сметката за облак в крайна сметка ще нараства поради факта, че забравяме да затворим:
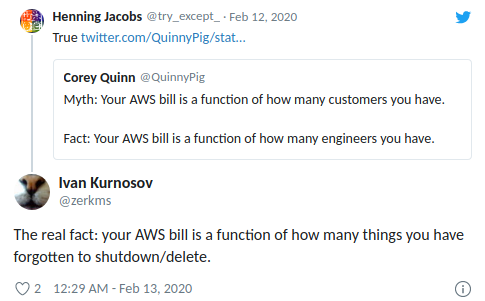
(Хенинг Якобс:
Истинска работа:
(цитира) Кори Куин:
Мит: Вашата AWS сметка е функция на броя на потребителите ви.
Факт: Вашата AWS сметка е функция на броя на инженерите ви.
Иван Курносов (в отговор):
Истински факт: Вашата AWS сметка е функция на броя на нещата, които сте забравили да изключите/премахнете.)
(kube-janitor) помага да се почисти клъстера ви. Конфигурацията на janitor е гъвкава за глобално и локално използване:
- Общите правила за целия клъстер могат да определят максималното време на живот (TTL - time-to-live) за PR/тестови внедрения.
- Отделни ресурси могат да бъдат анотиране с janitor/ttl, например, за автоматично изтриване на spike/прототипа след 7 дни.
Общите правила се определят в YAML файл. Неговият път се предава чрез параметър --rules-file в kube-janitor. Ето пример за правило за изтриване на всички имена на пространства с -pr- в името след два дни:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Следният пример регламентира използването на етикет application в Deployment и StatefulSet подовете за всички нови Deployments/StatefulSet през 2020 година, но в същото време позволява изпълнението на тестове без този етикет в течение на седмица:
- id: require-application-label
  # изтриване на deployments и statefulsets без етикет "application"
  resources:
    - deployments
    - statefulsets
  # вижте http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Стартиране на ограничено по време демо в течение на 30 минути в клъстера, където работи kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Още един източник на растящи разходи са постоянните томове (AWS EBS). При изтриване на Kubernetes StatefulSet постоянните томове (PVC — PersistentVolumeClaim) не се изтриват. Неизползваните EBS обеми могат лесно да доведат до разходи от стотици долари на месец. Kubernetes Janitor има функция за почистване на неизползвани PVC. Например, това правило ще изтрие всички PVC, които не са монтирани от модула и на които не се позовава StatefulSet или CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor може да ви помогне да запазите клъстера си "чист" и да предотвратите бавно нарастващите разходи за облачни изчисления. За инструкции по разгръщане и настройка, следвайте в .
Намаляване на мащаба в неработно време
Тестовите и междинни системи обикновено са необходими само по време на работно време. Някои производствени приложения, като бек-офис/инструменти за администратори, също изискват само ограничена наличност и могат да бъдат изключени през нощта.
(kube-downscaler) позволява на потребителите и операторите да намалят мащаба на системата извън работното време. Deployments и StatefulSets могат да бъдат мащабирани до нулеви реплики. CronJobs могат да бъдат спирани. Kubernetes Downscaler се настройва за целия клъстер, едно или повече пространства от имена или индивидуални ресурси. Може да бъде зададено или "време на неизправност", или обратно "време на работа". Например, за да се намали максимално мащабът през нощта и през уикендите:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # не изключвайте инфраструктурните компоненти
  - --exclude-namespaces=kube-system,infra
  # не изключвайте kube-downscaler, а също така оставете Postgres Operator, за да могат да се управляват изключените БД
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Ето график на мащабирането на работните възли на клъстера през уикендите:
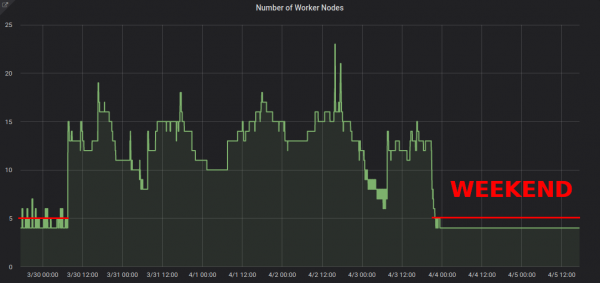
Намаляването на мащаба от ~13 до 4 работни възли несъмнено има значително влияние върху сметката в AWS.
Но какво, ако трябва да работя през "времето на неизправност" на клъстера? Определени разгръщания могат да бъдат трайно изключени от мащабиране, като се добави анотация downscaler/exclude: true. Разгръщанията могат временно да бъдат изключени с помощта на анотация downscaler/exclude-until с абсолютен таймстамп в формат YYYY-MM-DD HH:MM (UTC). При необходимост целият клъстер може да бъде мащабиран обратно, като се разгръща под с анотация downscaler/force-uptime, например, чрез стартиране на nginx образец:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # да се изтрие разгръщането след час
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Вижте , ако ви интересува инструктаж за разгръщане и допълнителни опции.
Използвайте хоризонтално автоматично мащабиране
Много приложения/услуги работят с динамична схема на натоварване: понякога техните модули са неактивни, а понякога работят на максимален капацитет. Работата с постоянен парк от подове за справяне с максималната натовареност не е икономически изгодна. Kubernetes поддържа хоризонтално автоматично мащабиране чрез ресурса (HPA). Използването на ЦП често е добър показател за мащабиране:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando създаде компонент за лесно свързване на персонализирани метрики за мащабиране: (kube-metrics-adapter) е универсален адаптер за метрики за Kubernetes, който може да събира и обслужва персонализирани и външни метрики за хоризонтално авто мащабиране на подовете. Той поддържа мащабиране на основата на метрики от Prometheus, SQS опашки и други настройки. Например, за да мащабирате разполагане за персонализирана метрика, представена от самото приложение във формат JSON в /metrics, използвайте:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Настройката за хоризонтално авто мащабиране с HPA трябва да бъде една от действията по подразбиране за повишаване на ефективността за услуги без съображения за състояние. Spotify има презентация с опити и препоръки за HPA: .
Намаляване на излишното резервиране на ресурси
Работните натоварвания в Kubernetes определят нуждите си от CPU/памет чрез „заявки за ресурси“ (resource requests). Ресурсите на CPU се измерват във виртуални ядра или по-често в „милиядра“ (millicores), например 500m предполага 50% vCPU. Ресурсите на паметта се измерват в байтове и могат да използват обичайни суфикси, например 500Mi, което означава 500 мегабайта. Заявките за ресурси „блокират“ обем на работните възли, тоест модул с заявка за CPU от 1000m на възел с 4 виртуални CPUs ще остави само 3 виртуални CPUs налични за други модули.
Slack (излишък от резерв) — това е разликата между заявените ресурси и реалната употреба. Например, под, който заявява 2 GiB памет, но използва само 200 MiB, има ~ 1,8 GiB "излишна" памет. Излишъкът струва пари. Може грубо да се оцени, че 1 GiB излишна памет струва ~ 10 долара на месец.
(kube-resource-report) показва излишните резерви и може да помогне да определите потенциала за спестяване:
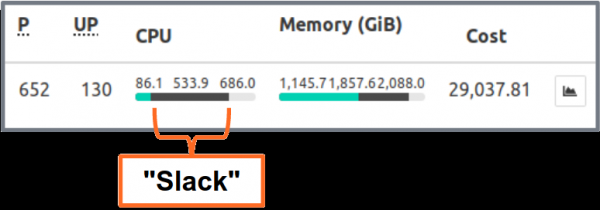
показва излишъка, агрегриран от приложението и екипа. Това позволява да се намерят места, където заявките за ресурси могат да бъдат намалени. Генерираният HTML отчет предоставя само моментна снимка на използването на ресурса. Трябва да наблюдавате използването на процесора/паметта с течение на времето, за да определите адекватни заявки за ресурси. Ето графика на Grafana за "типична" услуга с голямо натоварване на ЦП: всичките подове използват значително по-малко от 3 заявени ядра ЦП:
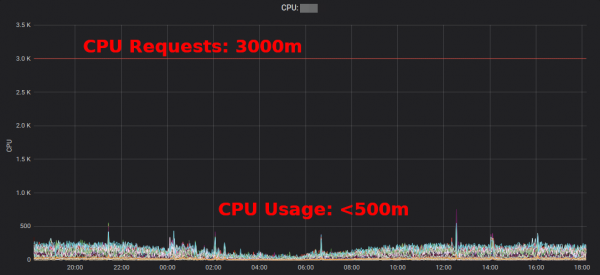
Намаляването на заявката за ЦП от 3000m до ~400m освобождава ресурси за други работни натоварвания и позволява намаляване на клъстера.
"Средното използване на ЦП на EC2 инстанции често варира в диапазона на еднозначни проценти", — . Докато за EC2 , промяната на някои заявки за ресурси в Kubernetes YAML файла става лесно и може да донесе огромни спестявания.
Но наистина ли искаме хората да променят стойности в YAML файловете? Не, машините могат да го правят много по-добре! Kubernetes (VPA) точно това прави: адаптира заявките за ресурси и ограниченията в съответствие с работното натоварване. Ето примерна графика на заявките за ЦП в Prometheus (тънка синя линия), адаптирани от VPA с течение на времето:
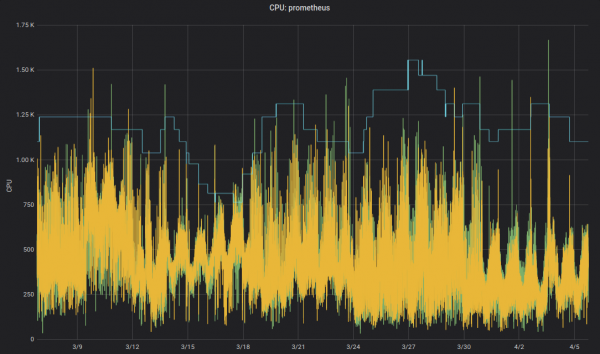
за компоненти на инфраструктурата. Некритичните приложения също могат да използват VPA.
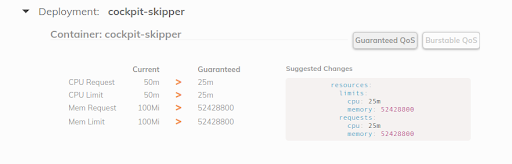
от Fairwind — това е инструмент, който създава VPA за всяко разгръщане в пространството от имена и след това показва препоръка VPA на своята информационна табло. Той може да помогне на разработчиците да установят правилните заявки за процесор/памет за своите приложения:
Написах малък през 2019 година, и скоро .
Използването на EC2 Spot инстанции.
Накрая, не на последно място, разходите за AWS EC2 могат да бъдат намалени, използвайки Spot инстанции като работни възли на Kubernetes. . Spot инстанциите са налични със спестявания до 90% в сравнение с цените по запитване. Стартирането на Kubernetes на EC2 Spot е добра комбинация: трябва да посочите няколко различни типа инстанции за по-висока наличност, тоест можете да получите по-голям възел за същата или по-ниска цена, а увеличената капацитет може да бъде използвана от контейнерни работни натоварвания на Kubernetes.
Как да стартирате Kubernetes на EC2 Spot? Има няколко опции: да използвате трета страна услуга, като SpotInst (сега просто се нарича „Spot“, не ме питайте защо), или просто да добавите Spot AutoScalingGroup (ASG) към вашия клъстер. Например, ето фрагмент от CloudFormation за за „оптимизирана по капацитет“ Spot ASG с няколко типа инстанции:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Някои бележки относно използването на Spot с Kubernetes:
- Трябва да се справяте с прекратяването на Spot, например чрез изчистване на възела при спиране на инстанцията.
- Zalando използва официалната автомасштабираща функция на клъстера с приоритети за пулове от възли.
- Spot възлите да приемат "регистрации" на работни натоварвания за стартиране в Spot.
Резюме
Надявам се, че ще намерите някои от предложените инструменти полезни за намаляване на вашата облачна сметка. Можете да намерите по-голямата част от съдържанието на статията и в .
Какви са вашите най-добри практики за спестяване на облачни разходи за Kubernetes? Моля, дайте ми знак в .
На практика по-малко от 3 виртуални CPU ще останат годни за използване, тъй като пропускната способност на възела намалява поради резервираните системни ресурси. Kubernetes различава физическата капацитет на възела и "разпределените" ресурси ().
Пример за изчисление: един екземпляр m5.large с 8 GiB памет струва ~$84 на месец (eu-central-1, On-Demand), т.е. блокирането на 1/8 от възела струва около ~$10 на месец.
Има много начини да намалите сметката си за EC2, като резервирани екземпляри, план за спестявания и т.н. — няма да обсъждам тези теми тук, но определено трябва да се запознаете с тях!
Източник: habr.com
