

Структуриране на неструктурирани данни с GROK
Ако използвате Elastic стека (ELK) и имате интерес към свързването на потребителски журнали Logstash с Elasticsearch, то тази публикация е за вас.
ELK стекът е съкращение за три проекта с отворен код: Elasticsearch, Logstash и Kibana. Заедно те образуват платформа за управление на журналите.
- Elasticsearch е система за търсене и анализ.
- Logstash е серверен конвейер за обработка на данни, който приема данни от множество източници едновременно, преобразува ги и след това ги изпраща в "хранилище", например Elasticsearch.
- Kibana позволява на потребителите да визуализират данни чрез диаграми и графики в Elasticsearch.
Beats се появи по-късно и е лек грузоотправител на данни. Въвеждането на Beats трансформира ELK стека в Elastic Stack, но това не е основното.
Тази статия е посветена на Grok, която е функция в Logstash, която може да преобразува вашите журнали, преди да бъдат изпратени в хранилището. За нашите цели ще говоря само за обработката на данни от Logstash в Elasticsearch.
Grok е филтър в Logstash, който се използва за разбиране на неструктурирани данни в нещо структурирано и подлежащо на запитване. Той е над регулярното изражение (regex) и използва текстови шаблони за съпоставяне на редове в журналите.
Както ще видим в следващите секции, използването на Grok е от голямо значение, когато става въпрос за ефективно управление на журналите.
Без Grok вашите данни от журналите са неструктурирани.
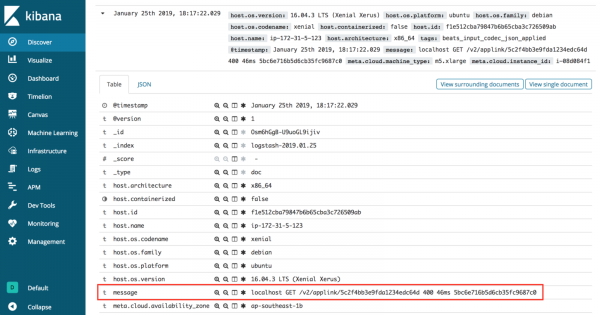
Без Grok, когато журналите бъдат изпратени от Logstash в Elasticsearch и визуализирани в Kibana, те се появяват само като стойност на съобщението.
Запитването за значима информация в тази ситуация е затруднено, тъй като всички данни от журналите се съхраняват в един ключ. Би било по-добре, ако съобщенията от журналите бяха организирани по-добре.
Неструктурирани данни от журналите
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Ако погледнете внимателно необработените данни, ще видите, че те всъщност се състоят от различни части, всяка от които е разделена с интервал.
За по-опитни разработчици вероятно можете да познаете какво означава всяка от частите и че това е съобщение от журнала от API повикване. Представено е значението на всеки елемент по-долу.
Структурираният вид на нашите данни
- localhost == среда
- GET == метод
- /v2/applink/5c2f4bb3e9fda1234edc64d == url
- 400 == response_status
- 46ms == response_time
- 5bc6e716b5d6cb35fc9687c0 == user_id
Както виждаме в структурирани данни, съществува ред за неструктурирани журнали. Следващата стъпка е програмна обработка на суровите данни. Тук Grok блести.
Grok шаблони
Вградените Grok шаблони
Logstash идва с повече от 100 вградени шаблона за структуриране на неструктурирани данни. Определено трябва да се възползвате от това, когато е възможно за общи системни журнали, като apache, linux, haproxy, aws и така нататък.
Но какво става, когато имате потребителски журнали, като в примера по-горе? Трябва да си изградите свой собствен Grok шаблон.
Персонализирани Grok шаблони
Трябва да опитате, за да изградите своя собствен Grok шаблон. Използвах и .
Обърнете внимание, че синтаксисът на Grok шаблони изглежда по следния начин: %{SYNTAX:SEMANTIC}
Първото, което се опитах да направя, беше да отида на таба Discover в Grok отладчика. Помислих си, че би било чудесно, ако този инструмент може автоматично да генерира Grok шаблон, но не беше особено полезно, тъй като намери само две съвпадения.
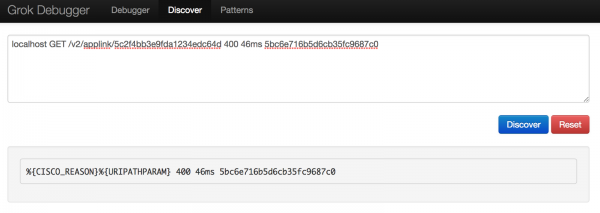
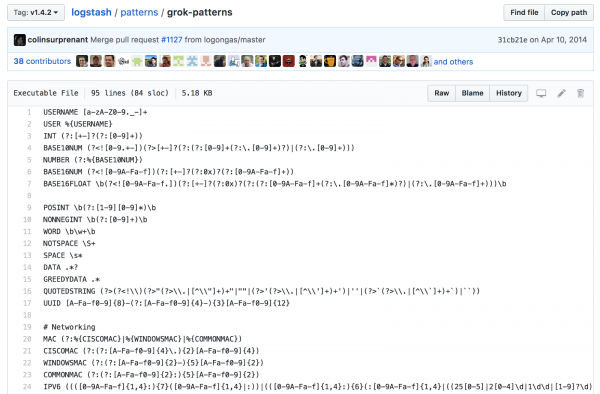
Използвайки това откритие, започнах да изграждам своя собствен шаблон в Grok отладчика, използвайки синтаксиса, намерен на страницата GitHub Elastic.
Като поиграх с различни синтаксиси, накрая успях да структурирам данните от журнала по начина, по който исках.
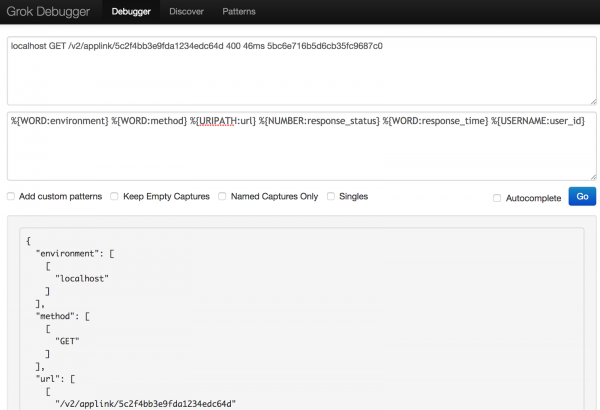
Връзка към Grok отладчика
Изходен текст:
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Шаблон:
%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}Какво постигнах в крайна сметка
{
  "environment": [
    [
      "localhost"
    ]
  ],
  "method": [
    [
      "GET"
    ]
  ],
  "url": [
    [
      "/v2/applink/5c2f4bb3e9fda1234edc64d"
    ]
  ],
  "response_status": [
    [
      "400"
    ]
  ],
  "BASE10NUM": [
    [
      "400"
    ]
  ],
  "response_time": [
    [
      "46ms"
    ]
  ],
  "user_id": [
    [
      "5bc6e716b5d6cb35fc9687c0"
    ]
  ]
}
Сега, когато имам Grok шаблона и съпоставените данни, последната стъпка е да го добавя в Logstash.
Актуализиране на файла Logstash.conf
На сървъра, на който сте инсталирали ELK стека, отидете до конфигурацията на Logstash:
sudo vi /etc/logstash/conf.d/logstash.confПоставете промените.
input {
  file {
    path => "/your_logs/*.log"
  }
}
filter{
  grok {
    match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"}
  }
}
output {
  elasticsearch {
    hosts => [ "localhost:9200" ]
  }
}
След запазване на промените, рестартирайте Logstash и проверете неговото състояние, за да се уверите, че все още работи.
sudo service logstash restart
sudo service logstash status
Накрая, за да се уверите, че промените са влезли в сила, необходимо е да обновите индекса на Elasticsearch за Logstash в Kibana!
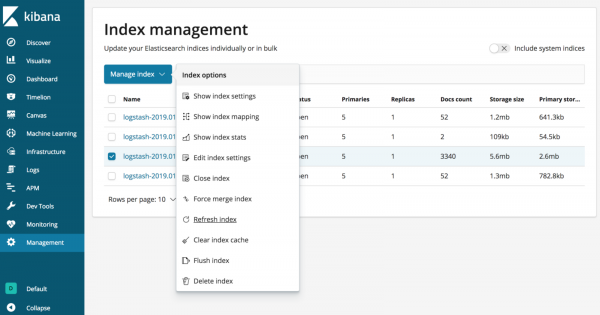
С Grok данните ви от логовете са структурирани!
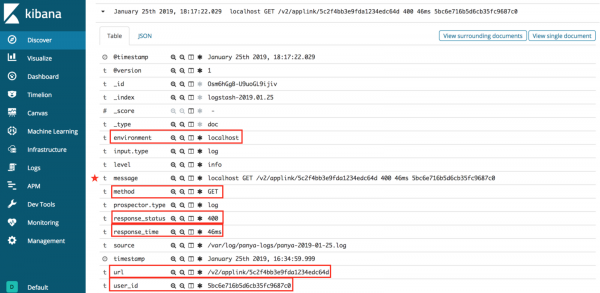
Както виждаме на изображението по-горе, Grok е способен автоматично да съвпада данни от журнала с Elasticsearch. Това улеснява управлението на журналите и бързото извършване на запитвания. Вместо да се рови в файловете на журналите за дебъгване, можете просто да филтрирате това, което търсите, например среда или url адрес.
Опитайте се да дадете шанс на Grok expressions! Ако имате друг начин да го направите или имате някакви проблеми с примерите по-горе, просто напишете коментар по-долу, за да ми съобщите за това.
Благодаря за четенето — и, моля, последвайте ме тук в Medium за още интересни статии по софтуерно инженерство!
Ресурси
P.S
Телеграм-канал за
Източник: habr.com
