

Здравейте! Казвам се Кирил, аз съм CTO в Adapty. По-голямата част от нашата архитектура е на AWS и днес ще ви разкажа как намалихме разходите за сървъри три пъти, благодарение на използването на спотови инстанси в производствени среди, както и как да настроим автоматично мащабиране. Първо ще направя преглед на това как работи, а след това ще предоставя подробна инструкция за стартиране.
Какво представляват спотовите инстанси?
инстанси са сървъри на други потребители на AWS, които в момента не се използват и те ги продават с голяма отстъпка (Amazon пише до 90%, по нашия опит ~3x, варира в зависимост от региона, AZ и типа инстанс). Основната им разлика от обикновените е, че могат да бъдат изключени по всяко време. Затова дълго време смятахме, че е нормално да се използват за дев среди или за задачи за изчисляване на нещо, запазвайки междинни резултати на S3 или в база, но не и за продукция. Съществуват външни решения, които позволяват използването на спотови инстанси в продукция, но там за нашия случай има много проблеми, затова не ги внедрихме. Подходът, описан в статията, работи изцяло в рамките на стандартната функционалност на AWS, без допълнителни скриптове, кронове и т.н.
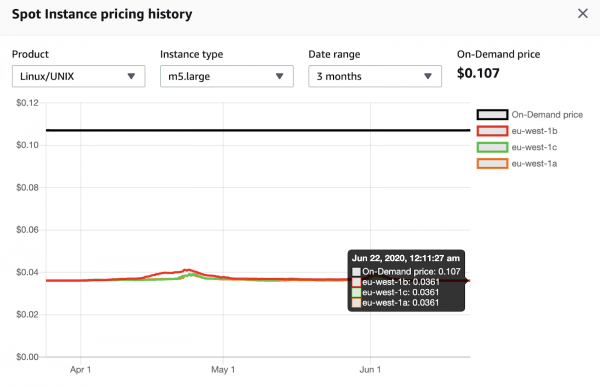
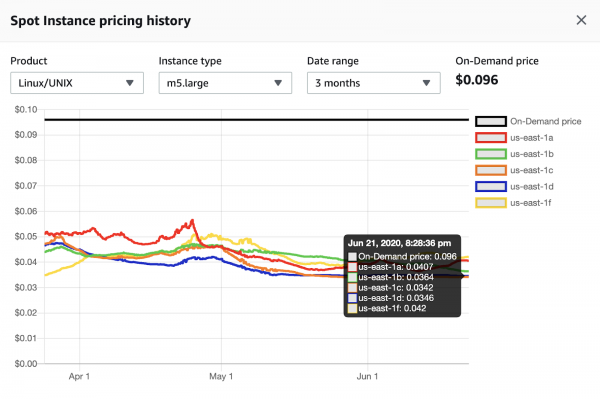
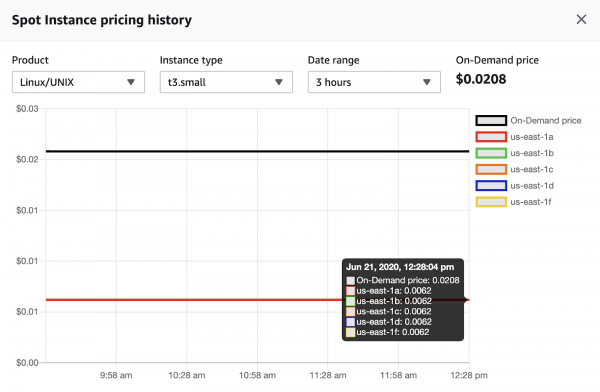
Следващите скрийншотове показват историята на цените на спотовите инстанси.
m5.large в региона eu-west-1 (Ирландия). Цената остава основно стабилна през последните 3 месеца, в момента спестяването е 2.9x.
m5.large в региона us-east-1 (Северна Вирджиния). Цената постоянно се променя през последните 3 месеца, в момента спестяването е от 2.3x до 2.8x в зависимост от зоната на достъп.
t3.small в региона us-east-1 (Северна Вирджиния). Цената е стабилна през последните 3 месеца, в момента спестяването е 3.4x.
Архитектура на услугата
Основната архитектура на услугата, за която ще говорим в тази статия, е показана на диаграмата по-долу.
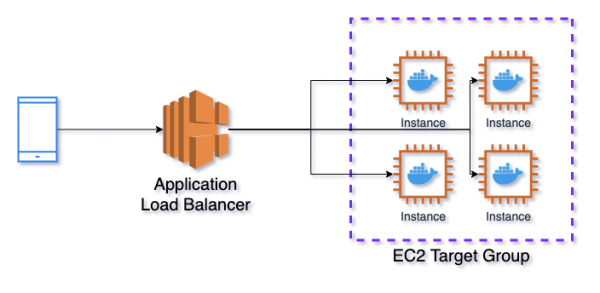
Application Load Balancer → EC2 Target Group → Elastic Container Service
Като балансир се използва Application Load Balancer (ALB), който изпраща заявки към EC2 Target Group (TG). TG отговаря за отварянето на портовете на инстансите за ALB и свързването им с портовете на контейнерите в Elastic Container Service (ECS). ECS е аналог на Kubernetes в AWS, който управлява Docker контейнери.
На един инстанс могат да работят няколко контейнера с идентични портове, затова не можем да ги зададем фиксирано. ECS уведомява TG, че стартира нова задача (в терминологията на Kubernetes това се нарича под), тя проверява свободните портове на инстанса и назначава един от тях за стартиране на задачата. Освен това, TG редовно проверява работоспособността на инстанса и на API-то на него чрез health check и, ако види проблеми, спира да прехвърля заявки към него.
EC2 Auto Scaling Groups + ECS Capacity Providers
На представената по-горе диаграма не е показан услугата EC2 Auto Scaling Groups (ASG). От името може да се разбере, че тя отговаря за мащабирането на инстансите. Досега в AWS не е имало вградено решение за управление на броя стартирани машини от ECS. ECS позволяваше да се мащабира броят на задачите, например, в зависимост от използването на CPU, RAM или броя на заявките. Но когато задачите запълнят всички свободни инстанси, нови машини автоматично не се създаваха.
Това се промени с появата на ECS Capacity Providers (ECS CP). Сега всеки сервис в ECS може да бъде свързан с ASG и ако задачите не се поберат на работещите инстанси, ще бъдат стартирани нови (но в рамките на зададените лимити на ASG). Това работи и в обратната посока; ако ECS CP види бездействуващи инстанси без задачи, той ще нареди на ASG да ги изключи. ECS CP има възможност да зададе целеви процент на натоварване на инстансите, така че известно количество машини винаги да е на разположение за бързо мащабиране на задачите; ще говоря за това по-късно.
EC2 Launch Templates
Последната услуга, за която ще говоря, преди да премина към подробно описание на създаването на тази инфраструктура, е EC2 Launch Templates. Тя позволява да се създаде шаблон, по който всички машини ще бъдат стартирани, за да не се повтаря това всеки път от нулата. Тук можете да изберете типа на стартираната машина, групата за сигурност, имиджа на диска и много други параметри. Също така можете да зададете потребителски данни, които ще бъдат включени на всички стартирани инстанси. В потребителските данни можете да стартирате скриптове, например, можете да редактирате съдържанието на файла .
Един от най-важните параметри на конфигурацията в рамките на тази статия е =true. Ако този параметър е активиран, когато ECS получи сигнал, че спотовият инстанс се изтегля, той прехвърля всички задачи, работещи на него, в статус Draining. Никаки нови задачи няма да бъдат назначавани на този инстанс; ако има задачи, които в момента искат да бъдат изпълнени на него, те ще бъдат отменени. Запитванията от балансировщика също спират да постъпват. Известие за изтриването на инстанса идва 2 минути преди реалното събитие. Следователно, ако вашият сервис не изпълнява задачи повече от 2 минути и не съхранява нищо на диска, можете да използвате спотови инстанси без загуба на данни.
Относно диска — AWS наскоро възможно използването на Elastic File System (EFS) заедно с ECS, с тази схема дори диска не представлява пречка, но не сме го пробвали, тъй като в принцип не ни е нужен диск за съхранение на състояние. По подразбиране, след получаване на SIGINT (изпратен в момента, в който задачата преминава в статус Draining), всички действащи задачи ще бъдат спирани след 30 секунди, дори и да не са завършили, времето може да бъде променено с параметъра . Важно е да не се задава повече от 2 минути за спотови машини.
Създаване на сервис
Преминаваме директно към създаването на описания сервис. В процеса ще опиша още няколко полезни моменти, за които не беше споменато по-горе. Общото е, че това е стъпка по стъпка инструкция, но няма да разглеждам напълно основни или обратна точно много специфични случаи. Всички действия се извършват в визуалната конзола на AWS, но могат да бъдат изпълнени и програмирано с помощта на CloudFormation или Terraform. В Adapty ние използваме Terraform.
EC2 Launch Template
В този сервис се създава конфигурация на машините, които ще се използват. Управлението на шаблоните се извършва в раздела EC2 -> Instances -> Launch templates.
Amazon machine image (AMI) — задаваме образа на диска, с който ще се стартират всички инстанси. За ECS в повечето случаи е добре да използвате оптимизирания образ от Amazon. Той се обновява редовно и съдържа всичко необходимо за работа с ECS. За да разберете актуалния ID на образа, влизате на страницата , избирате използвания регион и копирате AMI ID за него. Например, за региона us-east-1, актуалният в момента ID — ami-00c7c1cf5bdc913ed. Този ID трябва да бъде поставен в пункта Specify a custom value.
Тип на инстанса — посочваме типа инстанция. Избирате този, който най-добре отговаря на вашата задача.
Ключова двойка (вход) — посочваме сертификата, с който ще може да се свържете с инстанцията по SSH, ако е необходимо.
Настройки на мрежата — посочваме параметрите на мрежата. Мрежова платформа в повечето случаи трябва да бъде Virtual Private Cloud (VPC). Групи за сигурност — групи за сигурност за вашите инстанции. Тъй като ще използваме балансироващ пред инстанциите, препоръчвам тук да посочите група, която позволява входящи връзки само от балансироващия. Тоест ще имате 2 групи за сигурност, една за балансироващия, която разрешава входящи соединения от всякъде на портове 80 (http) и 443 (https), и втора за машините, която позволява входящи връзки по всякакви портове от групата на балансироващия. Изходящите връзки в двете групи трябва да бъдат отворени по TCP протокол на всички портове на всички адреси. Можете да ограничите портовете и адресите за изходящи връзки, но тогава трябва постоянно да наблюдавате, че не се опитвате да се свържете някъде по закрит порт.
Съхранение (обем) — посочваме параметрите на дисковете за машините. Обемът на диска не може да бъде по-малък от зададения в AMI, за ECS Optimized — 30 GiB.
Разширени детайли — посочваме допълнителните параметри.
Вариант на покупка — искаме ли да купим спотови инстанции. Искаме, но тук няма да отбелязваме тази отметка, ще настроим това в Auto Scaling Group, там има повече опции.
IAM профил на инстанция — посочваме ролята, с която ще стартирате инстанциите. За да работят инстанциите в ECS, им е нужна роля, която обикновено е в ecsInstanceRole. В някои случаи тя може да бъде създадена; ако няма, то тук как да го направите. След създаването ѝ посочваме я в шаблона.
Следва много параметри, повечето от които може да оставите с подразбиращи се стойности, но всеки от тях има разбираемо описание. Винаги включвам параметрите EBS-optimized instance и T2/T3 Unlimited, ако се използват инстанции.
Потребителски данни — посочваме потребителски данни. Ще редактираме файла /etc/ecs/ecs.config, в който е конфигурацията на агента ECS.
Пример за това как може да изглеждат потребителските данни:
#!/bin/bash
echo ECS_CLUSTER=DemoApiClusterProd >> /etc/ecs/ecs.config
echo ECS_ENABLE_SPOT_INSTANCE_DRAINING=true >> /etc/ecs/ecs.config
echo ECS_CONTAINER_STOP_TIMEOUT=1m >> /etc/ecs/ecs.config
echo ECS_ENGINE_AUTH_TYPE=docker >> /etc/ecs/ecs.config
echo "ECS_ENGINE_AUTH_DATA={"registry.gitlab.com":{"username":"username","password":"password"}}" >> /etc/ecs/ecs.config
ECS_CLUSTER=DemoApiClusterProd — параметърът указва, че инстансът принадлежи на клъстера с даденото име, т.е. този клъстер ще може да разполага своите задачи на този сървър. Все още не сме създали клъстер, но при създаването ще използваме това име.
ECS_ENABLE_SPOT_INSTANCE_DRAINING=true — параметърът указва, че при получаване на сигнал за изключване на спотовия инстанс, всички задачи на него трябва да бъдат преместени в статус Draining.
ECS_CONTAINER_STOP_TIMEOUT=1m — параметърът указва, че след получаване на сигнал SIGINT, всички задачи имат 1 минута, преди да бъдат убити.
ECS_ENGINE_AUTH_TYPE=docker — параметърът указва, че като механизъм за авторизация се използва docker-схема.
ECS_ENGINE_AUTH_DATA=... — параметри за свързване към частен контейнерен регистър, където се съхраняват вашите Docker образи. Ако е публичен, не е необходимо да се указва нищо.
В рамките на тази статия ще използвам публичен образ от Docker Hub, затова не е необходимо да указвам параметри. ECS_ENGINE_AUTH_TYPE и ECS_ENGINE_AUTH_DATA не е необходимо.
Полезно е да се знае: препоръчва се редовно да актуализирате AMI, тъй като в новите версии се актуализират версиите на Docker, Linux, ECS агент и др. За да не забравяте за това, можете за излизането на нови версии. Можете да получавате уведомления на email и ръчно да актуализирате, или да напишете Lambda функция, която автоматично да създава нова версия на Launch Template с актуализирано AMI.
EC2 Auto Scaling Group
Auto Scaling Group отговаря за стартиране и мащабиране на инстансите. Управлението на групите става в раздел EC2 -> Auto Scaling -> Auto Scaling Groups.
Launch template — избираме създадения на предишната стъпка шаблон. Версията оставяме по подразбиране.
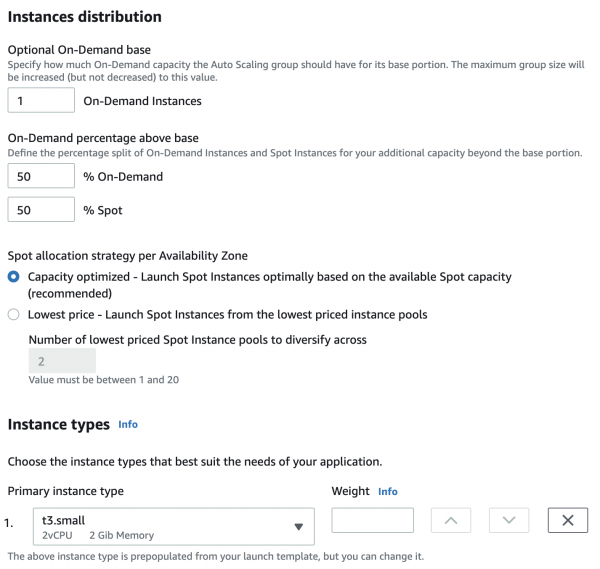
Purchase options and instance types — указваме типовете инстанси за клъстера. Adhere to launch template използва типа инстанс от Launch Template. Combine purchase options and instance types позволява гъвкаво настройване на типовете инстанси. Ще използваме него.
Optional On-Demand base — количеството обикновени, не спотови инстанси, които винаги ще работят.
On-Demand percentage above base — процентното съотношение на обикновените и спотовите инстанси, 50-50 ще разпределя равномерно, 20-80 на всеки обикновен инстанс ще се повдигат 4 спотови. В рамките на този пример ще укажа 50-50, но в действителност най-често правим 20-80, в някои случаи 0-100.
Instance types — тук можете да посочите допълнителни типове инстанции, които ще се използват в клъстера. Никога не сме използвали, тъй като не разбирам много смисъла на тази история. Може би става въпрос за ограничения на конкретни типове инстанции, но те лесно се увеличават чрез поддръжка. Ако знаете приложение, ще се радвам да прочета в коментарите)
Мрежа — настройки на мрежата, избирате VPC и подсетове за машините, в повечето случаи е добре да изберете всички налични подсетове.
Натоварване на баланс — настройки на балансировчика, но ще направим това отделно, тук нищо не променяме. Health checks също ще бъдат настроени по-късно.
Group size — посочваме ограничения за броя на машините в клъстера и желаното количество машини при стартиране. Броят на машините в клъстера никога няма да стане по-малък от минимално посоченото и по-голям от максималното, дори ако според метриките трябва да се извърши скалиране.
Scaling policies — параметри за скалиране, но ще извършваме скалиране, като се основаваме на стартираните ECS задачи, затова ще настроим скалирането по-късно.
Instance scale-in protection — защита на инстанции от изтриване при скалиране надолу. Включваме, за да ASG не изтрие машината, на която има работещи задачи. Защитата за инстанции, на които няма задачи, ще бъде изключена от ECS Capacity Provider.
Add tags — можете да зададете тагове за инстанции (за това трябва да е отметната опцията Tag new instances). Препоръчвам да зададете таг Name, така всички инстанции, които се стартират в рамките на групата, ще имат еднакво име, което е удобно за наблюдение в консолата.
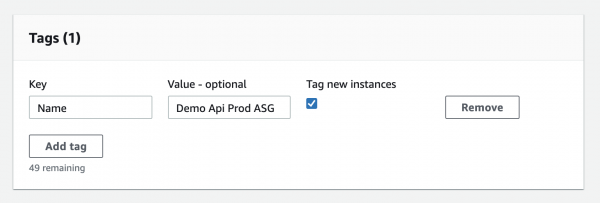
След създаването на групата отворете я и отидете в раздела Advanced configurations, защото на етапа на създаване в консолата не са видими всички опции.
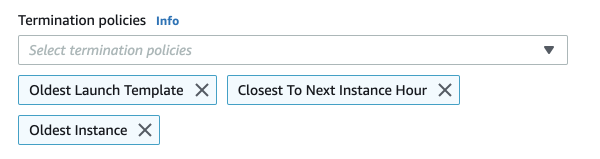
Termination policies — правила, които се взимат предвид при изтриването на инстанции. Те се прилагат по ред. Обикновено използваме такива, както е показано на изображението по-долу. Първо се изтриват инстанции с най-стария Launch Template (например, ако сме обновили AMI, е създадена нова версия, но всички инстанции са се обновили на нея). После се избират инстанции, които са най-близо до следващия изчислителен час по фактурирането. И накрая, се избират най-старите по дата на стартиране.
Полезно е да се знае: за обновление на всички машини в клъстера, удобно е да се използва . Ако съчетаете това с Lambda функцията от предишната стъпка, ще имате напълно автоматизирана система за обновяване на инстанциите. Преди да актуализирате всички машини, трябва да деактивирате защитата от мащабиране на инстанциите за всички инстанции в групата. Не настройката в групата, а именно защитата на самите машини, това се прави в таба Управление на инстанции.
Application Load Balancer и EC2 Target Group
Балансировчикът се създава в раздела EC2 → Load Balancing → Load Balancers. Ще използваме Application Load Balancer, можете да прочетете сравнение на различните типове балансировчици на .
Чувствителности — има смисъл да направите портове 80 и 443 и да настроите пренасочване от 80 на 443 с помощта на правила на балансировчика.
Availability Zones — в повечето случаи избираме всички зони на достъпност.
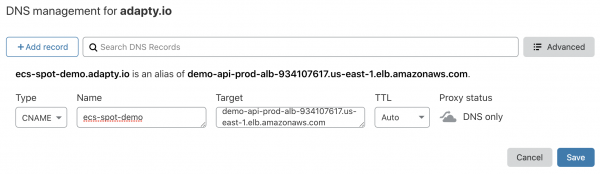
Конфигуриране на Настройки за Сигурност — тук се посочва SSL сертификатът за балансировчика, най-удобният вариант е да в ACM. Можете да прочетете за разликите в Политика за Сигурност можете да прочетете на , можете да оставите избраната по подразбиране ELBSecurityPolicy-2016-08. След създаването на балансировчика, ще видите неговия DNS име, за който трябва да настроите CNAME за вашия домейн. Например, така изглежда в Cloudflare.
Security Group — създаваме или избираме група за сигурност за балансировчика, подробности за това бях описал малко по-горе в раздела EC2 Launch Template → Настройки на мрежата.
Target group — създаваме група, която отговаря за маршрутизиране на заявките от балансировчика към машините и проверява тяхната наличност, за да ги замести в случай на проблеми. Тип на целта трябва да бъде Instance, Протокол и Порт всички, ако използвате HTTPS за комуникация между балансировчика и инстанциите, то на тях трябва да се зареди сертификат. В рамките на този пример няма да го правим, просто ще оставим порт 80.
Health checks — параметри за проверка на работоспособността на услугата. В настоящата услуга това трябва да бъде отделна заявка, която реализира важни части от бизнес логиката, в този пример ще оставя настройките по подразбиране. По-нататък можете да изберете интервал за заявки, таймаут, кодове на успешни отговори и др. В примера ни ще посочим кодове за успех 200-399, тъй като Docker образът, който ще се използва, връща код 304.
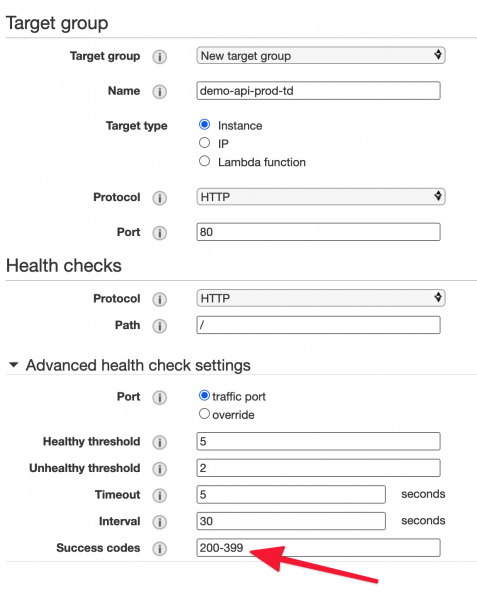
Регистрирайте Целите — тук се избират машините за групата, но в нашия случай това ще се извършва от ECS, така че просто пропускаме тази стъпка.
Полезно е да се знае: на ниво балансировчик можете да включите логовете, които ще се съхраняват в S3 на определено . От тях могат да се експортят в трети услуги за анализиране, или да се правят SQL заявки директно по данните в S3 с . Това е удобно и работи без допълнителен код. Също така препоръчвам да настроите изтриването на логовете от S3 кофата след изтичането на зададен период от време.
ECS Определение на задача
На предишните стъпки създадохме всичко, свързано с инфраструктурата на услугата, сега преминаваме към описанието на контейнерите, които ще стартираме. Това се прави в раздела ECS → Task Definitions.
Съвместимост на типа пускане — избираме EC2.
IAM роля за изпълнение на задачата — избираме ecsTaskExecutionRole. С нея се записват логовете, получава се достъп до секретни променливи и др.
В раздела Определения на контейнери натискаме Добави контейнер.
Снимка — линк към образа с кода на проекта, в рамките на този пример ще използвам публичен образ от Docker Hub .
Ограничения на паметта — ограничения на паметта за контейнера. Твърдо ограничение — твърдо ограничение, ако контейнерът надхвърли зададената стойност, ще бъде изпълнена командата docker kill, контейнерът веднага ще спре. Меко ограничение — меко ограничение, контейнерът може да надхвърли зададената стойност, но при разполагане на задачите на машините, този параметър ще бъде взет под внимание. Например, ако на машината има 4 GiB оперативна памет, а мекото ограничение на контейнера е 2048 MiB, то на тази машина могат да бъдат стартирани максимум 2 задачи с този контейнер. В действителност 4 GiB оперативна памет е малко по-малко от 4096 MiB, това може да се види на раздела ECS Instances в кластера. Мекото ограничение не може да бъде по-голямо от твърдото ограничение. Важно е да разберем, че ако в една задача има няколко контейнера, техните ограничения се сумират.
Съответствия на портовете — в Порт на хоста указваме 0, това означава, че портът ще бъде назначаван динамично, ще бъде следен от Target Group. Порт на контейнера — портът, на който работи вашето приложение, често се задава в командата за изпълнение или се определя в кода на вашето приложение, Dockerfile и т.н. За нашия пример използваме 3000, защото е указан в използвания образ.
Провера на здравето — параметри за проверка работоспособността на контейнера, не бъркайте с тези, които са настроени в Target Group.
Околна среда — настройки на околната среда. CPU единици — подобно Memory limits, но для процессора. Каждое ядро процессора — 1024 единицы, так что если на сервере двухъядерный процессор, а у контейнера установлено значение 512, то на одном сервере может быть запущено 4 задачи с этим контейнером. CPU units всегда соответствуют количеству ядер, их не может быть чуть меньше, как в случае с памятью.
Команда — команда для старта сервиса внутри контейнера, все параметры указываются через запятую. Это может быть gunicorn, npm и т. д. Если не указано, будет использовано значение директивы CMD из Dockerfile. Указываем npm,start.
Environment variables — переменные окружения контейнера. Это могут быть как простые текстовые данные, так и секретные переменные из или .
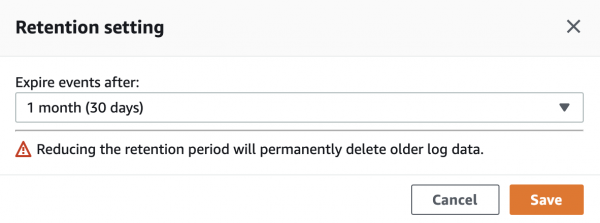
Storage and Logging — здесь мы настраиваем логирование в CloudWatch Logs (сервис для логов от AWS). Достаточно поставить галочку Auto-configure CloudWatch Logs. После создания Task Definition автоматически создастся группа логов в CloudWatch. По умолчанию логи хранятся бесконечно, рекомендую изменить Retention period с Never Expire на требуемый срок. Это делается в CloudWatch Log groups, нужно кликнуть на текущий период и выбрать новый.
ECS Cluster и ECS Capacity Provider
Переходим в раздел ECS → Clusters, чтобы создать кластер. В качестве шаблона выбираем EC2 Linux + Networking.
Cluster name — очень важно, здесь задаем такое же имя, как указано в Launch Template в параметре ECS_CLUSTER, в нашем случае — DemoApiClusterProd. Отмечаем галочку Create an empty cluster. Опционально можно включить Container Insights, чтобы контролировать метрики по сервисам в CloudWatch. Если все сделано правильно, то в разделе ECS Instances вы увидите машины, которые были созданы в Auto Scaling group.
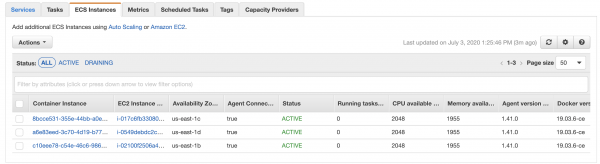
Преминаваме на таба Capacity Providers и создаем новый. Напоминаю, что он нужен для управления созданием и выключением машин в зависимости от количества работающих ECS задач. Важно отметить, что провайдер может быть привязан только к одной группе.
Auto Scaling group — выбираем созданную ранее группу.
Managed scaling — включаем, чтобы провайдер мог масштабировать сервис.
Target capacity % — какой процент загрузки машин задачами нам нужен. Если указать 100%, то все машины всегда будут заняты работающими задачами. Если указать 50%, то половина машин всегда останется свободной. В таком случае, если произойдет резкий скачок в нагрузке, новые задачи сразу попадут на свободные машины, без необходимости ждать развертывания инстансов.
Управляема защита от удаления — активираме, този параметър позволява на доставчика да премахне защитата на инстанциите от изтриване. Това се случва, когато на машината няма активни задачи и позволява Target capacity %.
ECS услуга и настройка на мащабируемост
Последна стъпка:) За да създадете услуга, трябва да отидете в създадения по-рано клъстер на таб Services.
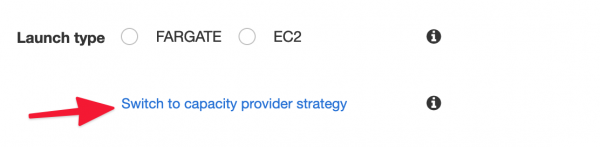
Тип на стартиране — необходимо е да щракнете върху Switch to capacity provider strategy и да изберете създадения по-рано доставчик.
Определение на задача — избираме създаденото по-рано Определение на задача и неговата версия.
Име на услугата — за да не се объркваме, винаги посочваме същото, каквото е Определението на задача.
Тип на услугата — винаги Replica.
Брой на задачите — желаното количество активни задачи в услугата. Този параметър се управлява от мащабирането, но все пак трябва да се посочи.
Минимален здрав процент и Максимален процент — определят поведението на задачите при внедряване. Стойностите по подразбиране 100 и 200 означават, че при внедряване броят на задачите ще нарасне многократно, а след това ще се върне към желаното. Ако имате работеща 1 задача, min=0, а max=100, тогава при внедряване тя ще бъде унищожена, а след това ще се стартира нова, тоест ще има престой. Ако работи 1 задача, min=50, max=150, тогава внедряването изобщо няма да се случи, тъй като 1 задача не може да се раздели на половина или да се увеличи наполовина.
Тип на внедряване — оставяме Rolling update.
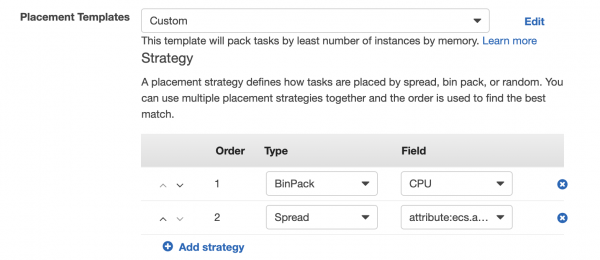
Шаблони за разположение — правила за разполагане на задачите на машините. По подразбиране е зададен AZ Balanced Spread — това означава, че всяка нова задача ще бъде разположена на нова инстанция, докато не се стартират машини во всички зони на достъпност. Ние обикновено правим BinPack — CPU и Spread — AZ, при такава политика задачите се разполагат максимално плътно на една машина по CPU. При необходимост от създаване на нова машина, тя се създава в нова зона на достъпност.
Тип на балансьор на натоварването — избираме Application Load Balancer.
IAM роля на услугата — избираме ecsServiceRole.
Име на балансьора на натоварването — избираме създадения по-рано балансировщик.
Период на гратис проверка за работоспособност — пауза преди извършването на проверките за работоспособност след внедряване на нова задача, обикновено поставяме 60 секунди.
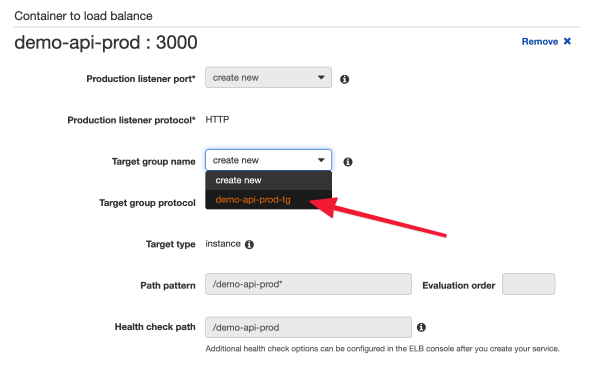
Контейнер за балансиране на натоварването — в пункта Име на целевата група избираме създадената по-рано група и всичко ще се попълни автоматично.
Автоматично мащабиране на услугата — параметри за мащабиране на услугата. Избираме Configure Service Auto Scaling to adjust your service’s desired count. Задаваме минимално и максимално количество задачи при мащабиране.
IAM роля за автоматично мащабиране на услугата — избираме AWSServiceRoleForApplicationAutoScaling_ECSService.
Автоматични политики за мащабиране на задачи — правила за мащабиране. Има 2 типа:
- Целево проследяване — проследяване на целева метрика (използване на CPU/RAM или брой заявки за всяка задача). Например, искаме средното натоварване на процесора да бъде 85%, когато то стане по-високо, нови задачи ще се добавят, докато не се достигне целевата стойност. Ако натоварването е по-ниско, задачите ще се премахват, освен ако не е включена защита срещу мащабиране надолу (Деактивирай мащабирането надолу).
- Стъпково мащабиране — реакция на произволно събитие. Тук можете да настроите реакцията на всяко събитие (CloudWatch Alarm), когато то се случи, можете да добавите или премахнете определен брой задачи, или да зададете точното количество задачи.
У услугата може да има няколко правила за мащабиране, което може да бъде полезно, важно е да се следи, за да не си противоречат.
Заключение
Ако сте следвали инструкциите и сте използвали същия Docker образ, вашата услуга трябва да връща такава страница.

- Създадохме шаблон, по който се стартират всички машини в услугата. Също така научихме как да актуализираме машините при промяна на шаблона.
- Настроихме обработката на сигнала за спиране на спотов инстанса, така че в рамките на минута след получаването му всички работещи задачи се премахват от машината, така че нищо не се губи и не се прекъсва.
- Създадохме балансировач, за да разпределим натоварването равномерно между машините.
- Създадохме услуга, която работи на спотови инстанси, благодарение на което разходите за машините намаляват с около 3 пъти.
- Настроихме автоматично мащабиране в двете посоки, за да обработваме увеличения на натоварванията, но в същото време да не плащаме за простои.
- Използваме Capacity Provider, за да приложението да управлява инфраструктурата (машините), а не обратно.
- Ние сме страхотни.
Ако имате предсказуеми връхни натоварвания, например когато рекламирате в голяма имейл разпращачка, можете да настроите мащабиране по .
Може също така да правите мащабиране на основа данни от различни части на вашата система. Например, имаме функционалност за на потребителите на мобилното приложение. Понякога кампанията се разпраща на повече от 1М души. След такова разпращане винаги се наблюдава значителен ръст на заявките към API, тъй като много потребители наведнъж влизат в приложението. Така че, ако видим, че в опашката за изпращане на промо пугове е значително повече от стандартните показатели, веднага можем да стартираме няколко допълнителни машини и задачи, за да бъдем готови за натоварването.
Ще се радвам, ако в коментарите споделите интересни случаи на използване на спотовите инстанции и ECS или нещо свързано с мащабирането.
Скоро ще има статии за това как обработваме хиляди аналитични събития в секунда в предимно serverless стек (с пари) и как е организиран деплой на услуги с помощта на GitLab CI и Terraform Cloud.
Абонирайте се за нас, ще бъде интересно!
Само регистрирани потребители могат да участват в анкетата. , моля.
Използвате ли спотови инстанции в продукция?
22,2%Да6
66,7%Не18
11,1%Научих за тях от статия, планирам да ги използвам.
Гласуваха 27 потребители. 5 потребители се въздържаха.
Източник: habr.com
