

Преди известно време пред нас възникна въпросът за избор на ETL инструмент за работа с BigData. Предишното решение Informatica BDM не ни удовлетворяваше поради ограничената функционалност. Неговото използване се състоеше само в рамката за стартиране на команди spark-submit. На пазара нямаше много сходни решения, способни да работят с обема данни, с който се сблъскваме всеки ден. В крайна сметка избрахме Ab Initio. В хода на пилотни демонстрации продуктът показа много висока скорост на обработка на данни. Информация за Ab Initio на български език почти няма, затова решихме да споделим нашия опит в Хабра.
Ab Initio разполага с множество класически и необичайни трансформации, кодът на които може да бъде разширен с помощта на собствения език PDL. За малкия бизнес този мощен инструмент вероятно ще бъде излишен, и повечето от неговите възможности могат да се окажат скъпи и ненужни. Но ако масштабът ви е близък до този на Сбер, тогава Ab Initio може да бъде интересен за вас.
Той помага на бизнеса глобално да натрупва знания и развива екосистемата, а на разработчика — да подобрява своите умения в ETL, да усвоява знания в shell, предоставя възможност за изучаване на езика PDL, дава визуална картина на процесите на зареждане, улеснява разработката благодарение на изобилието от функционални компоненти.
В поста ще разкажа за възможностите на Ab Initio и ще представя сравнителни характеристики по неговата работа с Hive и GreenPlum.
- Описание на фреймворка MDW и работата по неговата адаптация за GreenPlum.
- Сравнителни характеристики на производителността на Ab Initio при работа с Hive и GreenPlum.
- Работа на Ab Initio с GreenPlum в режим Near Real Time.
Функционалността на този продукт е много широка и изисква значително време за изучаване. Въпреки това, при достатъчни умения и правилни настройки на производителността, резултатите от обработка на данни се оказват доста впечатляващи. Използването на Ab Initio за разработчика може да му предостави интересен опит. Това е нов поглед върху ETL разработката, хибрид между визуална среда и разработка на зареждания на скриптоподобен език.
Бизнесът развива своите екосистеми и този инструмент се оказва изключително полезен. С помощта на Ab Initio е възможно да се натрупа знание за текущия бизнес и да се използва това знание за разширяване на старите и откриване на нови бизнеси. Алтернативи на Ab Initio са визуалните среди за разработка Informatica BDM и невизуалните среди – Apache Spark.
Описание на Ab Initio
Ab Initio, подобно на другите ETL инструменти, представлява набор от продукти.
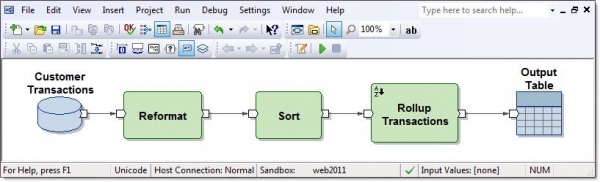
Ab Initio GDE (Графична среда за разработка) е среда за разработчик, в която той конфигурира трансформации на данни и ги свързва с потоци данни, представени чрез стрелки. Този набор от трансформации се нарича граф:
Входните и изходните свързвания на функционалните компоненти са портове и съдържат полета, изчислени вътре в трансформациите. Няколко графа, свързани чрез потоци в реда на тяхното изпълнение, се наричат план.
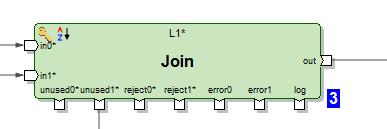
Има няколко стотин функционални компоненти, което е много. Много от тях са узкоспециализирани. Възможностите на класическите трансформации в Ab Initio са по-широки в сравнение с други ETL инструменти. Например, Join има няколко изхода. Освен резултата от съединението на набори от данни, може да се получат записи от входните набори от данни, по ключовете на които не е успяло съединение. Освен това, могат да се получат rejects, errors и лог на работата на трансформацията, който може да се прочете в същия граф като текстов файл и да се обработи с други трансформации:
Или, например, е възможно да се материализира приемник на данни под формата на таблица и в същия граф да се извлекат данни от него.
Има оригинални трансформации. Например, трансформацията Scan има функционалност, подобна на аналитичните функции. Има трансформации с говорещи имена: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB и др. Графовете могат да използват параметри на изпълнението, включително е възможна предаването на параметри от операционната система или към операционната система. Файловете с готов набор от предаваеми на графа параметри се наричат parameter sets (psets).
Както е наложено, Ab Initio GDE разполага с репозиторий, наречен EME (Enterprise Meta Environment). Разработчиците имат възможността да работят с локални версии на кода и да правят check in на своите разработки в централния репозиторий.
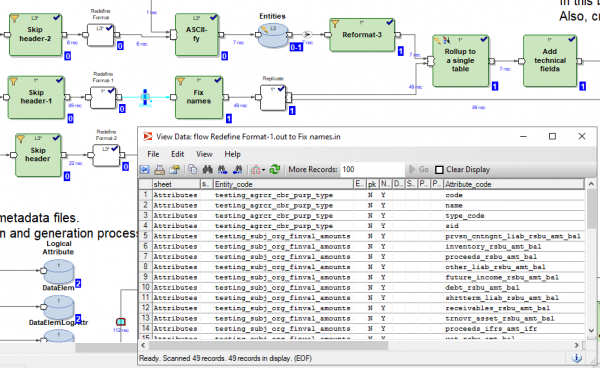
По време на изпълнение или след него имате възможност да кликнете върху всяка връзка на трансформационния поток и да видите данните, преминали между тези трансформации:
Също така можете да кликнете върху който и да е поток и да видите детайли за проследяването – в колко паралела е работила трансформацията, колко реда и байтове са се заредили в който от паралелите:
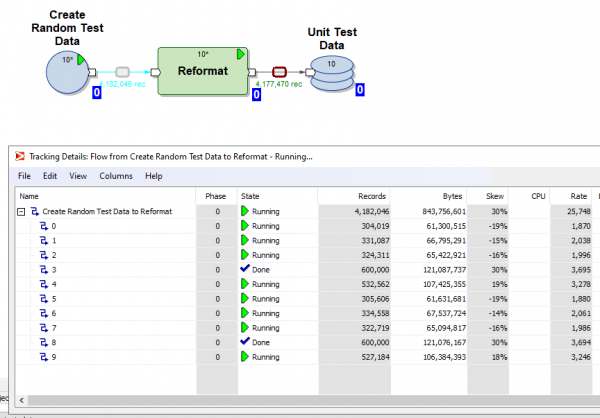
Има възможност да разделите изпълнението на графа на фази и да маркирате, че определени трансформации трябва да се изпълняват първо (в нулевата фаза), след това в първата фаза, следващите във втората фаза и т.н.
За всяка трансформация можете да изберете така нареченото оформление (къде ще се изпълнява): без паралели или в паралелни потоци, броят на които можете да зададете. Временните файлове, които Ab Initio създава при работа с трансформации, могат да се разполагат както в файловата система сървър, така и в HDFS.
Всяка трансформация на базата на шаблона по подразбиране може да създаде свой собствен скрипт на PDL, който малко напомня на shell.
С помощта на езика PDL можете да разширите функционалността на трансформациите и, в частност, можете динамично (по време на изпълнението) да генерирате произволни фрагменти код в зависимост от параметрите на изпълнението.
Също така в Ab Initio е добре развита интеграцията с ОС чрез shell. В конкретния случай в Сбербанк се използва Linux ksh. Можете да обменяте променливи с shell и да ги използвате като параметри на графите. Можете да извикате изпълнението на графите Ab Initio от shell и да администрирате Ab Initio.
В допълнение към Ab Initio GDE, доставката включва много други продукти. Има собствена система Co>Operation, която претендира да бъде операционна система. Има Control>Center, в който можете да задавате графици и да наблюдавате потоците на зареждане. Има продукти за разработка на по-примитивно ниво, отколкото позволява Ab Initio GDE.
Описание на фреймворка MDW и работата по неговата адаптация за GreenPlum.
Заедно със своите продукти, доставчикът предлага продукта MDW (Metadata Driven Warehouse), който представлява конфигуратор на графи, предназначен да помага в типични задачи по запълване на хранилища за данни или data vaults.
Той съдържа потребителски (проекти специфични) парсери на метадани и готови генератори на код “из коробки.”
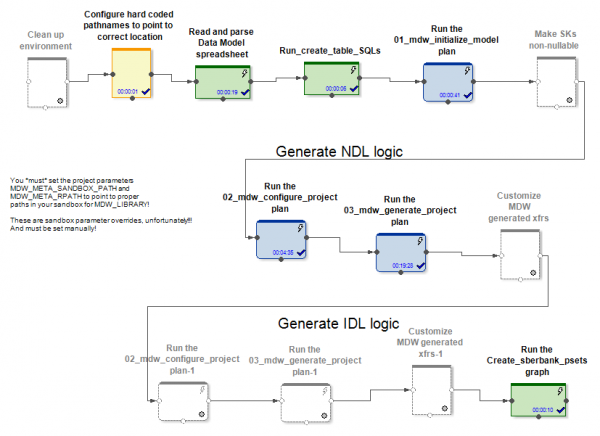
На входа MDW получава данни от модел, конфигурационен файл за настройка на връзката с базата данни (Oracle, Teradata или Hive) и някои други настройки. Частта, специфична за проекта, например, разгръща модела в базата данни. Стандартната част на продукта генерира графи и конфигурационни файлове за тях при зареждане на данни в таблиците на модела. При това се създават графи (и psets) за няколко режима на инициализираща и инкрементална работа по обновяване на обектите.
В случаите с Hive и RDBMS се генерират различаващи се графи за инициализиращо и инкрементално обновление на данните.
В случай на Hive, постъпилите данни от делтата се комбинират чрез Ab Initio Join с данните, които са били в таблицата преди обновлението. Зареждачите на данни в MDW (както в Hive, така и в RDBMS) не само вмъкват нови данни от делтата, но и затварят периодите на валидност на данните, по първоначалните ключове, по които е постъпила делтата. Освен това, е необходимо да се пренапише отново неизменената част от данните. Но така трябва да се прави, тъй като в Hive няма операции delete или update.
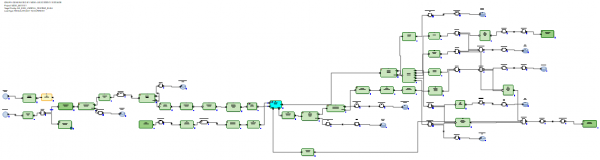
В случая с RDBMS графите за инкрементално обновление на данните изглеждат по-оптимално, тъй като RDBMS имат реални възможности за обновление.
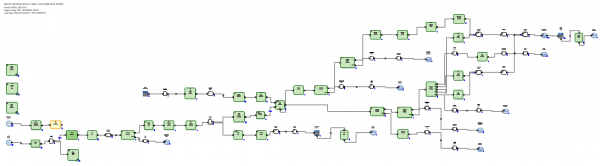
Постъпилата делта се качва в междинна таблица в базата данни. След това настъпва свързване на делтата с данните, които са били в таблицата преди обновлението. И това се прави с помощта на SQL посредством генериран SQL-запрос. След това с помощта на SQL команди delete+insert в целевата таблица се извършва вмъкване на нови данни от делтата и затваряне на периодите на валидност на данните, по първоначалните ключове, по които е постъпила делтата.
Неизменените данни няма нужда да се пренаписват.
Така стигнахме до извода, че в случая с Hive MDW трябва да избере да пренапише цялата таблица, тъй като Hive няма функция за обновление. И нищо по-добро от пълно пренаписване на данни при обновление не е измислено. Във случая с RDBMS, напротив, създателите на продукта са преценили, че е необходимо да се остави свързването и обновлението на таблиците на използването на SQL.
За проекта в Сбербанке създадохме нова многократно използваема реализация на загрузчика за база данни за GreenPlum. Това беше направено на базата на версия, която MDW генерира за Teradata. Именно Teradata, а не Oracle, се оказа по-подходяща, тъй като също е MPP-система. Начините на работа, както и синтаксисът на Teradata и GreenPlum, се оказаха сходни.
Примери за критични разлики за MDW между различните RDBMS са следните. В GreenPlum, за разлика от Teradata, при създаване на таблици е необходимо да се пише клаузата
разпределено отВ Teradata пишат
delete <table> all, а в GreenPlum пишат
изтрий от <table>В Oracle с цел оптимизация пишат
изтриване от t където rowid в (<свързване t с дельтата>), а в Teradata и GreenPlum пишат
изтриване от t където съществува (изберете * от delta където delta.pk=t.pk)Също така ще отбележим, че за работа с Ab Initio в GreenPlum беше необходимо да се инсталира клиентът GreenPlum на всички нодове на клъстера Ab Initio. Това е защото се свързахме с GreenPlum едновременно от всички възли на нашия клъстер. А за да бъде четенето от GreenPlum паралелно и всеки паралелен поток на Ab Initio да чете своята порция данни от GreenPlum, се наложи в секцията „къде“ на SQL заявките да се постави конструкция, разбирана от Ab Initio
къде ABLOCAL()и да се определи стойността на тази конструкция, указвайки на трансформацията, която чете от базата данни параметъра
ablocal_expr=„string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))“, която се компилира в нещо като
mod(sk,10)=3, т.е. трябва да указваме на GreenPlum явен филтър за всяка партиция. За други бази данни (Teradata, Oracle) Ab Initio може да извърши това распаралеляване автоматично.
Сравнителни характеристики на производителността на Ab Initio при работа с Hive и GreenPlum.
В Сбербанка беше проведен експеримент за сравнение на производителността на сгенерираните графи на MDW относно Hive и GreenPlum. В рамките на експеримента в случая с Hive имаше 5 нода на същия клъстер, както и Ab Initio, а в случая с GreenPlum имаше 4 ноди на отделен клъстер. Т.е. Hive имаше известно предимство пред GreenPlum „по оборудване“.
Бяха разгледани две двойки графи, изпълняващи същата задача за обновяване на данни в Hive и GreenPlum. При това стартираха графи, генерирани от конфигурирания MDW:
- инициализираща зареждане + инкрементално зареждане на случайно генерирани данни в таблица Hive
- инициализираща зареждане + инкрементално зареждане на случайно генерирани данни в същата таблица на GreenPlum
В двата случая (Hive и GreenPlum) стартирахме зареждане в 10 паралелни потока на един и същ кластер Ab Initio. Междинните данни за изчисленията Ab Initio запазваше в HDFS (в термини на Ab Initio беше използван MFS layout using HDFS). Една ред случайно генерирани данни заема в двата случая по 200 байта.
Резултатът е следният:
Hive:
Инициализиращо зареждане в Hive
Въведени редове
6 000 000
60 000 000
600 000 000
Продължителност на инициализиращото
зареждане в секунди
41
203
1 601
Инкрементално зареждане в Hive
Брой редове, налични в
целевата таблица в началото на експеримента
6 000 000
60 000 000
600 000 000
Брой редове на делтата, приложени към
целевата таблица по време на експеримента
6 000 000
6 000 000
6 000 000
Продължителност на инкременталното
зареждане в секунди
88
299
2 541
GreenPlum:
Инициализиращо зареждане в GreenPlum
Въведени редове
6 000 000
60 000 000
600 000 000
Продължителност на инициализиращото
зареждане в секунди
72
360
3 631
Инкрементално зареждане в GreenPlum
Брой редове, налични в
целевата таблица в началото на експеримента
6 000 000
60 000 000
600 000 000
Брой редове на делтата, приложени към
целевата таблица по време на експеримента
6 000 000
6 000 000
6 000 000
Продължителност на инкременталното
зареждане в секунди
159
199
321
Виждаме, че скоростта на инициализиращото зареждане както в Hive, така и в GreenPlum линейно зависи от обема на данните и поради по-добър хардуер е малко по-бързо за Hive, отколкото за GreenPlum.
Инкременталното зареждане в Hive също линейно зависи от обема на наличните в целевата таблица преди заредени данни и преминава доста бавно с увеличаването на обема. Това е причинено от необходимостта да се презапише целевата таблица напълно. Това означава, че прилагането на малки изменения към огромни таблици – не е много добра опция за работа с Hive.
Инкременталното зареждане в GreenPlum слабо зависи от обема на наличните в целевата таблица преди данни и преминава доста бързо. Това се дължи на SQL Joins и архитектурата на GreenPlum, която допуска операция delete.
И така, GreenPlum внася делтата чрез метод delete+insert, а в Hive няма операции delete или update, така че целият масив от данни при инкрементално обновление е принуден да се презапише изцяло. Най-впечатляващо е сравнението на выделените с дебел шрифт клетки, тъй като то отговаря на най-честия вариант на ресурсно интензивни зареждания. Виждаме, че GreenPlum спечели от Hive в този тест с 8 пъти.
Работа на Ab Initio с GreenPlum в режим Near Real Time.
В този експеримент ще проверим възможността на Ab Initio да извършва обновление на таблицата GreenPlum с произволно генерирани порции данни в режим, близък до реалното време. Ще разгледаме таблицата GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, с която ще се работи.
Ще използваме три графа Ab Initio за работа с нея:
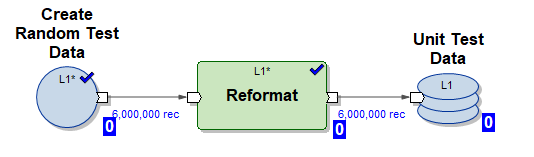
1) Граф Create_test_data.mp – създава 10 паралелни потока с файлове с данни в HDFS, съдържащи 6 000 000 реда. Данните са случайни, структурата им е организирана за вмъкване в нашата таблица.
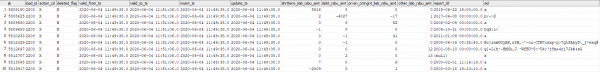
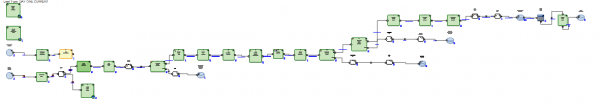
2) Граф mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – генериран MDW граф за инициализираща инсталация на данни в нашата таблица в 10 паралелни потока (използват се тестови данни, генерирани от графа (1)).
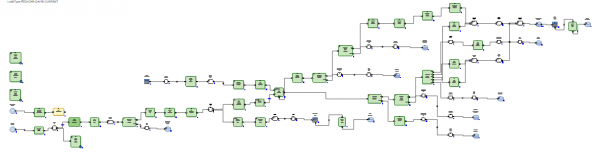
3) Граф mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – генериран MDW граф за инкрементално обновление на нашата таблица в 10 паралелни потока, използвайки порция свежи данни (делти), генерирани от графа (1).
Ще изпълним долупосочения сценарий в режим NRT:
- генерирайте 6 000 000 тестови реда
- извършете инициализираща зареждане, вмъквайки 6 000 000 тестови реда в празна таблица
- повторете инкременталното зареждане 5 пъти
- генерирайте 6 000 000 тестови реда
- извършете инкрементално вмъкване на 6 000 000 тестови реда в таблицата (като на старите данни се задава време на изтичане valid_to_ts и се вмъкват по-нови данни с същия първичен ключ).
Този сценарий еймулира режима на реална работа на бизнес система – в режим на реално време се появява значително количество нови данни и веднага се интегрира в GreenPlum.
Сега да разгледаме логовете на работата на сценария:
Започнете Create_test_data.input.pset в 2020-06-04 11:49:11
Завършете Create_test_data.input.pset в 2020-06-04 11:49:37
Започнете mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:49:37
Завършете mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:50:42
Започнете Create_test_data.input.pset в 2020-06-04 11:50:42
Завършете Create_test_data.input.pset в 2020-06-04 11:51:06
Започнете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:51:06
Завършете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:53:41
Започнете Create_test_data.input.pset в 2020-06-04 11:53:41
Завършете Create_test_data.input.pset в 2020-06-04 11:54:04
Започнете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:54:04
Завършете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:56:51
Започнете Create_test_data.input.pset в 2020-06-04 11:56:51
Завършете Create_test_data.input.pset в 2020-06-04 11:57:14
Започнете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:57:14
Завършете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 11:59:55
Започнете Create_test_data.input.pset в 2020-06-04 11:59:55
Завършете Create_test_data.input.pset в 2020-06-04 12:00:23
Започнете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 12:00:23
Завършете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset в 2020-06-04 12:03:23
Започнете Create_test_data.input.pset в 2020-06-04 12:03:23
Завършете Create_test_data.input.pset в 2020-06-04 12:03:49
Започнете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset на 2020-06-04 12:03:49
Завършете mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset на 2020-06-04 12:06:46
Получава се следната картина:
Графика
Начално време
Крайно време
Дължина
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Виждаме, че 6 000 000 реда инкрементално се обработват за 3 минути, което е доста бързо.
Данните в целевата таблица са разпределени по следния начин:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 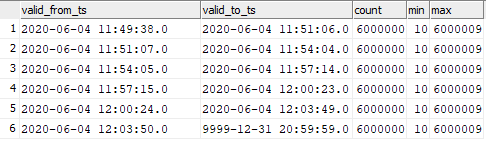
Можем да различим съответствието на въведените данни с моментите на стартиране на графите.
Значи, можем да стартираме инкременталното зареждане на данни в GreenPlum с много висока честота и да наблюдаваме висока скорост на вмъкване на тези данни в GreenPlum. Разбира се, не може да се стартира веднъж в секунда, тъй като Ab Initio, както и всяко ETL средство, изисква време за 'разгъване' при стартиране.
Заключение
Сега Ab Initio се използва в Сбербанк за изграждане на Единен семантичен слой данни (ЕСС). Този проект предполага изграждане на единна версия на състоянието на различни банкови бизнес същности. Информацията идва от различни източници, чиито реплики се подготвят на Hadoop. Въз основа на нуждите на бизнеса се подготвя модел на данни и се описват трансформации на данни. Ab Initio зарежда информацията в ЕСС, а заредените данни не само представляват интерес за бизнеса сами по себе си, но и служат като източник за изграждане на витрини на данни. При това функционалността на продукта позволява да се използват различни системи (Hive, Greenplum, Teradata, Oracle) като приемници, което дава възможност без особени усилия да се подготвят данни за бизнеса в различни изисквани формати.
Възможностите на Ab Initio са широки, например, приложимият фреймуърк MDW дава възможност да се изграждат техническа и бизнес историчност на данните 'из коробка'. За разработчиците Ab Initio предлага възможност 'да не изобретяват колелото', а да се ползват от множеството налични функционални компоненти, които по същество представляват библиотеки, нужни при работа с данни.
Авторът е експерт в професионалната общност на Сбербанк SberProfi DWH/BigData. Професионалната общност SberProfi DWH/BigData отговаря за развитието на компетенциите в области като екосистемата Hadoop, Teradata, Oracle DB, GreenPlum, както и BI инструменти Qlik, SAP BO, Tableau и др.
Източник: habr.com
